Skew et spill
L'asymétrie et le spill sont deux des raisons les plus courantes pour lesquelles une seule étape prend beaucoup plus de temps que prévu. Les deux apparaissent sur la page d’étape, avec les correctifs à essayer pour chacun.
Utilisez cette page après avoir ouvert la page de staging de l'étape la plus longue d'un job. Pour trouver cette étape, consultez Diagnostiquer un job long dans Spark. Si l’étape ne comporte qu’une seule tâche, consultez plutôt Étape Spark longue avec une seule tâche.
spill
Le spill se produit lorsque Spark manque de mémoire d'exécution, que Spark utilise pour les shuffles, les jointures, les tris et les agrégations. Spark écrit ensuite les données de la mémoire sur le disque, ce qui peut être coûteux. Le spill est très fréquent lors du shuffle des données.
Vérifiez d’abord si l’étape présente un spill. Les détails de l’étape en haut de la page de l’étape montrent les statistiques de spill lorsque l’étape présente un spill :
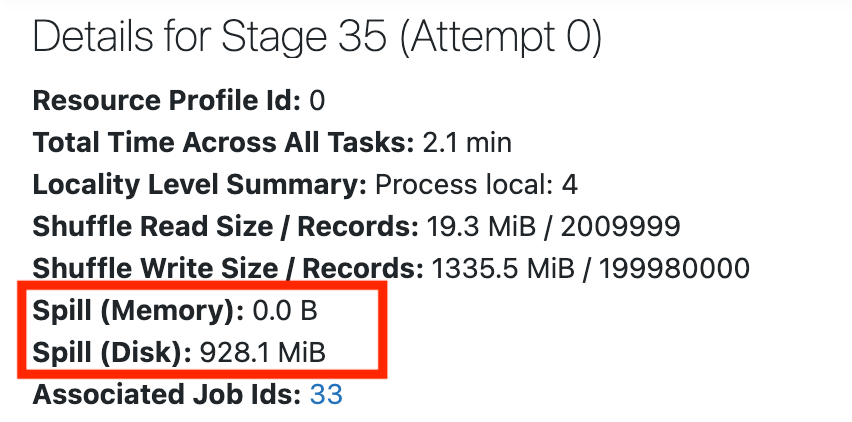
Les détails de l’étape incluent également d’autres métriques, telles que la mémoire d’exécution maximale. Pour plus de détails sur ces métriques d’étape et d’autres, consultez Détail de l’étape dans la documentation Apache Spark.
Si aucune statistique de spill ne s'affiche, l'étape n'a pas de spill. Si l'étape présente un spill, essayez les approches suivantes :
- Utilisez l'option d'optimisation automatique des échanges (shuffle). Définissez
spark.sql.shuffle.partitions=autode façon à ce que Spark sélectionne le nombre de partitions aléatoires en fonction du plan de query et de la taille des données d'entrée. Voir la configuration AQE. - Réduire les données conservées en mémoire. Réduisez le nombre de lignes ou de colonnes traitées par la query, ou la taille des colonnes volumineuses comme les chaînes, les tableaux, les mappages et les structs. Voir SPILL_DE_DONNÉES.
- Augmentez la mémoire de l’exécuteur. La mémoire totale de l'exécuteur détermine la quantité de données pouvant être contenues dans la mémoire avant que Spark ne les spill sur le disque. Utilisez des instances avec plus de mémoire. Pour les ETL par batch complexes avec des jointures sur plusieurs tables, utilisez un nombre réduit de Worker plus grands afin de réduire la quantité de données déplacées (shuffle). Consultez ETL par batch complexe.
- Limitez la taille du batch de streaming. Si l’étape fait partie d’une query Structured Streaming, limitez le taux d’entrée afin que les micro-batches de grande taille ne provoquent pas de spill. Consultez Configurer la taille de batch Structured Streaming sur Databricks.
Asymétrie
Le skew se produit lorsqu'une ou plusieurs tâches prennent beaucoup plus de temps que les autres. Les autres cœurs restent inactifs pendant que ces tâches se terminent, ce qui entraîne une mauvaise utilisation du cluster et des jobs plus longs.
Pour vérifier l’asymétrie, faites défiler jusqu’aux métriques de synthèse . Comparez la durée maximale à la durée du 75e percentile. La capture d’écran suivante montre une étape saine, où le 75e percentile et le Max sont les mêmes :
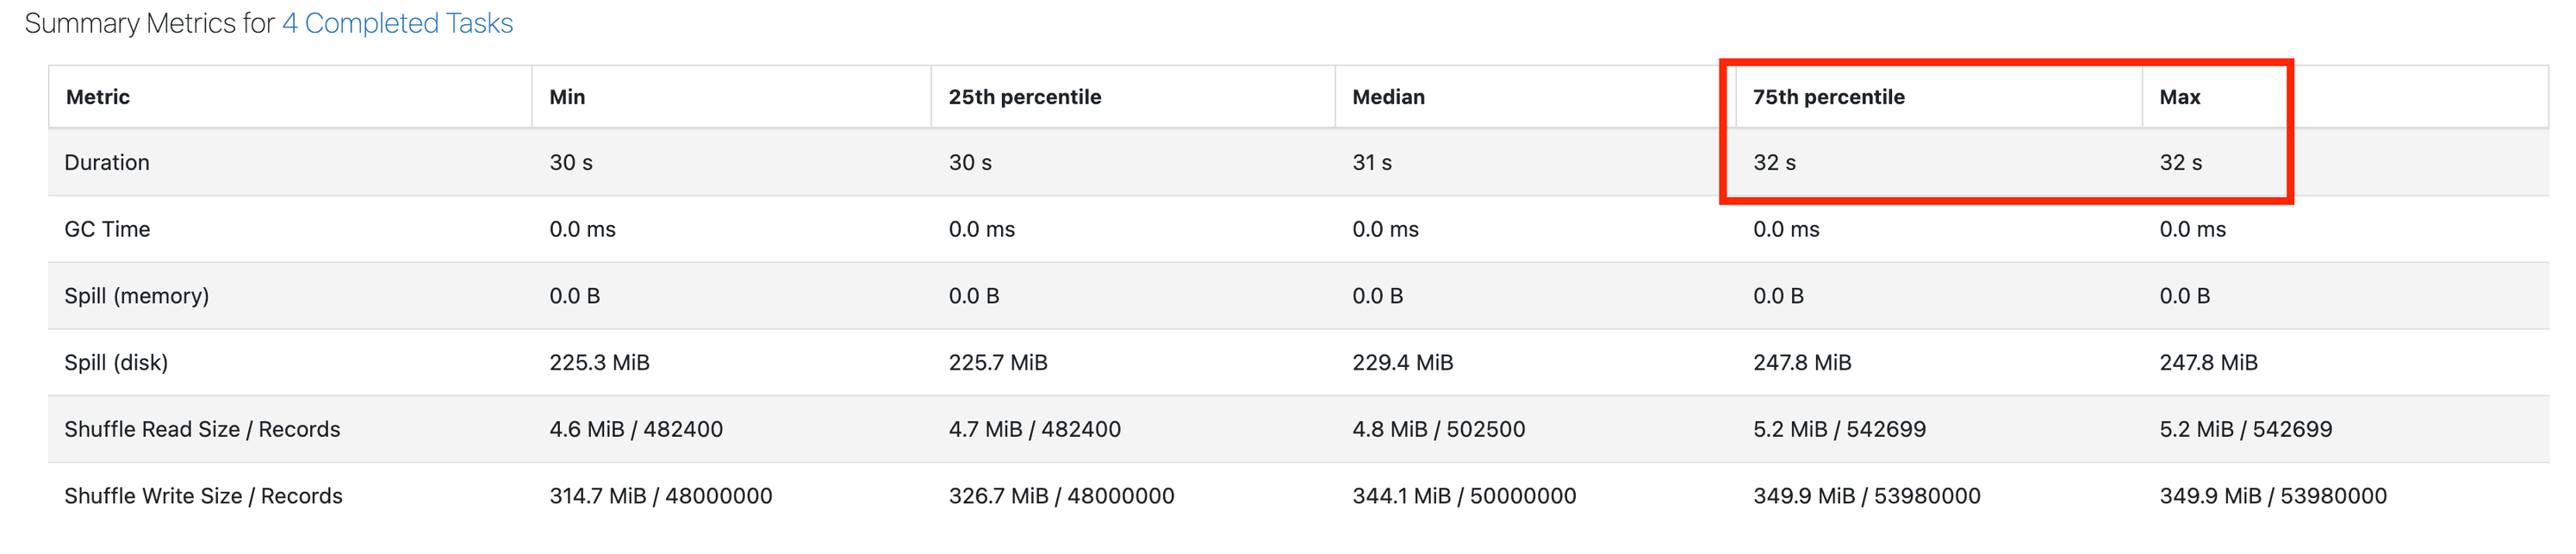
Si la durée maximale dépasse le 75e percentile de 50 % ou plus, l'étape peut présenter une asymétrie. Pour corriger l'asymétrie, essayez les approches suivantes :
- Vérifiez si l'AQE gère l'asymétrie. Si l'étape asymétrique fait partie d'une sort Merge join ou d'une jointure de hachage de mélange, l'exécution adaptative de query (AQE) divise automatiquement les partitions asymétriques, mais seulement lorsqu'une partition dépasse ses deux threshold de taille. Les jointures de diffusion (broadcast joins) ne sont jamais optimisées en cas d'asymétrie, et le type de jointure détermine quel côté AQE peut optimiser. Voir Pourquoi AQE n'a pas détecté mon asymétrie de données ?.
- Ajustez les thresholds d’asymétrie AQE. Si les partitions asymétriques sont plus petites que les threshold, ajustez
spark.sql.adaptive.skewJoin.skewedPartitionFactoretspark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes. Voir Gérer dynamiquement l'asymétrie de jointure. - Ajoutez du « sel » aux clés asymétriques ou pré-agrégez. Si quelques valeurs de clé contiennent la majeure partie des données dans une jointure ou une agrégation, ajoutez un suffixe de bucket aléatoire aux clés asymétriques, puis regroupez et agrégez en deux étapes. Voir Gérer l’asymétrie des données.
- Effectuez des clusters de la table source. Si le décalage provient de la disposition d'une table stockée, utilisez le clustering liquide, qui est adapté aux tables présentant un fort décalage de données. Voir Utiliser le clustering liquide pour les tables.
- Rééquilibrez les partitions de sortie. Si l'étape asymétrique écrit une table, utilisez l'indice
REBALANCE. Spark divise les partitions de sortie asymétriques afin qu'aucune partition ne soit trop volumineuse. Spark ignore l'indice si AQE n'est pas activé. Consultez Indices de partitionnement.
Aucun décalage ni spill
Si l'étape ne présente ni inclinaison ni spill, vérifiez si elle est limitée par les E/S. Pour revenir à la page du job, faites défiler jusqu’en haut de la page de l’étape et cliquez sur IDs de job associés :

Puis voir Élevé d'E/S de stage Spark.