Étape Spark lente avec peu d'E/S
Si une étape s'exécute lentement mais lit, écrit et mélange peu de données, la query elle-même est généralement le goulot d'étranglement.
Utilisez cette page après avoir écarté le biais et le spill et les E/S élevées dans l’étape la plus longue. Si l'étape ne comporte qu'une seule tâche, voir Longue étape Spark avec une seule tâche.
Une étape lente avec peu d'E/S peut avoir les causes suivantes :
- Lecture de nombreux petits fichiers
- Écrire beaucoup de petits fichiers
- UDF lentes
- Jointure cartésienne
- Jointure par explosion ou explosion
Utilisez le DAG de SQL pour identifier la quasi-totalité de ces problèmes.
Ouvrir le DAG SQL
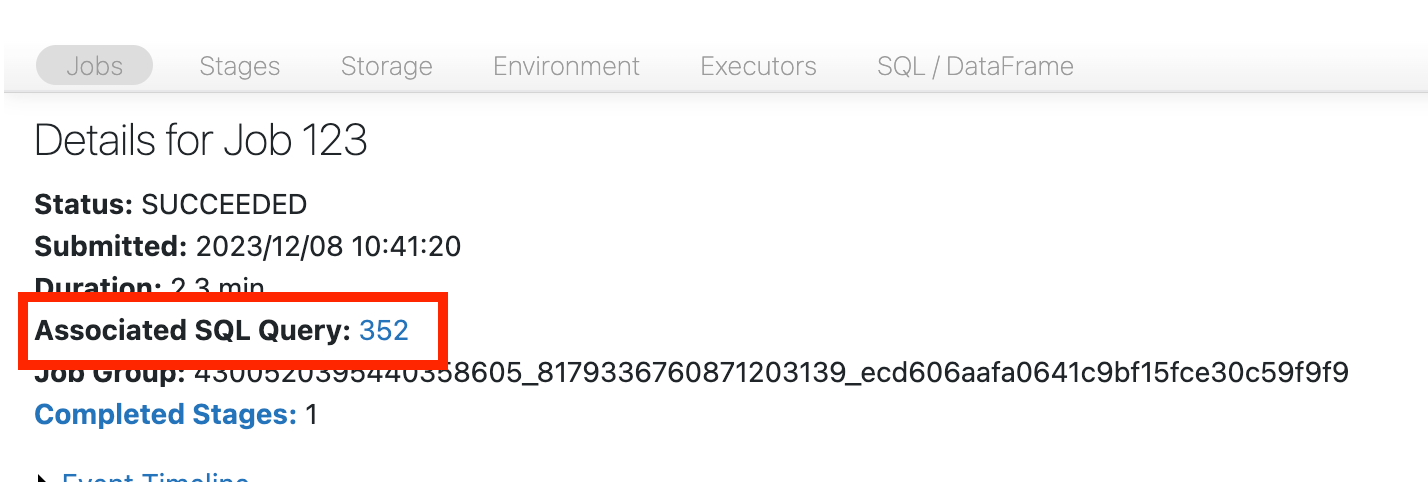
Pour ouvrir le DAG SQL, faites défiler jusqu'en haut de la page du job et cliquez sur query SQL associée :
Le DAG apparaît. Si ce n'est pas le cas, faites défiler vers le bas pour le trouver :
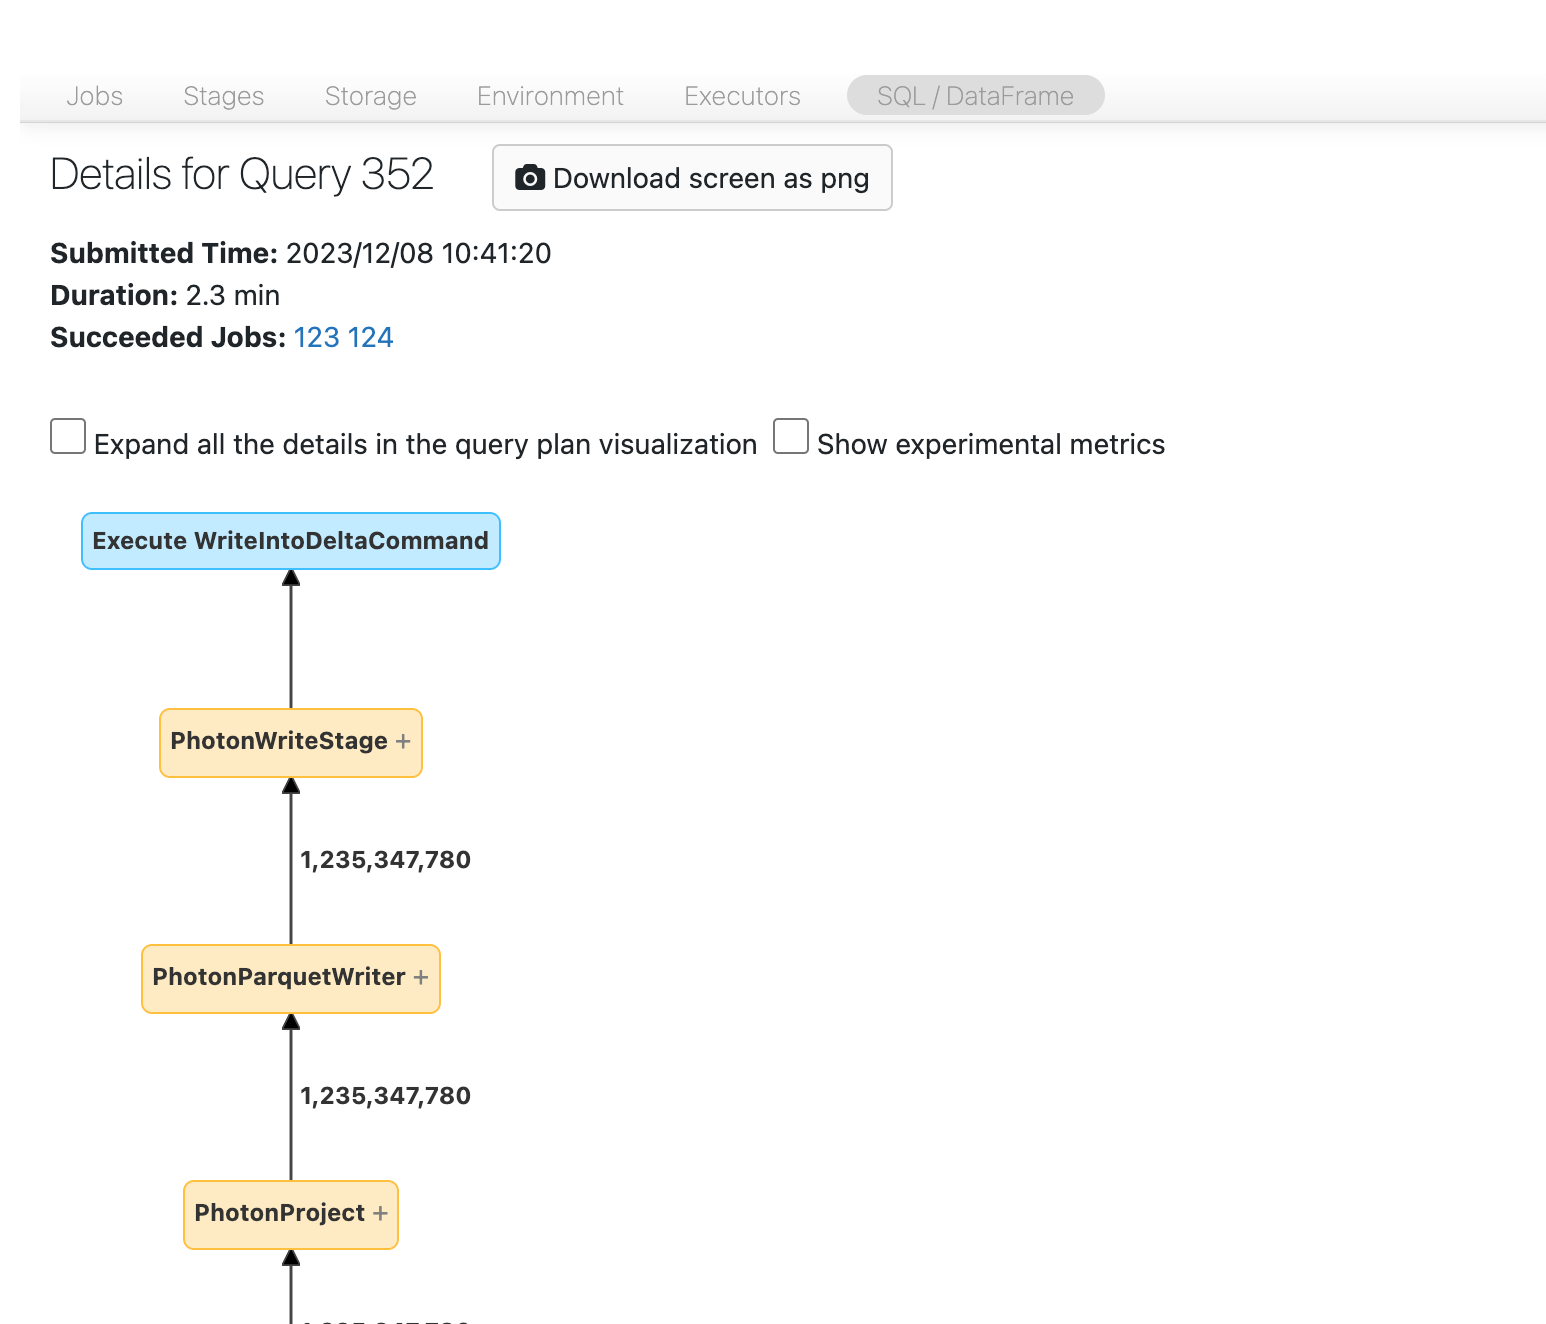
Étudiez le DAG pour identifier où le temps est passé. Certains nœuds indiquent directement leur durée. Par exemple, ce nœud affiche une durée de 2,1 minutes et inclut l'ID d'étape :

Les autres nœuds n'afficheront leur durée que lorsque vous cliquez dessus. Dans cet exemple, la durée du nœud d'écriture est de 1,4 minute :
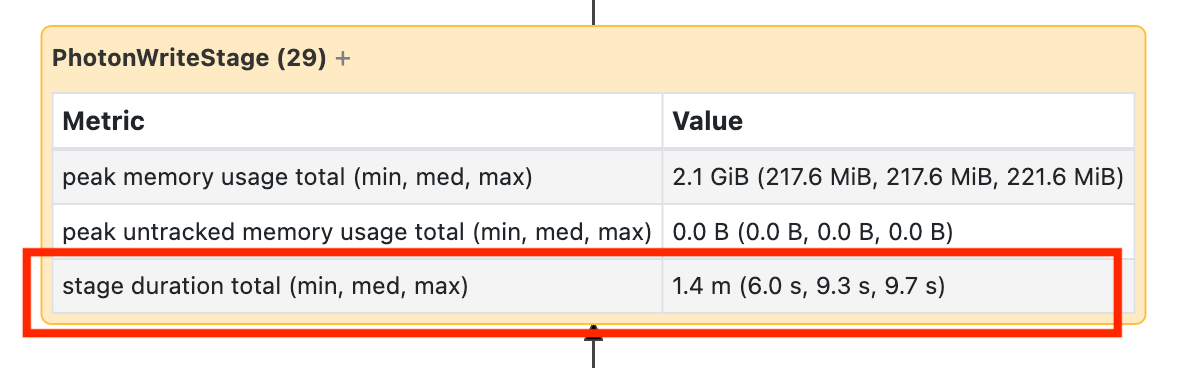
Ces durées sont cumulatives et représentent la somme des temps d'exécution sur toutes les tâches, et non la durée prévue écoulée. Ils sont corrélés avec le temps écoulé et le coût.
Cliquez sur un opérateur pour afficher des métriques telles que les lignes de sortie, la mémoire maximale et la taille du spill. Pour obtenir des définitions des mesures d'opérateur rapportées par Spark, reportez-vous aux mesures SQL dans la documentation de l’interface utilisateur Web d’Apache Spark.
Lecture de nombreux petits fichiers
Si un opérateur de scan consomme la majeure partie du temps, cliquez dessus et vérifiez le nombre de fichiers lus :
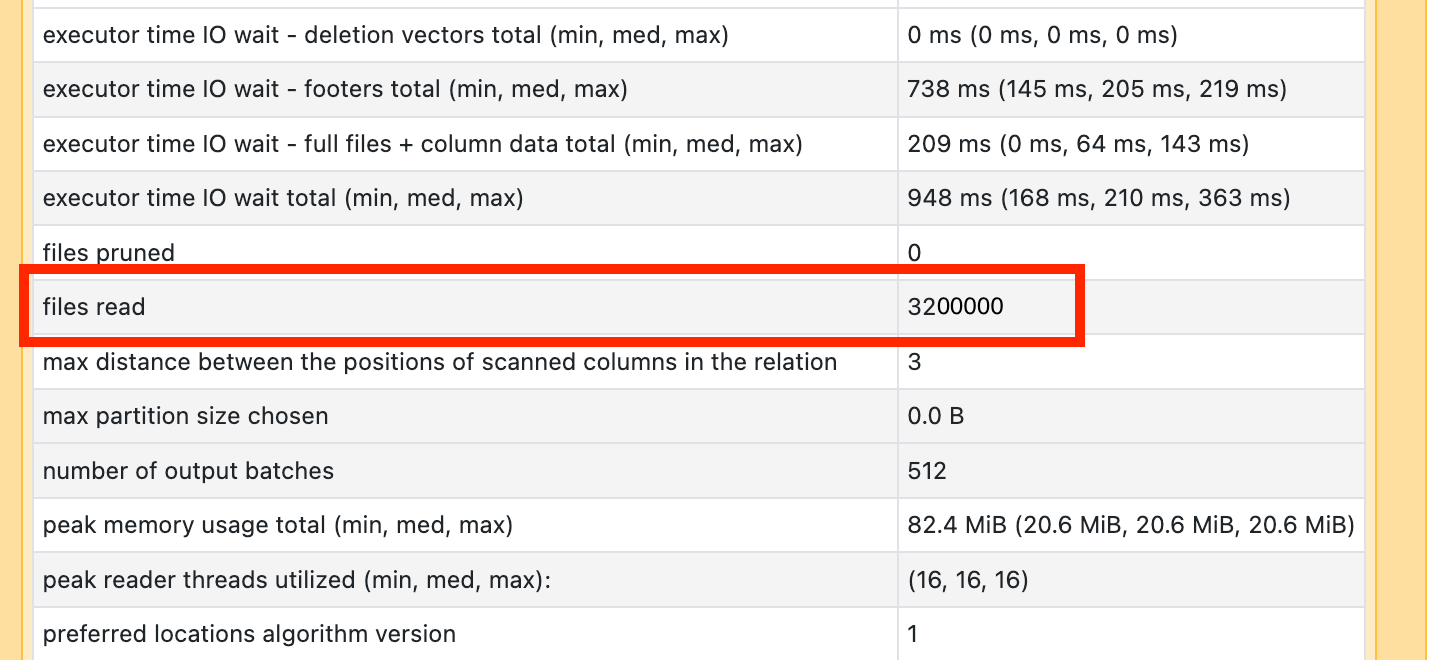
Si la query lit des dizaines de milliers de fichiers ou plus, la table peut avoir un problème de petit fichier. Les fichiers doivent faire au moins 8 Mo. Le partitionnement sur trop de colonnes ou sur une colonne à haute cardinalité entraîne le plus souvent de petits fichiers.
L'exécution d'OPTIMIZE pourrait aider. Databricks recommande également d'activer l'optimisation prédictive et de reconsidérer le Layout des fichiers.
Écriture de nombreux petits fichiers
Si un opérateur d'écriture consomme l'essentiel du temps, cliquez dessus et vérifiez le nombre de fichiers et la quantité de données écrits :
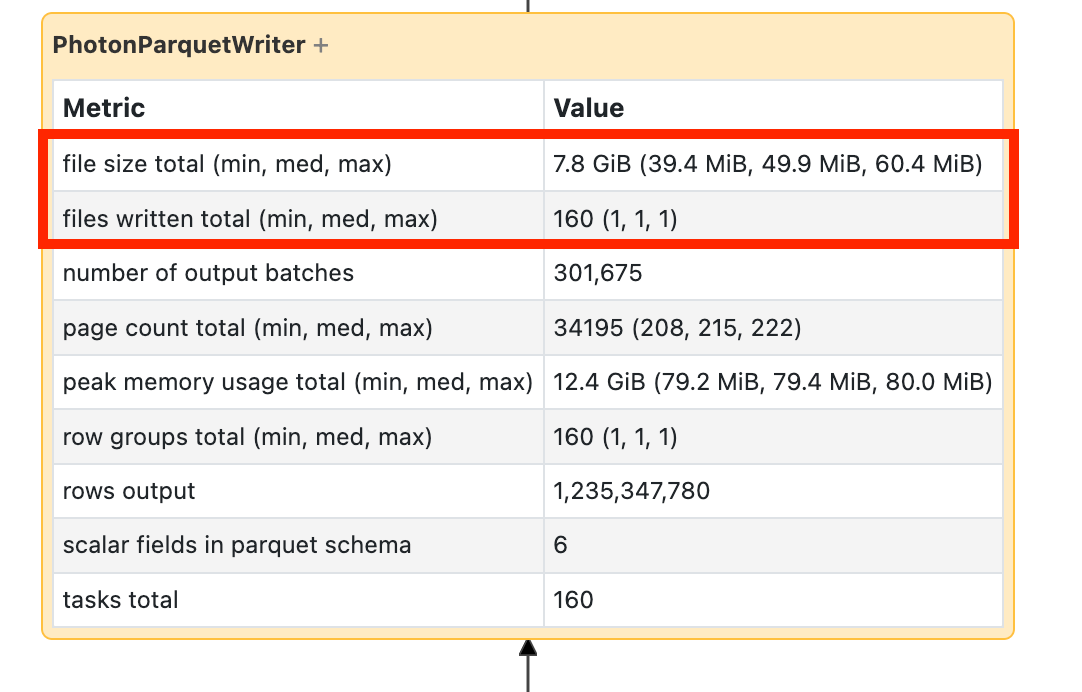
Si la query écrit des dizaines de milliers de fichiers ou plus, la table peut avoir un problème de petits fichiers. Les fichiers doivent faire au moins 8 Mo. Le partitionnement sur trop de colonnes ou sur une colonne à haute cardinalité entraîne le plus souvent de petits fichiers. Activez l'optimisation prédictive, réexaminez le layout du fichier ou activez les écritures optimisées.
UDF lents
Si la query contient des UDF ou un nœud DAG comme celui-ci, les UDF peuvent être le goulot d'étranglement :

Pour vérifier, commentez l'UDF et observez la vitesse du pipeline. Si l'UDF constitue un goulot d'étranglement, réécrivez-la en utilisant des fonctions natives lorsque cela est possible. Si vous ne pouvez pas la réécrire, vérifiez le nombre de tâches exécutant l'UDF. Si l'étape comporte moins de tâches que le cluster comporte de cœurs, repartition() le DataFrame avant d'appliquer l'UDF :
  (df
    .repartition(num_cores)
    .withColumn('new_col', udf(...))
  )
Les UDF peuvent aussi causer des problèmes de mémoire. Chaque tâche peut charger toutes les données de sa partition en mémoire. Si ces données sont trop volumineuses, la query peut devenir lente ou instable. Le repartionnement est aussi utile ici, car il réduit la taille de chaque tâche.
Jointure cartésienne
Les jointures cartésiennes et les jointures en boucle imbriquée sont très coûteuses. S'il en apparaît un dans le DAG, vérifiez qu'il est intentionnel et envisagez des alternatives. Si la condition de jointure est une condition de point dans un intervalle ou de chevauchement d'intervalles, consultez Optimisation de la jointure de plage.
Jointure éclatée ou explosion
Si un nœud de DAG affiche un petit nombre de lignes en entrée et un nombre beaucoup plus important en sortie, une jointure avec explosion ou explode() peut être la cause :
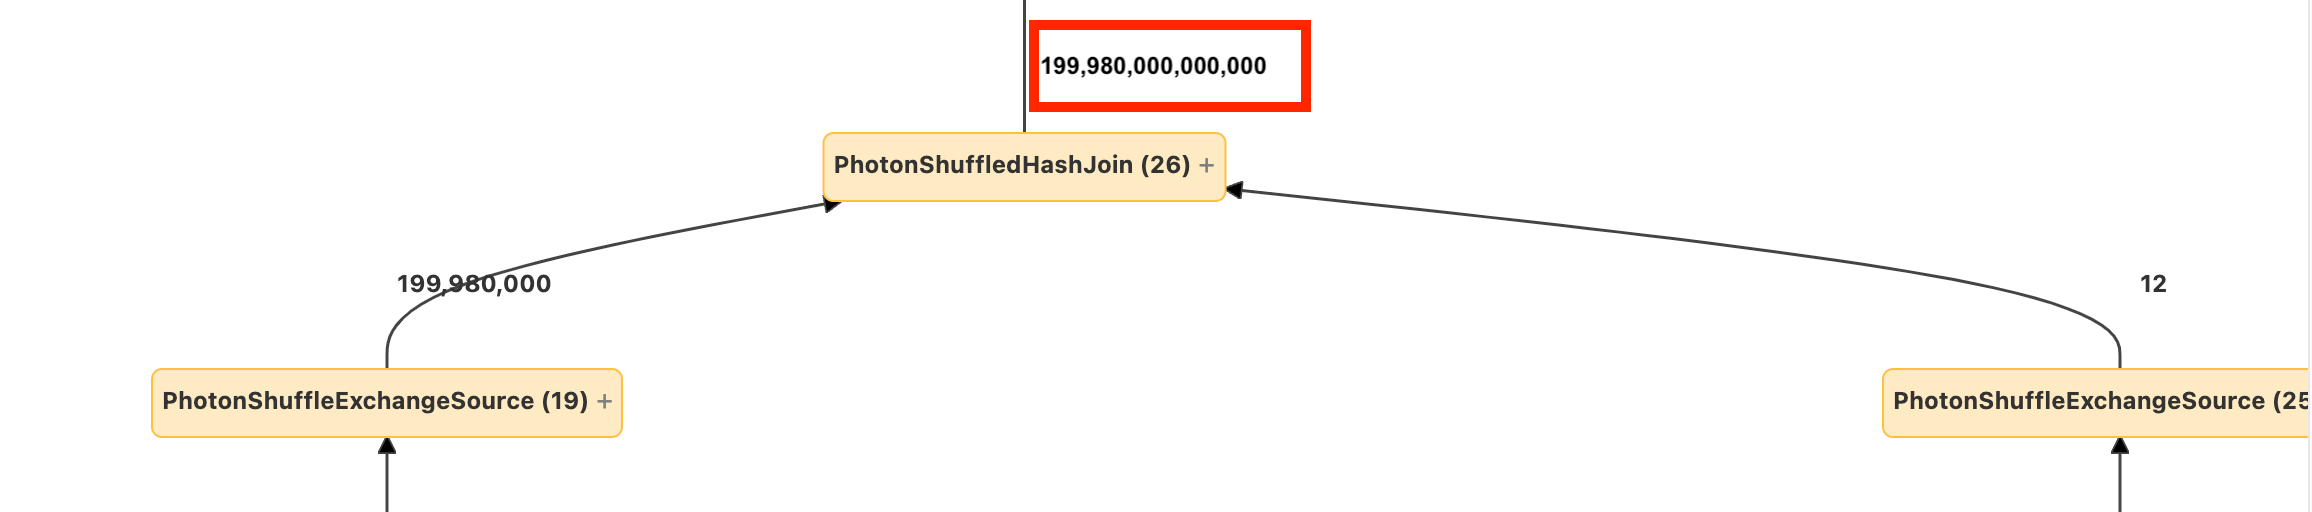
Pour corriger une jointure explosive, déterminez quel sous-ensemble du résultat vous avez besoin, puis mettez à jour la condition de jointure ou réduisez le nombre de lignes d'entrée des deux relations. Voir EXPLODING_JOIN.