分類
AIを使用して、ドキュメントを事前定義されたカテゴリに分類できます。
分類の例は次のとおりです:
- 顧客の通話記録を意図別に分類する
- コンテンツタイプによるドキュメントの分類
- センチメントによる製品レビューの分類
分類は、 Agent Bricks UI 、 SQL 、 REST API 、およびAsynchronous API (ベータ)を通じて利用できます。
UI で分類エージェントを作成
要件
ワークスペースの左側のナビゲーションペインで、 エージェント に移動します。 エージェントの作成 をクリックし、 テキスト分類 を選択します。
ステップ1. ソースデータを選択します。
分類機能を使用してドキュメントを分類します。
-
ソースデータを選択してください。ドキュメントを含むボリュームまたはテキストデータを含むテーブルを選択できます。
-
エージェントの作成 をクリックします。
ステップ2. 分類ラベルを構成します
分類によってデータが処理された後、分類ラベルを構成および調整します。
分類ラベルを手動で追加するには:
- 分類ラベルを追加するには、 + ラベルを追加 をクリックしてください。
- ラベル名とオプションの説明を入力し、 [ラベルを追加] をクリックします。
- 追加したい各ラベルに対して、手順1~2を繰り返します。
- (オプション)エージェントに複数のラベルを返させたい場合は、**「複数のラベル」**を有効にします。
テーブルからラベルをインポートするには:
- テーブルからインポート をクリックします。
- テーブルを選択し、**次へ**をクリックします。
- ラベル列、説明列、およびSQLウェアハウスを選択します。
- インポートされたラベルを確認するには、**プレビュー**をクリックします。
- ラベルの内容にご満足いただけましたら、「ラベルのインポートと置き換え」をクリックしてください。
分類を実行するには、少なくとも2つのラベルを定義する必要があります。ラベルの追加が完了したら、 「保存して分類を実行」 をクリックします。
追加のオプションを構成するには、[保存して分類を実行] の横にあるオプションのトグル をクリックし、以下のオプションから 1 つ以上を有効にします:
- 信頼度スコア : 予測ラベルの信頼レベルを表示します。
- 根拠 :予測ラベルの正当性を示します。
分類は、最大5つのドキュメントと行を分類し、結果を表示します。さらに追加することもできます。
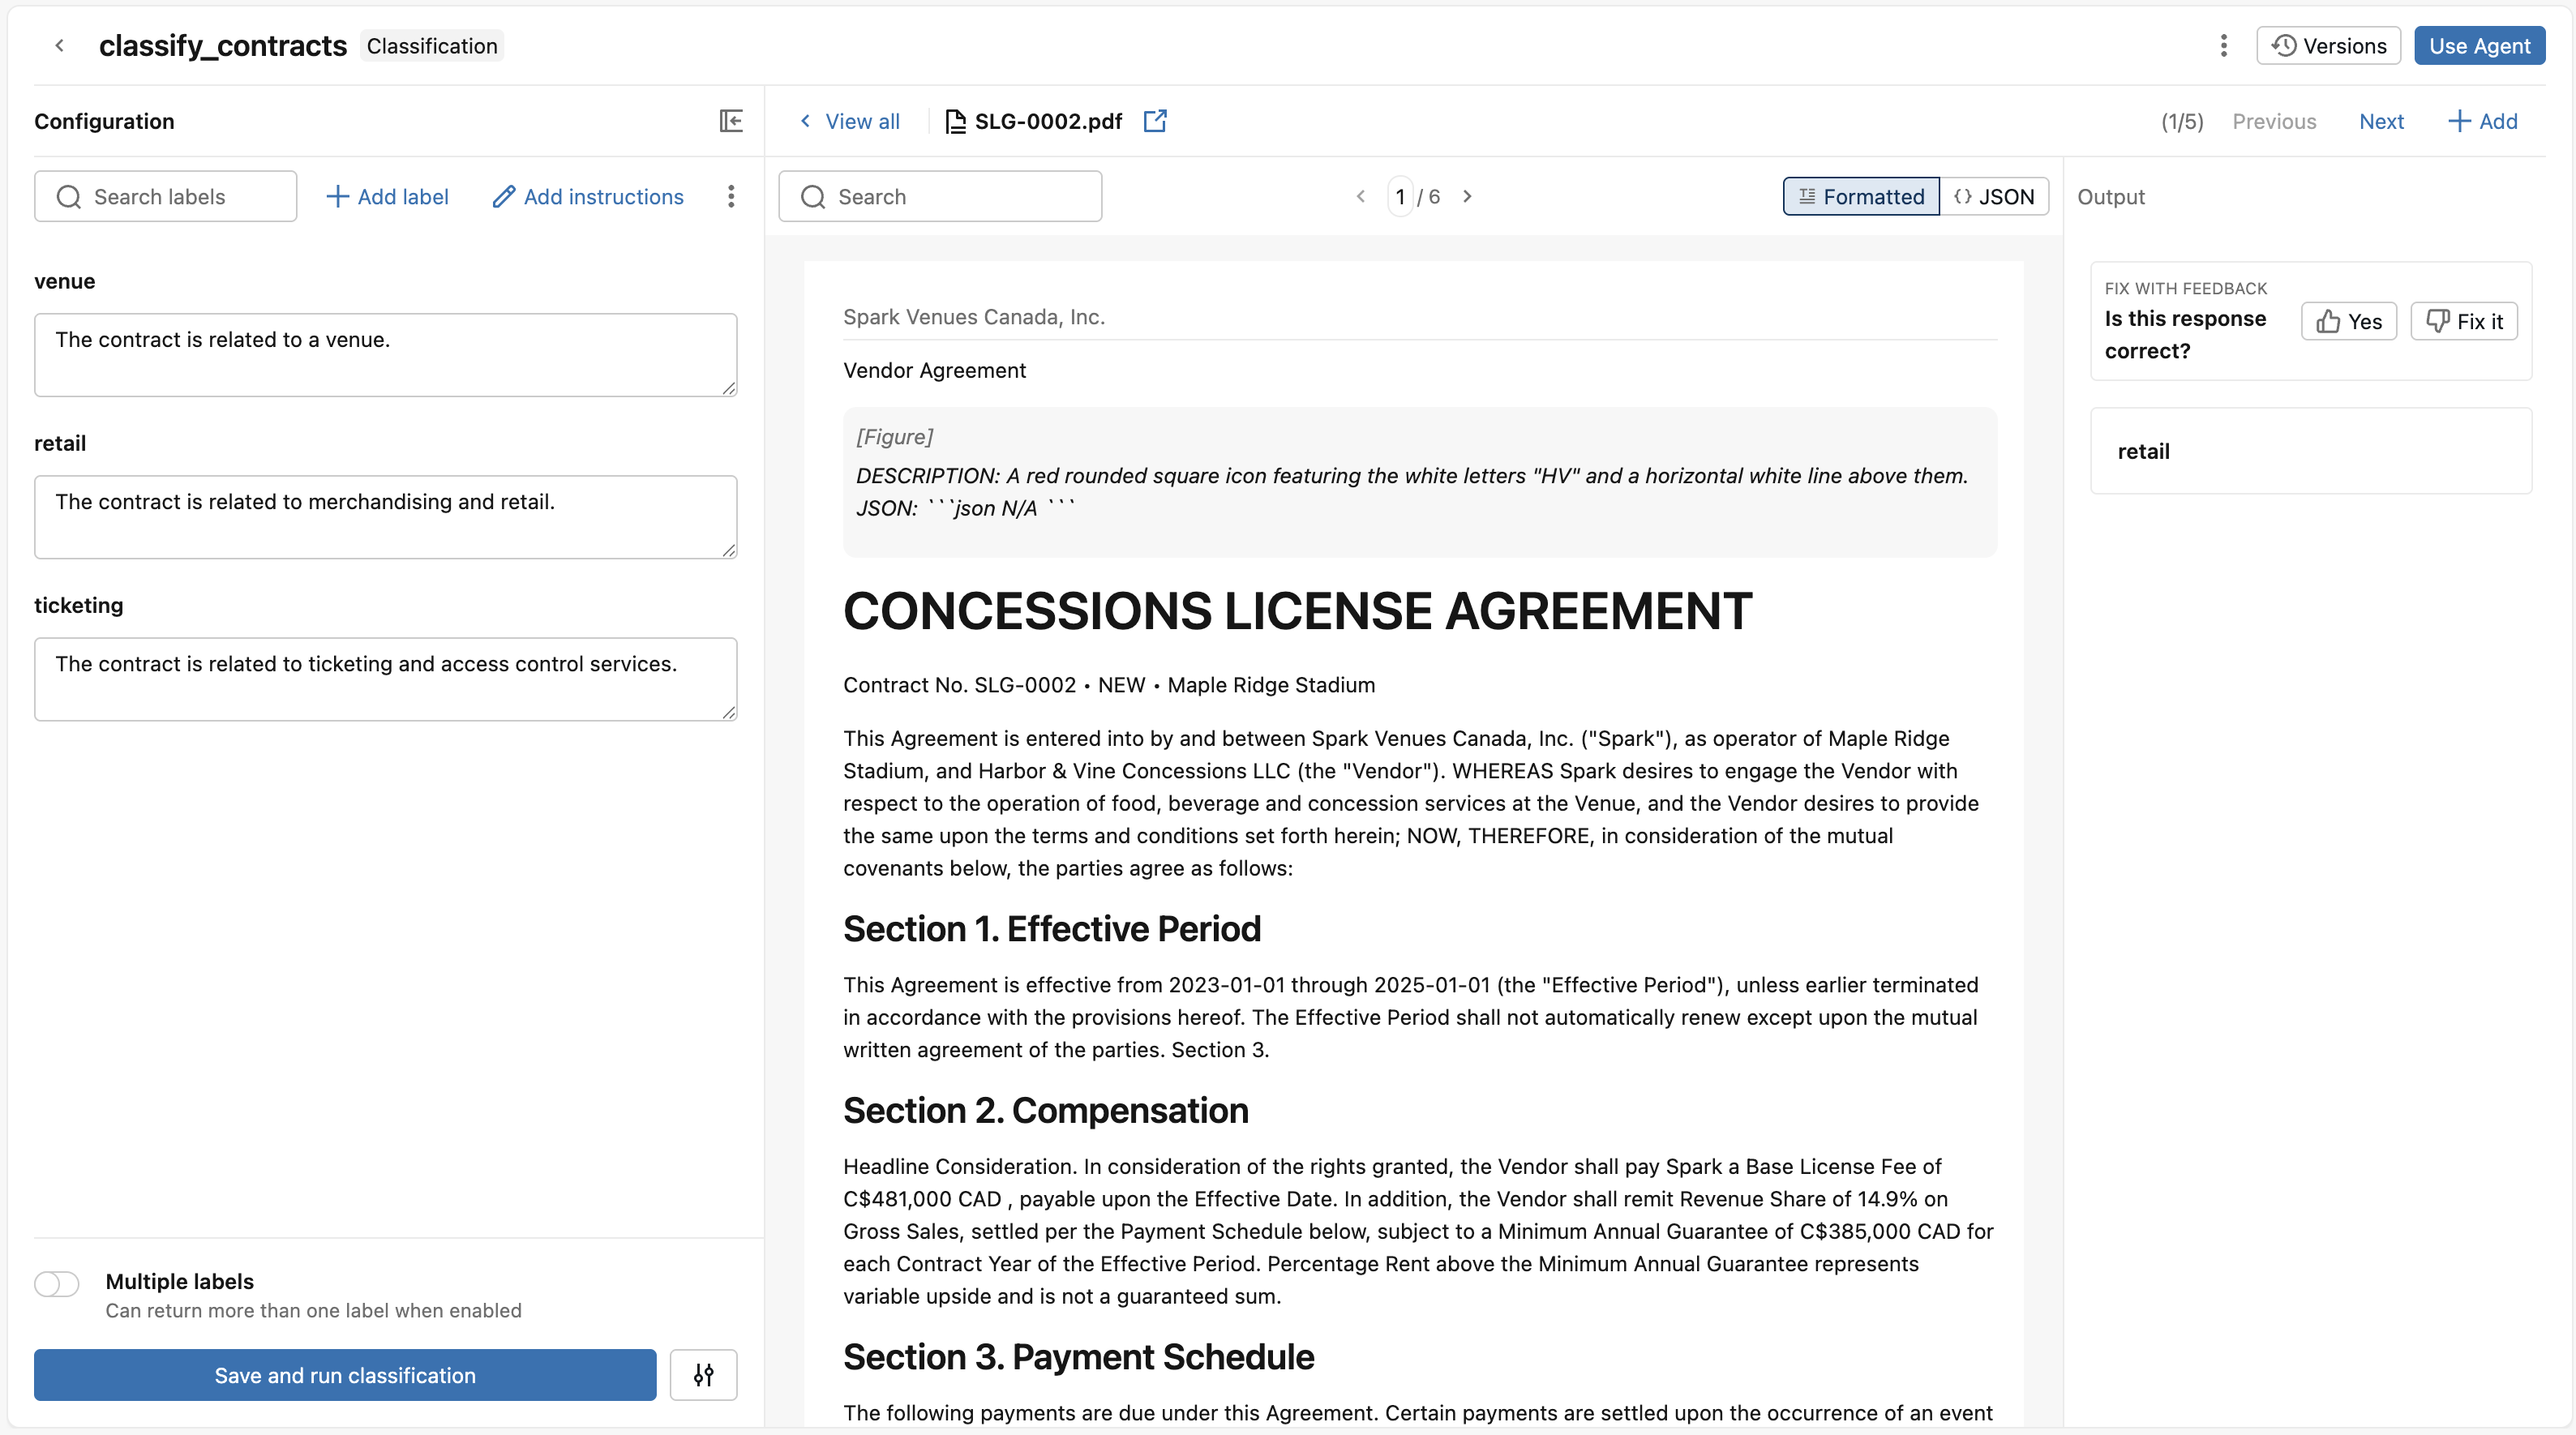
ステップ 3. 分類レスポンスのレビューと改善。
分類レスポンスを確認し、エージェント改善のためのフィードバックを提供してください。
-
ドキュメントと分類応答を確認します:
- 回答が正しい場合は、高評価してください。
- 応答が正しくない場合は、低評価を付けます。正しいラベルを選択して、分類が応答を修正できるようにします。 保存 をクリックします。
-
エージェントの応答を改善するには、分類ラベルの説明を調整してください。
-
エージェントのパフォーマンスを最適化するために、バージョンを比較します。 **「バージョン」** をクリックします。以前のバージョンの横にある**「比較」**をクリックして、以前のバージョンと現在のバージョンの分類ラベルの説明を比較します。以前のバージョンを復元するには、**「復元」** をクリックします。
ステップ 4: 分類エージェントを使用する
応答にご満足いただけた場合、大規模分類にエージェントをご利用ください。
右上の Use Agent をクリックします。次のいずれかを選択できます。
- ボリュームまたはテーブル全体をエージェントで分類するには、**SQL で実行**します。これにより、定義した分類ラベルを使用して
ai_classifyを利用するSQLクエリが開きます。SQLクエリでai_classifyを使用する方法の情報の詳細については、ai_classify関数を参照してください。 - 新しいデータでエージェントを呼び出すため、スケジュールされた間隔でランする LakeFlow Pipelinesを作成 します。これにより、分類済みデータでストリーミングテーブルを更新するLakeflowパイプラインが作成されます。パイプラインのスケジュールを設定して、新しいデータが到着したときに実行されるようにできます。Lakeflowパイプラインの情報については、Lakeflow上のSpark宣言型パイプラインを参照してください。
SQL でドキュメントを分類する
SQL で ai_classify を呼び出して、ドキュメントを大規模に分類します:
SELECT ai_classify(
  'My password is leaked.',
  '["urgent", "not_urgent"]',
  MAP('version', '2.1')
);
ai_classify SQL リファレンスを参照してください。
REST API を使用したドキュメントの分類
Use the REST API to classify documents from applications, services, and automation workflows.See the REST API docs for reference.
ai_classify REST API リクエストの default のレート制限は、ワークスペースあたり 1 分あたり 1,200 リクエストです。より高い制限をリクエストするには、Databricks アカウント チームにお問い合わせください。
次の例では、カスタマーサポートのメッセージを分類します。
curl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/ai-classify" \
     -H "Authorization: Bearer $DATABRICKS_TOKEN" \
     -H "Content-Type: application/json" \
     -d '{
  "content": "My password is leaked.",
  "labels": ["urgent", "not_urgent"],
  "options": {
    "instructions": "Classify the support request by urgency."
  }
}'
非同期API(ベータ)によるドキュメントの分類
バッチ処理には、DatabricksはLakeflow JobsのAI関数タスクを推奨します。ジョブでレコードを分類するには、ai_classifyタスクを使用します。これは次のことを行います:
- バックグラウンドで処理をランし、結果を Unity Catalog テーブルに書き込むため、バッチを送信したり、ステータスを確認したり、出力ファイルをdownloadしたりする必要はありません。
- 前回のランから新規または変更された行のみを処理します。
- 各ランの進捗状況と、成功および失敗した入力の数を表示します。
処理を既存のアプリケーションまたは外部オーケストレーターに統合し、送信と結果を自分で管理する場合は、代わりにAI Functions非同期API(ベータ)を使用してください。
ベータ版
この機能はベータ版です。使用するには、ワークスペース管理者は プレビュー ページから AI Functions非同期API を有効にする必要があります。Databricksのプレビューを管理するを参照してください。
リクエストフィールドとレスポンスフィールド、バッチのキャンセルおよびリストのリクエストについては、非同期 API リファレンスをご覧ください。
入力ファイル
ai_classify バッチの入力ファイルは、Unity Catalog ボリューム内の JSONL ファイルであり、各行に 1 つのリクエストがあります。各行は、次のフィールドを完全に保持するJSONオブジェクトです。
フィールド | 説明 |
|---|---|
| リクエストを識別する文字列。出力ファイルの各行には、リクエストの |
|
|
次の入力ファイルには、2つの要求が含まれています。
{"custom_id": "ticket-001", "body": {"text": "My password is leaked."}}
{"custom_id": "ticket-002", "body": {"text": "How do I change my billing address?"}}
入力ファイルには、各レコードのテキストとIDのみが含まれています。バッチを作成する際にparamsでai_classifyの他のパラメーターを設定し、それらがすべての要求に適用されます。
labels(必須):レコードを分類するラベルのリスト、または各ラベルをその説明にマップするオブジェクトとして指定します。options:instructionsやmultilabelなどの関数オプション。
各パラメーターの機能については、「 AI 分類」 REST API リファレンスを参照してください。params.optionsでは、各オプション名をcamelCaseで記述します。たとえば、 enable_rationalesではなくenableRationalesと記述します。
バッチを作成すると、APIは入力ファイル全体とparamsを最初にチェックします。入力ファイルまたはparamsが以下のルールのいずれかに違反している場合、リクエストはHTTP 400で失敗し、バッチは作成されません。
-
ファイルはUTF-8エンコードされており、各行は
custom_idとbodyのフィールドを正確に持つ1つのJSONオブジェクトです。ファイルに空行はありません。 -
各
custom_idは空ではない文字列であり、2つの行で同じcustom_idを持つことはありません。 -
各
bodyには、textというキーがちょうど1つあります。textの値が文字列ではない場合でもバッチは作成され、そのリクエストはエラータイプinvalid_requestで失敗します。
-
ファイルは1行から50,000行までで、最大200 MiBです。
- より多くのレコードを処理するには、それらを複数の入力ファイルに分割し、ファイルごとにバッチを作成します。
-
paramslabelsを持ち、ai_classifyが受け取らないパラメーターを持たない。
入力ファイルの行に問題がある場合、エラーメッセージに行番号とルールが示されます(例:Batch input line 3 custom_id must be unique)。入力ファイルを読み取れないか、output_ref に書き込めない場合、要求は HTTP 403 で失敗します。
API はバッチを作成するときに入力ファイルをコピーするため、その後ファイルに加えた変更はバッチに影響しません。
バッチをランする
非同期APIを使用してレコードを分類するには:
-
入力ファイルで
ai_classifyをランするバッチを作成します。input_refに入力ファイルのパスを、paramsにすべてのリクエストのパラメーターを、output_refに出力ファイルのボリューム ディレクトリまたは新しいファイル パスを設定します:Bashcurl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/batches" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-H "Content-Type: application/json" \-d '{"endpoint": "ai_classify","input_ref": "/Volumes/my_catalog/my_schema/my_volume/requests.jsonl","params": {"labels": ["urgent", "not_urgent"],"options": {"instructions": "Classify the support request by urgency."}},"output_ref": "/Volumes/my_catalog/my_schema/my_volume/output/"}'レスポンスにはバッチ
nameが含まれます。次のステップで<batch-name>の代わりに使用してください。defaultでは、ワークスペースはすべてのユーザーで一度に最大20の未完了バッチを持つことができます。上限に達している場合、リクエストは HTTP 409 エラーで失敗します。別のバッチが終了したかキャンセルされた後、バッチを再作成します。 -
バッチのステータスを確認します。
statusがCOMPLETED、CANCELLED、またはFAILEDになると、バッチは終了します。Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/ai-functions/batches/<batch-name>" \-H "Authorization: Bearer $DATABRICKS_TOKEN"出力ファイルの準備が完了すると、レスポンス内の
output_refにそのパスが含まれます。 -
Files APIを使用して出力ファイルをdownloadします:
Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/fs/files/Volumes/my_catalog/my_schema/my_volume/output/<batch-name>_output.jsonl" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-o output.jsonl
出力ファイル
非同期 API は、 ai_classify バッチの出力ファイルを output_ref の場所に書き込みます。
output_refが/で終わっているか、既存のディレクトリを指している場合、APIは出力ファイルをそのディレクトリ内の<batch-name>_output.jsonlに書き込みます。複数のバッチで1つの出力ディレクトリを共有できます。- それ以外の場合、
output_refは出力ファイルのパスです。バッチを作成するとき、ファイルが存在していてはなりません。
出力ファイルには、入力ファイルの各行に対して1行が含まれます。行は入力ファイルと同じ順序です。各行にはリクエストのcustom_idと次のいずれかのフィールドがあります:
response: 要求の結果。これには、 AI 分類 REST API レスポンスと同じフィールドがあります。error: リクエストが失敗した場合のエラーのtypeとmessage。リクエストがランする前にバッチがキャンセルされた場合、タイプはcancelledです。
次の例は、成功した要求の行と、失敗した要求の行を示しています:
{"custom_id": "ticket-001", "response": {...}}
{"custom_id": "ticket-002", "error": {"type": "request_failed", "message": "..."}}
制限事項
制限事項を参照してください。