統合トレーステーブルを使用してすべてのAIアクティビティを監視する
ベータ版
統合トレーステーブルはベータ版です。Unity Gatewayは一般提供されていますが、そのベータ機能は個別に有効にする必要があります。アカウント管理者は、アカウントコンソールの [プレビュー] ページから Enhanced Unity Gateway のベータ機能を有効にする必要があります。Databricksのプレビューを管理するを参照してください。
統合トレーステーブルを使用すると、Unity Gateway サービス全体のすべてのアクティビティを監視、デバッグ、保護、および監査するための単一の場所が得られます。
メタストア管理者が統合トレースを一度セットアップします。その後は、エンドポイントごとの設定なしで、すべてのUnity Gatewayトラフィックが自動的に記録されます。
デフォルトでは、トレーステーブルを作成したメタストア管理者のみがそのテーブルを読み取ることができます。所有者が Unity Catalog を介して明示的にアクセス権を付与しない限り、エンドポイント の所有者やセキュリティチームを含む他のユーザーは、そのテーブルをクエリーできません。「権限とアクセス制御」を参照してください。
要件
- お客様のアカウントで Enhanced Unity Gateway のプレビュー版が有効になりました。「Databricksのプレビューを管理する」を参照してください。
- ワークスペースでUnity Catalog有効化されていること。
- ワークスペースでZerobus Ingestを利用できます。統合トレーステーブルは、Zerobus Ingestを介してスパンをUnity Catalogに書き込みます。サポートされているリージョンについては、インジェストの可用性を参照してください。
- 統合トレースを設定するためのメタストア管理者ロール。
CREATE TABLE、ターゲットの Unity Catalog カタログおよびスキーマにおけるUSE CATALOGおよびUSE SCHEMAの権限。- テーブルをクエリーするには:トレーステーブルに対する
SELECT権限。By default, メタストア管理者のみがクエリーを実行できます。他のユーザーにアクセス権を付与する方法については、「権限とアクセス制御」を参照してください。
デフォルトストレージを利用するカタログを使用するには、ワークスペース管理者が Zerobus Ingest Default Storage を Settings > Previews で有効にする必要があります。「Databricks プレビューの管理」を参照してください。
統合トレーステーブルとは
統合トレーステーブルは、すべての Unity Gateway サービスにわたるすべてのリクエストと応答を、OpenTelemetry("OTel")形式の 1 つの Unity Catalog テーブルにキャプチャします。これは推論テーブルと比較して、3つの利点を提供します:
- 完全。 すべてのサービスにわたるすべてのアクティビティが1か所に集約され、エンドポイントごとのセットアップは不要です。
- 強制可能。 メタストア管理者が一度テーブルを作成すると、ログ記録が無効になっているサービスによる死角が生じることなく、すべてのサービスにログ記録が適用されます。
- オープン。 OpenTelemetry 標準に基づいて構築されているため、カスタムの後処理なしで、あらゆるツールがデータを直接利用できます。
一般的な用途:
- デバッグ:
trace_idでフィルタリングして、失敗したエージェントランのすべてのステップをリプレイします。service_nameとstatus.codeでフィルタリングして、特定のエンドポイント上のすべてのエラーを検索します。 - AI 使用状況のアナリティクス: AI 関数を使用して LLM(コーディングアシスタントを含む)との対話を分析し、呼び出し元全体のパターンを把握して、組織内で AI が提供する価値を理解します。
- トークン使用量の削減: AI関数を使用して、LLMまたはMCPへの呼び出しにおける一般的なエラーパターンを分析し、エージェントやコーディングアシスタントの有効性を向上させる方法を理解します。
- セキュリティとコンプライアンス: すべてのスパンは、リクエスターの ID、Endpoint名、および完全なリクエストペイロードを記録するため、脅威の検出と調査のためにセキュリティツールにフィードできます。
- 監査可能性: ユーザー、エンドポイント、または時間範囲ごとの AI アクティビティを確認します。
トレースの配信はベストエフォート型(制限事項を参照)であるため、統合トレーステーブルは Databricksの監査 ログ を置き換えるものではなく、補完するものです。コンプライアンスのための記録システムとして、引き続き監査ログを使用してください。
統合トレーステーブルと推論テーブルの比較
統合トレーステーブルは、新規デプロイメントで推奨されるアプローチです。推論テーブルは引き続き利用可能ですが、単一のモデルサービスエンドポイントの要求/応答モニタリング専用に設計されています。推論テーブルの詳細については、「推論テーブルへのリクエストと応答の記録」を参照してください。
統合トレーステーブル | 推論テーブル | |
|---|---|---|
スコープ | すべてのUnity GatewayモデルサービスとMCPサービスを1つのテーブルに表示 | モデルサービングエンドポイントごとに、1つずつのテーブル |
設定 | メタストア管理者による 1 回限りのセットアップ。メタストアにアタッチされているすべてのワークスペースのすべてのサービスに適用されます | エンドポイントごとに有効にする必要があります |
スキーマ | OpenTelemetryスパン | Databricks固有(後処理が必要) |
エージェントワークフロー | すべてのホップが 1 つのテーブルに格納されます。完全なマルチホップトレースを再構築するための共有トレース ID は近日公開予定です。 | エンドポイントごとのテーブルに断片化 |
MLflow の互換性 | スパンは、MLflowツールが直接読み取れるMLflow互換のOTelスキーマを使用します | 手動トレース抽出が必要です |
所有者 | テーブルを作成するメタストア管理者 | エンドポイントの所有者 |
アクセス制御 | デフォルト: メタストア管理者のみ。Unity Catalogの権限とABAC行フィルターポリシーを使用して他のユーザーにアクセス権を付与する | エンドポイントごとのUnity Catalog ACLの分離 |
統合トレーステーブルの有効化
これは、メタストア管理者が実行する1回限りの操作です。テーブルは、選択したUnity Catalogパス(例:<catalog>.<schema>.unity_gateway_otel_spans)に存在します。
トレーステーブルを専用のカタログまたはスキーマに保存します。分離により、他のカタログやスキーマからの権限によってトレースデータが意図せず公開されることを防ぎます。テーブルを作成したメタストア管理者がその所有者となり、アクセス権を制御します。他のユーザーにクエリーアクセス権を付与するには、権限とアクセス制御に記載されている通り、ABACをセットアップすることをお勧めします。
- ワークスペースのサイドバーで、 AI Gateway をクリックします。
- Govern > Traces > Set up tracing をクリックします。
- トレーステーブルを作成する カタログ と スキーマ を選択します。
- トレーステーブルを作成するために Save をクリックします。
統合トレーステーブルを使用する
デフォルトでは、メタストア管理者のみがトレーステーブルをクエリーできます。共有する前に、各ユーザーが適切なトレースのみを表示できるように、ABAC 行フィルターポリシーを設定してください。以下の「権限とアクセス制御」を参照してください。
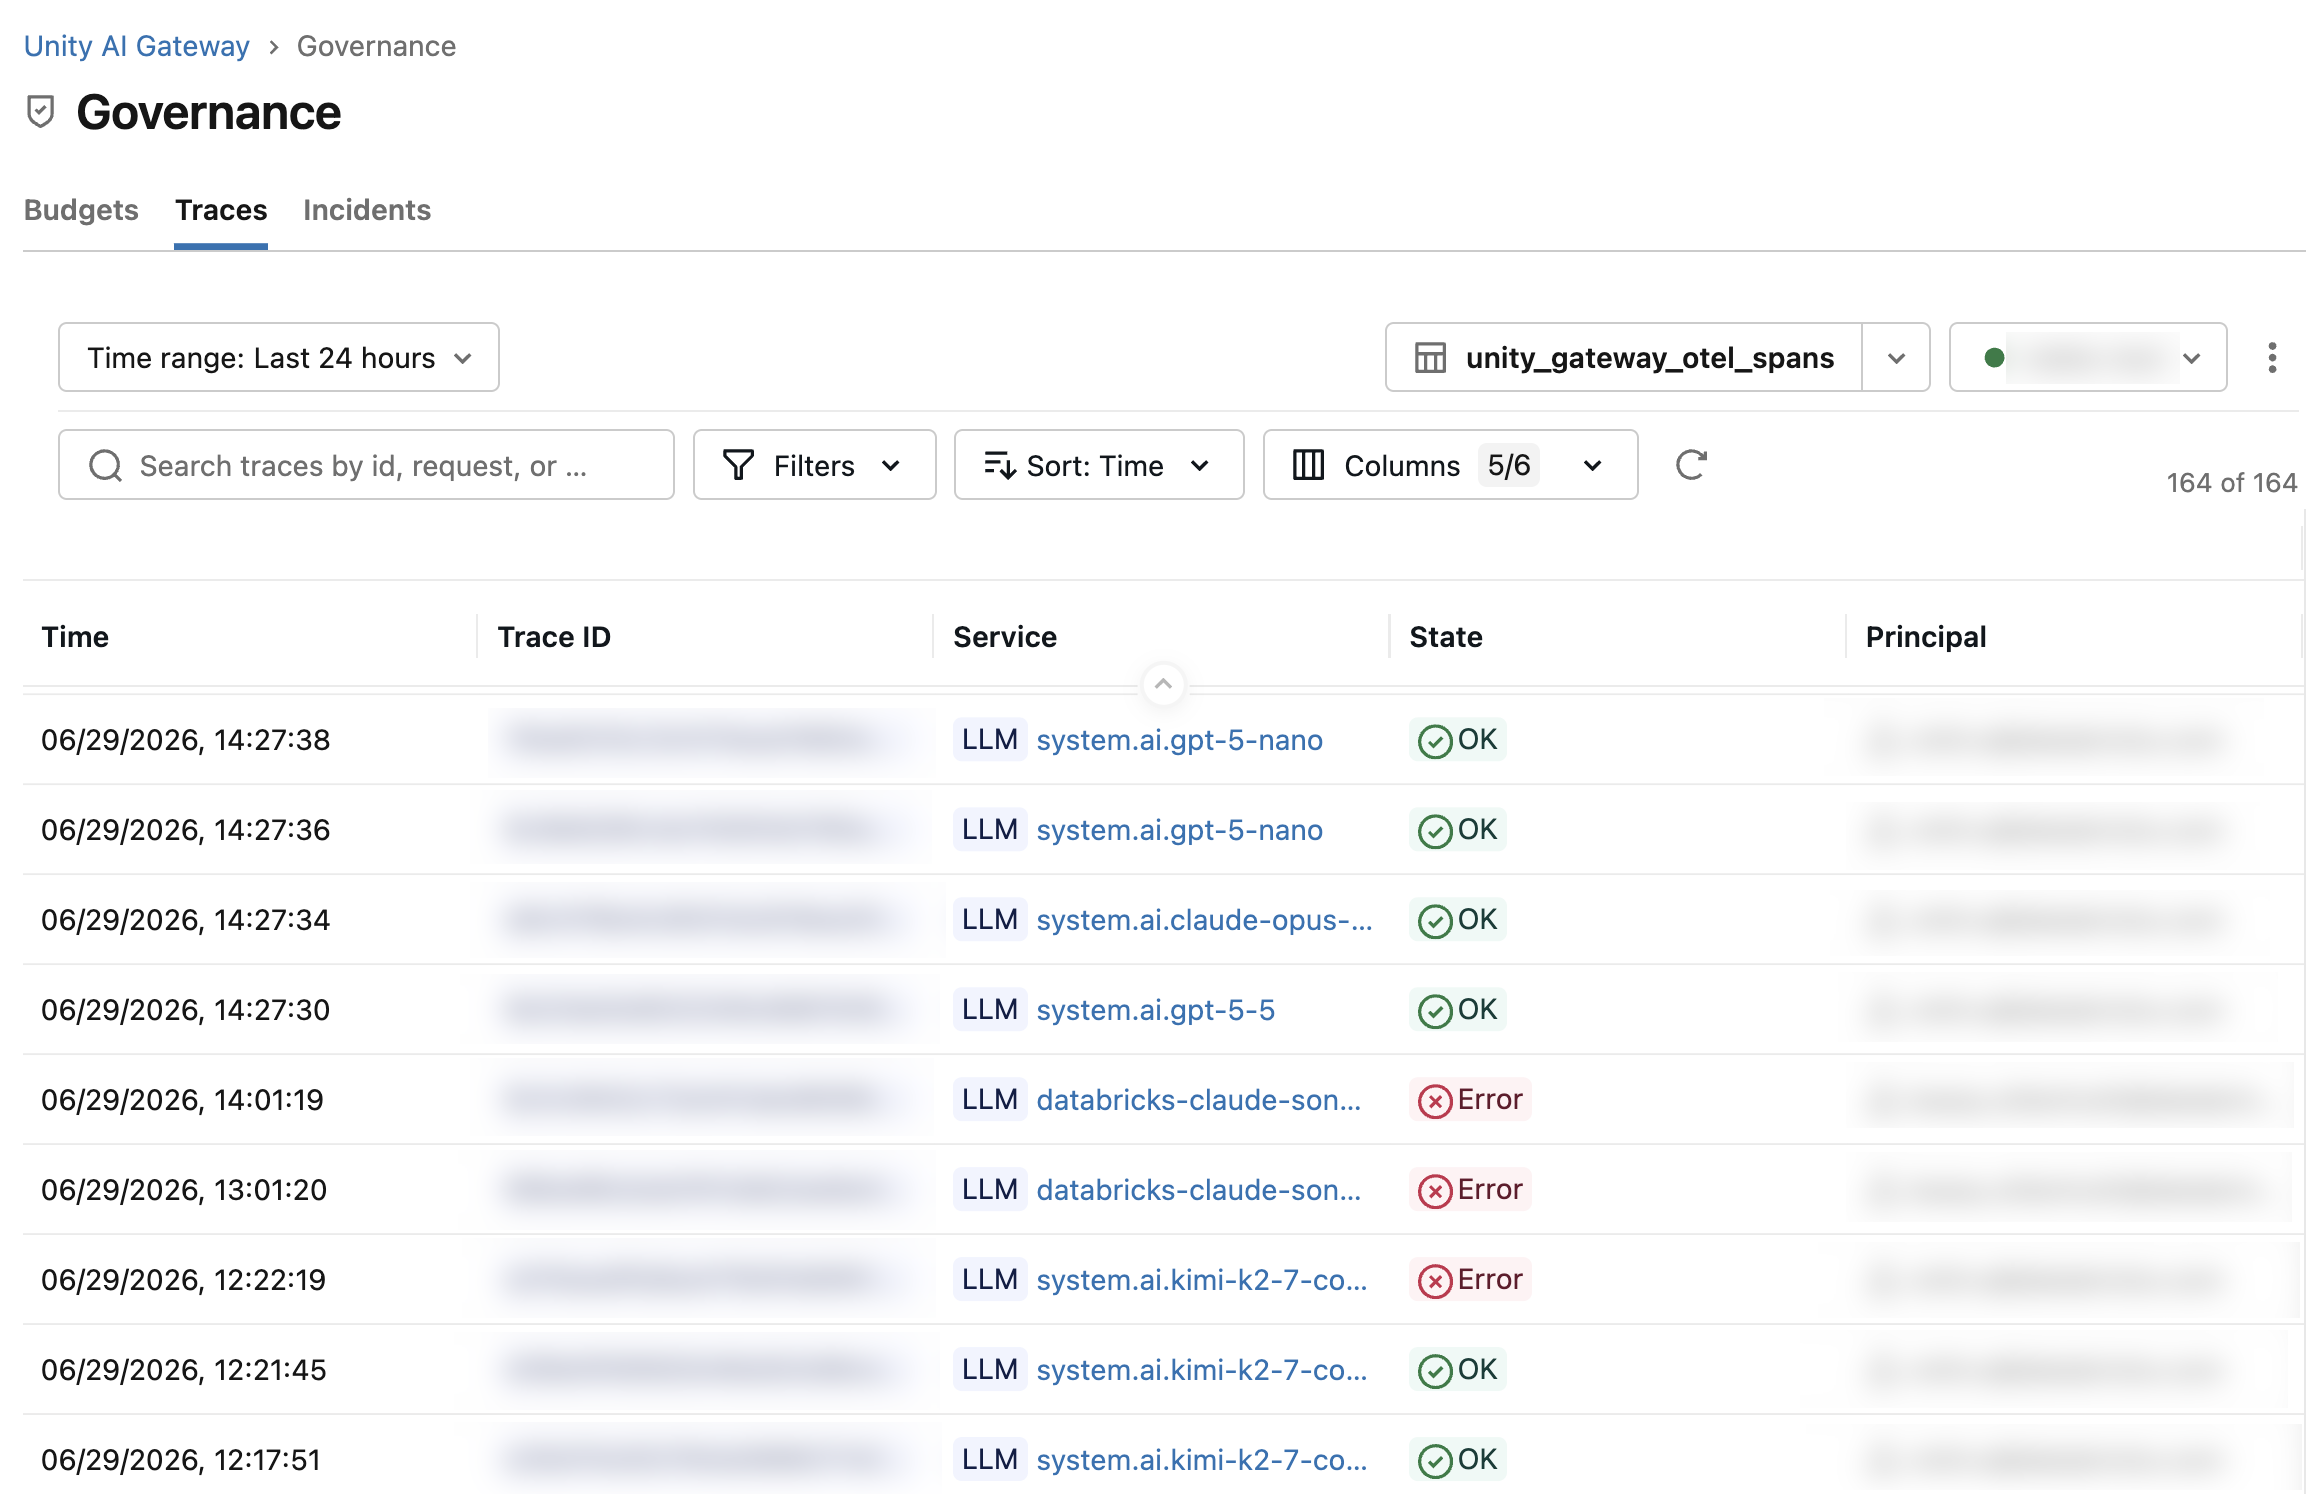
UI でトレースを表示する
- ワークスペースのサイドバーで、 AI Gateway > ガバナンス > トレース タブをクリックします。
トレースビューには、以下のコントロールが用意されています。
- 検索: 現在の画面内のコンテンツ全体に対する全文検索。
- 時間範囲: 時間ウィンドウでトレースをフィルタリングします(default:過去24時間)。
- フィルター: サービス (エンドポイント名)、 プリンシパル (リクエスター)、 サービスタイプ 、 状態 、または 実行時間 でフィルターします。
- 列: 列の表示または非表示を切り替えます。
- ウェアハウス: トレーステーブルに対してクエリーを実行するために使用するSQLウェアハウスを選択します。
Genie Codeでクエリーを作成する
Genie Codeはワークスペース全体で利用可能です。サイドバーからGenie Codeを開き、トレーステーブルに対するSQLクエリーを作成するよう依頼します。Genie CodeはUnity Catalogのテーブルスキーマを自動的に認識します。
プロンプトの例:
- 「過去24時間にcustomer-support-bot Endpointで発生したすべてのレート制限エラーを表示して」
- 「先週、p99応答時間が最も長かったユーザーは誰ですか?」
- 「エージェントが3回以上の下流呼び出しを行ったすべてのトレースを検索」
Genie Code は SQL を生成し、ノートブックまたは SQL エディターで直接実行できます。
SQL またはノートブックを使用したクエリー
テーブルはtimeでクラスタリングされています。最高のパフォーマンスを得るには、この列をWHERE句に含めてください。
<catalog>.<schema>.<table_name> をトレーステーブルのパスに置き換えます。
-- All spans for a specific trace
SELECT * FROM <catalog>.<schema>.<table_name>
WHERE trace_id = 'afdd29f3a069482f8b102380ba0fb3c8'
ORDER BY start_time_unix_nano;

-- All errors on a specific endpoint in the last 24 hours
SELECT trace_id, name, status, attributes
FROM <catalog>.<schema>.<table_name>
WHERE service_name = '<catalog>.<schema>.<model>'
  AND status.code = 'STATUS_CODE_ERROR'
  AND time >= current_timestamp() - INTERVAL 1 DAY;

-- Root spans only (one row per request), with requester and HTTP status
SELECT trace_id, name,
  attributes:`enduser.id`::string AS requester
  attributes:`http.response.status_code`::int AS status_code,
  status.code
FROM <catalog>.<schema>.<table_name>
WHERE parent_span_id IS NULL
  AND service_name = '<catalog>.<schema>.<model>';
アプリケーションからクライアント側のトレースを送信します
アプリケーションは、あらゆるOpenTelemetry SDKから、OTLP取り込みエンドポイントを通じてクライアント側のOpenTelemetryスパンをUnity Gatewayに送信できます。Claude SDKには、APIリクエストのトレースに対する組み込みサポートも用意されています。アプリケーションのスパンはゲートウェイリクエストのスパンと同じ統合トレーステーブル (<catalog>.<schema>.<table_name> 、設定時に選択) に記録されるため、アプリケーションが何を完了し、ゲートウェイが何を処理したかを一元的に監視できます。
ベータ版
クライアント側のスパン取り込みはベータ版であり、ワークスペースごとに有効になります。ワークスペースで有効にするには、Databricksアカウントチームにお問い合わせください。
要件
- 統合トレーステーブルは、ワークスペース用に設定されています。「統合トレーステーブルを有効にする」を参照してください。
- クライアント側のスパン取り込みは、ワークスペースで有効になっています。
- Databricksトークン(個人アクセストークンなど)。取り込まれたスパンは、トークンのプリンシパルに起因します。
enduser.idなど、ペイロード内のID属性は無視されます。 - トークンのプリンシパルはワークスペースにアクセスできます。それ以外の場合、リクエストは拒否されます。
OpenTelemetry SDKでスパンを送信する
OTLPエクスポーターをhttps://<workspace-url>/ai-gateway/otel/v1/tracesに向けます。エンドポイントは、バイナリprotobufエンコーディング(http/protobuf)を使用したHTTP経由のOTLPのみを受け入れます。JSONとgRPCはサポートされていません。ペイロードを圧縮せずに送信します。エクスポーターで圧縮を有効にしないでください(例:OTEL_EXPORTER_OTLP_COMPRESSIONを未設定のままにします)。
次の例では、任意のアプリケーションからスパンを送信します。
- Python
- TypeScript
-
OpenTelemetry SDKとOTLPエクスポーターパッケージ(
opentelemetry-sdkとopentelemetry-exporter-otlp-proto-http)をインストールします。 -
取り込みエンドポイントを指すOTLPスパンエクスポーターを使用してトレーサープロバイダーを登録する:
Pythonimport osfrom opentelemetry import tracefrom opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporterfrom opentelemetry.sdk.resources import Resourcefrom opentelemetry.sdk.trace import TracerProviderfrom opentelemetry.sdk.trace.export import BatchSpanProcessorDATABRICKS_TOKEN = os.environ.get('DATABRICKS_TOKEN')# service.name becomes the service_name of these spans in the trace table.provider = TracerProvider(resource=Resource.create({"service.name": "<your-application-name>"}))exporter = OTLPSpanExporter(endpoint="https://<workspace-url>/ai-gateway/otel/v1/traces",headers={"Authorization": f"Bearer {DATABRICKS_TOKEN}"},)provider.add_span_processor(BatchSpanProcessor(exporter))trace.set_tracer_provider(provider) -
アプリケーションコードにスパンを作成する:
Pythontracer = trace.get_tracer(__name__)with tracer.start_as_current_span(""):# Your application code...
BatchSpanProcessor スパンを非同期でエクスポートします。短命なスクリプトでは、プロセスが終了する前に provider.shutdown() (または provider.force_flush() ) を呼び出して、バッファリングされたスパンが送信されるようにしてください。
-
OpenTelemetry SDKおよびOTLPエクスポーターパッケージをインストールする:
npm install @opentelemetry/api @opentelemetry/sdk-trace-node @opentelemetry/exporter-trace-otlp-proto @opentelemetry/resources。 -
取り込みエンドポイントを指すOTLPスパンエクスポーターを使用してトレーサープロバイダーを登録する:
TypeScriptimport { trace } from '@opentelemetry/api';import { OTLPTraceExporter } from '@opentelemetry/exporter-trace-otlp-proto';import { resourceFromAttributes } from '@opentelemetry/resources';import { BatchSpanProcessor, NodeTracerProvider } from '@opentelemetry/sdk-trace-node';// service.name becomes the service_name of these spans in the trace table.const provider = new NodeTracerProvider({resource: resourceFromAttributes({ 'service.name': '<your-application-name>' }),spanProcessors: [new BatchSpanProcessor(new OTLPTraceExporter({url: 'https://<workspace-url>/ai-gateway/otel/v1/traces',headers: { Authorization: `Bearer ${process.env.DATABRICKS_TOKEN}` },}),),],});provider.register(); -
アプリケーションコードにスパンを作成する:
TypeScriptconst tracer = trace.getTracer('<your-application-name>');tracer.startActiveSpan('', (span) => {// Your application codespan.end();});
BatchSpanProcessor スパンを非同期にエクスポートします。短命のスクリプトでは、プロセスが終了する前にawait provider.shutdown()を呼び出して、バッファリングされたスパンが送信されるようにします。
コードなしでエクスポーターを構成するには、標準のOpenTelemetryエクスポーター環境変数を使用します。OTLPエクスポーター仕様を実装するOpenTelemetry SDKは、例えばPythonで引数なしでOTLPSpanExporter()を作成する場合などにそれらを読み取ります。ヘッダー値はパーセントエンコードされるため、Bearerの後のスペースは%20として記述されます。
export OTEL_EXPORTER_OTLP_TRACES_ENDPOINT="https://<workspace-url>/ai-gateway/otel/v1/traces"
export OTEL_EXPORTER_OTLP_TRACES_PROTOCOL="http/protobuf"
export OTEL_EXPORTER_OTLP_TRACES_HEADERS="Authorization=Bearer%20<token>"
export OTEL_SERVICE_NAME="<your-application-name>"
以下の動作に留意してください。
- すべてのトレーサープロバイダーに
service.nameリソース属性を設定します。それがないスパンは、トレーステーブルのunknown_external_serviceの下に表示されます。 - スパンには、16 バイトのトレース ID、8 バイトのスパン ID、親スパン ID、および起動時刻が必要です。検証に失敗したスパンは拒否され、応答の
partial_successフィールドでカウントされます。
クライアント側とゲートウェイのトレースを関連付ける
アプリケーションが Unity Gateway へのリクエストで W3C トレースコンテキスト (traceparent ヘッダー) を伝搬すると、ゲートウェイのリクエストスパンは伝搬されたトレースコンテキストに参加し、アプリケーションのスパンと同じトレースに表示できるようになります。汎用 OpenTelemetry SDK を使用する場合は、HTTP クライアントの OpenTelemetry インストルメンテーションを使用するか、リクエストヘッダーにコンテキストを挿入してコンテキストを伝搬します。W3C TraceContext がデフォルトのプロパゲーターです。
ゲートウェイのトレースリンクはベータ版であり、クライアント側のスパン取り込みとは別に、ワークスペースごとに有効になります。ワークスペースで有効にするには、Databricksアカウントチームにお問い合わせください。トレースリンクが有効になっている場合、ゲートウェイはUnity CatalogモデルサービスとMCPリクエストの着信トレースコンテキストを採用します。ゲートウェイは、トレースコンテキストをアップストリームモデルプロバイダーに転送しません。
応答の動作と制限
- エンドポイントはOTLP
ExportTraceServiceResponseを返します。HTTP 200は、スパンが永続的に格納されていることを意味するのではなく、配信のためにバッチが受け入れられたことを意味します。書き込みは非同期です。 - 拒否されたスパン(不正な形式のIDを持つスパンや、ワークスペースでトレーシングが有効になる前に送信されたスパンなど)は、応答の
partial_successフィールドで報告されます。バッチ全体を再試行するのではなく、partial_successを確認してください。 - クライアント側のスパン取り込みがワークスペースで有効になっていない場合、エンドポイントはHTTP 404を返します。トークンのプリンシパルにワークスペースへのアクセス権がない場合はHTTP 403を返し、リクエスト本文が有効なOTLP protobuf(JSONまたは圧縮された本文など)でない場合はHTTP 400を返します。
- エンドポイントは、リクエストごとに最大32 MiB、組織ごとに1秒あたり最大100リクエストを受け付けます。3 MiB(3,145,728バイト)を超える文字列属性値は切り捨てられます。配列およびマップ属性は切り捨てられません。レコードのサイズ制限を超えるスパンは破棄される可能性があります。詳細は制限事項を参照してください。
Claudeリクエストのトレース
Unity GatewayはClaudeのOpenTelemetryサポートと統合されており、Claude Messages APIのリクエストとClaude Managed Agentsセッションを統合トレーステーブル内のスパンとして記録します。Claudeスパンには2つのソースがあります。Claude SDKはアプリケーションからクライアント側のスパンを出力し、ClaudeコンソールはMessages APIリクエストとManaged Agentsセッションのサーバー側のスパンをエクスポートします。どちらのソースも使用できますし、両方を使用することもできます。
次のトレースを記録できます。
- Messages APIリクエスト : モデル、レイテンシー、トークン使用量を含む各リクエスト。コンテンツのキャプチャを有効にすると、スパンにプロンプトとレスポンスも含まれます。
- Claude Managed Agentsセッション : モデルリクエスト、ツール使用、トークン使用を伴う各エージェントのターン。エージェントが何をステップごとに行ったかを確認できます。
各ソースが何を記録するかの詳細については、AnthropicのOpenTelemetryドキュメントを参照してください。
Claude SDK
SDKは、アプリケーションが行うAPIリクエストのクライアント側のスパンを出力します。SDKはアプリケーションの登録済みトレーサープロバイダーを使用するため、 OpenTelemetry SDKを使用してスパンを送信するでトレーサープロバイダーを設定した後は、SDK固有のエクスポーターは不要です。そのセットアップのDatabricksトークンは、スパンエクスポーターのみを認証します。Anthropic リクエストは直接 Anthropic に送信され、Anthropic API キーを使用します。
- Python
- TypeScript
-
最新の
anthropicパッケージをインストールまたはアップグレードします(例:pip install --upgrade anthropic)。 -
OpenTelemetry SDKを使用してスパンを送信するの説明に従って、OpenTelemetryパッケージをインストールし、トレーサープロバイダーを登録します。
-
Claude SDKクライアントを作成して、リクエストを送信します:
Pythonimport anthropic# Uses your Anthropic API key from the ANTHROPIC_API_KEY environment variable.client = anthropic.Anthropic()message = client.messages.create(model="claude-opus-5-5",max_tokens=256,messages=[{"role": "user", "content": "What is a mixture of experts model?"},],)
-
最新の
@anthropic-ai/sdkパッケージをインストールまたはアップグレードします(例:npm install @anthropic-ai/sdk@latest)。 -
OpenTelemetry SDKを使用してスパンを送信するの説明に従って、OpenTelemetryパッケージをインストールし、トレーサープロバイダーを登録します。
-
Claude SDKクライアントを作成して、リクエストを送信します:
TypeScriptimport Anthropic from '@anthropic-ai/sdk';// Uses your Anthropic API key from the ANTHROPIC_API_KEY environment variable.const client = new Anthropic();const message = await client.messages.create({model: 'claude-opus-5-5',max_tokens: 256,messages: [{ role: 'user', content: 'What is a mixture of experts model?' }],});
Claude SDKが記録するもの
スパンはOpenTelemetry GenAIのセマンティック規約に従います。APIリクエストごとに1つのスパン(例:anthropic.messages.create)があり、トークン使用量はgen_ai.usage.*属性に記録されます。ストリーミング応答の場合、ストリームが完全に読み取られるか閉じられると、リクエストのスパンが終了します。
SDKは、以下の追加オプションをサポートしています。これらの例では、Python SDK を使用しています。
- コンテンツモード : デフォルトでは、スパンはメタデータのみ (
metadata_only) を保持します。プロンプトと応答をスパンに含めるには、traces.content_modeをcontent(Anthropic(open_telemetry={"tracer_provider": provider, "traces": {"content_mode": "content"}})など) に設定します。tracer_providerキーは、このクライアントのスパンをグローバルに登録されたプロバイダーとは異なるプロバイダーに送信する場合にのみ必要です。プロンプトと応答のコンテンツはトレーステーブルに記録されるため、 権限とアクセス制御で説明されているように、ABACポリシーまたはPII削除を使用してそれへのアクセスを制限してください。SDKのスパンのコンテンツ制限を超えたコンテンツは短縮され、古い入力メッセージから先に短縮されます。画像やドキュメントは型のみが関連しており、データは関連していません。 - 会話ID : リクエストを会話にグループ化するには、リクエストごとの会話ID
client.with_options(open_telemetry={**client.open_telemetry, "conversation_id": "<conversation-id>"})を渡します。with_optionsはopen_telemetry設定全体を置き換えるため、クライアントの既存の設定を Merge してコンテンツモードなどのオプションを維持します。 - トレースを無効にする : 1つのクライアントのトレースを無効にするには
open_telemetry=Falseを渡します。ANTHROPIC_OPEN_TELEMETRY環境変数はすべてのクライアントのトレースを制御し、ANTHROPIC_OPEN_TELEMETRY_TRACES_CONTENT_MODEはコンテンツ モード(ANTHROPIC_OPEN_TELEMETRY_TRACES_CONTENT_MODE=contentなど)を設定します。
Claude Console
コンソールのサーバー側スパンを統合トレーステーブルに送信するには、Databricksテレメトリ送信先を追加します。SDK呼び出しやアプリが実行するツールなど、アプリケーションからのクライアント側スパンは、Claude SDKトレースから取得されます。
-
Claudeコンソールで、 テレメトリの送信先に移動します。
-
Databricks送信先を追加し、ワークスペースURLとDatabricks個人用アクセストークンを入力します。
トークンとプリンシパルの属性付けを含む要件は、コンソールスパンにも適用されます。
トークンのカウント
Claude SDKとClaudeコンソールの両方からスパンを同じトレーステーブルに送信すると、各リクエストによって同じトークン数を持つ2つのanthropic.messages.createスパンが生成されます。SDKからはSPAN_KIND_CLIENTスパン、APIからはSPAN_KIND_SERVERスパンが生成されます。各リクエストを1回だけカウントするには、スパンの種類ごとにgen_ai.usage.*属性を合計します。次のクエリーでは、SDKのクライアント スパンを使用します。Claudeコンソールからのみスパンを送信する場合は、代わりにkind = 'SPAN_KIND_SERVER'を使用してください。
SELECT
  sum(attributes:`gen_ai.usage.input_tokens`::bigint) AS input_tokens,
  sum(attributes:`gen_ai.usage.output_tokens`::bigint) AS output_tokens
FROM <catalog>.<schema>.<table_name>
WHERE name = 'anthropic.messages.create'
  AND kind = 'SPAN_KIND_CLIENT';
権限とアクセス制御
すべての Unity Gateway トラフィックは 1 つのテーブルに集約されるため、エンドポイント ごとに個別の権限を維持するのではなく、一箇所でアクセスを管理できます。
デフォルトでは メタストア管理者のみがトレーステーブルをクエリーできます。テーブルを作成したメタストア管理者が、その所有者になります。他のユーザーにクエリーへのアクセス権を付与するには、テーブル所有者がテーブルに対して SELECT、スキーマに対して USE SCHEMA、カタログに対して USE CATALOG を付与する必要があります。行フィルターがない場合、これらの権限を持つすべてのユーザーがワークスペース内のすべてのサービスのトレースを表示できるため、Databricks ではアクセス権を付与する前に ABAC 行フィルターポリシーを適用することを推奨しています。
ABACポリシーによるアクセスをスコープ化
Databricks では、各ユーザーまたはチームが閲覧すべき行のみにアクセスできるように、属性ベースのアクセス制御(ABAC)の使用を推奨しています。ABAC 行フィルターポリシーは、クエリー実行時に動作する SQL 関数をトレーステーブル(またはその親カタログやスキーマ)に付与します。ユーザーが SELECT * を実行すると、手動で WHERE 句を指定しなくても、自動的に自分の行のみが返され、他のチームのトレースを読み取るリスクもありません。
次の例は一般的なポリシーを実装しています:管理者はすべてのトレースを閲覧でき、エンドポイントの所有者は自身のサービスのみを閲覧でき、その他のユーザーは何も閲覧できません。
この例では、各サービスが<service_name>-ownersという名前の対応するアカウントグループを持つという規則に従っています。これらのグループは自動的には作成されません。アクセス設定の一環として、管理者は各グループを作成して適切なメンバーを追加する必要があり、新しいエンドポイントが追加されるたびにこれを繰り返す必要があります。グループが追加されても、フィルター関数とポリシーは変更されません。
-
フィルター関数を作成します。各行のサービス名を受け取り、現在のユーザーに表示権限がある場合は
TRUEを返します。SQLCREATE OR REPLACE FUNCTION <catalog>.<schema>.ai_traces_filter(svc STRING)RETURNS BOOLEANRETURN is_account_group_member('admins')OR is_account_group_member(svc || '-owners'); -
ポリシーがバインドできるように、
service_name列にタグを付けます。ABACポリシーは、管理タグによってフィルター関数に列を渡します。SQLALTER TABLE <catalog>.<schema>.<table_name>ALTER COLUMN service_name SET TAGS ('ai_trace_service' = ''); -
トレーステーブルに行フィルターポリシーを作成します。
SQLCREATE POLICY ai_traces_filterON TABLE <catalog>.<schema>.<table_name>COMMENT 'Restrict trace visibility to service owners and admins'ROW FILTER <catalog>.<schema>.ai_traces_filterTO `account users`FOR TABLESMATCH COLUMNS has_tag('ai_trace_service') AS svcUSING COLUMNS (svc); -
各サービスに対して
<service_name>-ownersアカウントグループを作成し(存在しない場合)、メンバーを追加して、テーブルのクエリーに必要な権限を付与します。カタログに対してUSE CATALOG、スキーマに対してUSE SCHEMA、テーブルに対してSELECTの権限を付与してください。SQLGRANT USE CATALOG ON CATALOG <catalog> TO `customer-support-bot-owners`;GRANT USE SCHEMA ON SCHEMA <catalog>.<schema> TO `customer-support-bot-owners`;GRANT SELECT ON TABLE <catalog>.<schema>.<table_name> TO `customer-support-bot-owners`;
このポリシーが適用されると、クエリーを実行するユーザーに基づいて結果が自動的にフィルタリングされます:
SELECT * FROM <table>を実行するcustomer-support-bot-ownersのメンバーは、service_name = 'customer-support-bot'である行のみを表示できます。adminsグループのメンバーは、すべての行を表示できます。- 他のユーザーには行が表示されません。
新しいエンドポイントが追加されたら、最後のステップを繰り返します。一致する<service_name>-ownersグループを作成し、それにSELECTを付与してください。ポリシーとフィルター関数は変更されません。
完全な ABAC リファレンスについては Unity Catalog における属性ベースのアクセス制御を、その他の行フィルターパターンについては 行フィルターと列マスクの一般的なパターンを参照してください。
PIIのマスキングによるスコープアクセス
アクセスを拡大するもう1つのアプローチは、PIIを編集したバージョンのテーブルをマテリアライズすることです。編集されたテーブルには、より多くのユーザーをカバーする広範なSELECT権限を付与できます。トレードオフとして、トレースは2回マテリアライズされます。1回目は元のテーブル内の編集されていない形式(厳格なアクセス要件が維持されます)、2回目はより多くのコンシューマーに公開される別のテーブル内の編集された形式です。
Unity CatalogでのOpenTelemetryトレースからPIIを削除するリファレンスソリューションについては、Unity Catalogでのトレースのガバナンスと削除を参照してください。
スキーマ
統合トレーステーブルの各行は、1つの OpenTelemetry スパンです。列の完全なリスト、属性キー、およびポリシー評価イベントフィールドについては、統合トレーステーブルスキーマリファレンスをご覧ください。
制限事項
- ログに記録される最大属性サイズは 3 MiB (3,145,728 バイト) です。これを超える属性は切り捨てられます。スパンには
databricks.trace.payload_truncatedがマークされ、そのdropped_attributes_countがインクリメントされます。 - トレースログの配信はベストエフォートです。ほとんどのトレースは数秒以内に到着しますが、新しいテーブルの場合、トレースの到着までに最大1時間かかることがあります。
- 401、403、429、または 500 エラーの場合、トレース Logs は保証されません。
- テーブルスキーマの変更、テーブル名の変更、またはテーブルの削除を行うと、トレーステーブルが Logs を受信できなくなったり、破損したりする可能性があります。
- Databricks はトレース テーブルのライフサイクルを管理しません。保持ポリシーがない場合、テーブルは無制限に増加します。一定期間後に自動的に行を削除するには、テーブルで 自動有効期間 (Auto-TTL) を有効にします。これにより、バックグラウンドで
DELETEとVACUUMが実行されます。保持期間を自身で管理するには、定期的なDELETEをスケジュールして期限切れの行を削除し、続いてVACUUMを実行してストレージを再利用します。VACUUMを単独で実行しても、すでに参照されていないファイルが削除されるだけで、行は削除されません。本番運用でトレーシングを有効にする前に、保持ポリシーを定義してください。 - デフォルトではメタストア管理者のみがトレーステーブルをクエリーできます。エンドポイント作成者またはセキュリティチームが自身のトレースにアクセスできるようにするには、事前にメタストア管理者がABAC行フィルターポリシーを設定し、
SELECT、USE SCHEMA、およびUSE CATALOGを付与する必要があります。