高 QPS で AI Search エンドポイントのスループットをスケーリングする
デフォルトでは、標準エンドポイントはインデックスのサイズに応じて20~200 QPSをサポートしています。検索バー、レコメンデーションシステム、エンティティマッチングのようなリアルタイムアプリケーションは、多くの場合、100〜1,000以上のQPSを必要とします。標準エンドポイントのみ、ターゲットQPSを設定できます。Databricks は、そのスループットレベルに最適に一致するようにインフラストラクチャをプロビジョニングします(ベストエフォートであり、保証されません)。
ターゲットQPSを設定すると、追加の容量がプロビジョニングされ、Endpointのコストが増加します。実際のクエリートラフィックに関係なく、この追加容量に対して課金されます。throughputスケーリングはベストエフォートであり、保証されません。
高QPSを使用するのは、次のような場合です:
- お客様のアプリケーションには、50 QPSを超える持続的なスループットが必要です。
- 通常の負荷時に429 (リクエストが多すぎます) エラーが発生します。
- トラフィックが増加すると、平均利用率が低く見える場合でも、レイテンシは低下します。
要件
-
High QPSは標準エンドポイントでのみ利用可能です。ストレージ最適化エンドポイントはサポートされていません。
-
高QPSの本番運用ワークロードには、サービスプリンシパルのOAuth認証とインデックスURLを使用します。個人アクセストークン (PAT) とワークスペースクエリURLはプロトタイピングには適していますが、最適化されたクエリ経路を使用せず、数十QPSに制限されています。
-
ワークスペースにプライベートアクセス設定オブジェクトがアタッチされている場合、インデックスの種類やオブジェクトの設定に関係なく、ワークスペース内のどのインデックスも最適化されたクエリールートを使用できません。
- フロントエンド接続またはバックエンド接続に Private Service Connect を使用するワークスペースには、プライベートアクセス設定オブジェクトがあります。
- この構成では、クエリーはワークスペースクエリーURLを使用しますが、これは数十QPSに制限されているため、Endpointはそれより高い目標QPSに達することができません。
- QPSが高いワークロードでは、プライベートアクセス設定オブジェクトがアタッチされていないワークスペースを使用します。別のワークスペースを使用できない場合は、Databricksアカウントチームにお問い合わせください。
-
管理された埋め込みモデルを使用するDelta Syncインデックスは、ワークスペースでIPアクセスリスト機能が有効になっている場合、最適化されたクエリールートを使用できません。
- その構成では、インデックスへのクエリーはワークスペースのクエリーURLを使用しますが、これは数十QPSに制限されているため、Endpointはそれ以上のターゲットQPSに達することができません。これは、
query_vectorを通過するクエリーを含め、インデックスに対するすべてのクエリーに適用されます。 - プライベートアクセス設定オブジェクトがないワークスペースでは、セルフマネージド型埋め込みを使用してターゲットQPSに到達します。これには、埋め込みベクトル列を持つDelta Syncインデックス、またはDirect Vector Accessインデックスを使用します。埋め込みを提供するためのオプションを参照してください。
- その構成では、インデックスへのクエリーはワークスペースのクエリーURLを使用しますが、これは数十QPSに制限されているため、Endpointはそれ以上のターゲットQPSに達することができません。これは、
ターゲットQPSを設定する
新しいEndpointを作成するとき、または既存のEndpointを更新するときに、ターゲットQPSを設定してください。ターゲットthroughputに最適に一致するために必要な追加容量は、自動的にプロビジョニングされます。throughputスケーリングはベストエフォートであり、保証されません:実際のQPSは、インデックスサイズ、ベクトルの次元数、クエリーの複雑さ、フィルターの使用状況によって異なります。
- Databricks UI
- Python SDK
- REST API
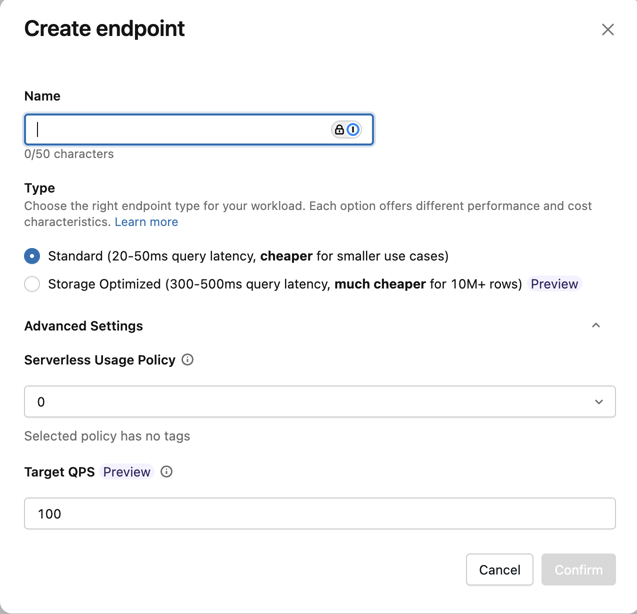
新しいエンドポイントを作成する際:
-
左側のサイドバーで、 コンピュート をクリックします。
-
「**AI Search**」タブをクリックし、「**エンドポイントを作成**」をクリックします。

-
「高度な設定」で、ターゲットQPS値を入力してください。
既存のエンドポイントを更新する際:
-
エンドポイントの詳細ページに移動してください。
-
右側のパネルで、
 「ターゲットQPS」 の横にある鉛筆アイコン をクリックします。

-
新しい値を入力し、「 保存 」をクリックします。

from databricks.ai_search.client import AISearchClient

client = AISearchClient()

# Create a new endpoint with target QPS
endpoint = client.create_endpoint(
    name="my-high-qps-endpoint",
    endpoint_type="STANDARD",
    target_qps=500,
)

# Update an existing endpoint's target QPS
response = client.update_endpoint(name="my-endpoint", target_qps=500)

# Check scaling status
scaling_info = response.get("endpoint", {}).get("scaling_info", {})
print(f"Requested target QPS: {scaling_info.get('requested_target_qps')}")
print(f"State: {scaling_info.get('state')}")
# State is "SCALING_CHANGE_IN_PROGRESS" while capacity is being provisioned,
# then transitions to "SCALING_CHANGE_APPLIED"
ターゲットQPSを指定してエンドポイントを作成します:
POST /api/2.0/vector-search/endpoints
{
  "name": "my-high-qps-endpoint",
  "endpoint_type": "STANDARD",
  "target_qps": 500
}
既存のエンドポイントでのターゲットQPSの更新:
PATCH /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
{
  "target_qps": 500
}
スケーリングステータスを確認する
GET /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
応答 scaling_info フィールドには、requested_target_qps とスケーリング state が表示されます。容量がプロビジョニングされている間は状態がSCALING_CHANGE_IN_PROGRESSとなり、その後SCALING_CHANGE_APPLIEDに移行します。
Service Principalの設定
高QPSクエリーには、インデックスに対してauthorization_detailsを持つOAuthトークン、またはアップサートと削除のが必要です。本番運用にはService Principalを使用します。Service Principalを設定するには:
-
Service Principalを追加し、インデックスを含むワークスペースに割り当てます。
-
Service Principal用のOAuthシークレットを作成します:
-
OAuthシークレットを作成のステップに従ってください。
-
スコープ で、クライアントがサポートする最も範囲の狭いスコープを選択します。トークンのスコープは、そのシークレットのスコープを超えることはできません。
- ラン負荷テストを実行 します:AI SearchのEndpointページ、負荷テスト用ノートブック、および
databricks-ai-search0.81以降で、インデックスがDatabricks管理の埋め込みモデルを使用している場合は、vector-searchを選択し、model-servingも選択します。これらのクライアントは、最初にall-apisを要求し、シークレットがそれを許可しない場合は、より狭いスコープにフォールバックします。SDKで選択したスコープを正確に要求するには、それらをAISearchClientのoauth_scopesパラメーターに渡します。例:oauth_scopes=["vector-search", "model-serving"]。インデックスがUnity Catalogのモデルサービスを通じて埋め込みを行う場合は、ai-gatewayも選択し、そのパラメーターを設定する場合はoauth_scopesに含めます。ノートブックとSDKは、ai-gatewayを含むスコープにフォールバックしますが、Endpointページの ラン負荷テスト ではそれを要求しません。そのため、そのページではall-apisを含むシークレットを使用します。 databricks-ai-searchの以前のバージョンとAI Searchインデックスへのクエリー方法のRESTトークンリクエスト: すべてのAPI を選択します。これらのクライアントはall-apisスコープを要求するため、より狭いスコープに限定されたシークレットではそれらのトークンを取得できません。このスコープはシークレットを広範なものにするため、このページの権限のみを持つ専用のService Principalを使用してください。
- ラン負荷テストを実行 します:AI SearchのEndpointページ、負荷テスト用ノートブック、および
-
クライアントIDとシークレットをアプリケーションコードに含めるのではなく、Secret Scopeに保存してください。
-
-
Service Principalに以下のUnity Catalog権限を付与します。
- インデックスを含むカタログに対するUSE CATALOG権限。
- インデックスを含むスキーマに対する USE SCHEMA 権限。
- インデックスに対するSELECT権限。
- Service PrincipalがDirect Vector Accessインデックスでデータをアップサートまたは削除する場合、インデックスに対するSELECTおよびMODIFY権限。
Service Principalがインデックスを所有している場合、SELECTまたはMODIFYは不要ですが、USE CATALOGとUSE SCHEMAは依然として必要です。
-
Databricks管理の埋め込みモデルを使用するインデックスの場合、埋め込みモデルサービングEndpointと、インデックスに
model_endpoint_name_for_queryが設定されている場合はそのEndpointにも権限を付与します。必要な権限はEndpointのタイプによって異なります。- トークン単位の従量課金 基盤モデル APIs エンドポイント (
databricks-gte-large-enなど): アカウントがUnity Catalog権限で基盤モデルを制限している場合を除き、権限の付与は不要です。その場合は、モデルにEXECUTE権限を付与してください。 - プロビジョニング済み throughput とカスタムサービング Endpoint :
query_textでクエリーを実行するには クエリー可能 を付与します。query_vectorでクエリーを実行して Python SDK を使用する場合でも、少なくとも 表示可能 を付与してください。get_index()はこれらのサービング エンドポイントを読み取るため、権限がないと失敗します。
- トークン単位の従量課金 基盤モデル APIs エンドポイント (
インデックスのクエリには、AI Search Endpoint自体に対する権限は必要ありません。
Service Principalは、OAuthマシン間(M2M)認証で認証します。OAuthトークンには、インデックスに対してReadVectorIndexを許可するauthorization_details、またはアップサートと削除のWriteVectorIndexが含まれている必要があります。
埋め込みモデルサービングEndpointまたはmodel_endpoint_name_for_queryEndpointがルート最適化されている場合、トークンにはそれぞれquery_inference_endpointを許可するworkspace_permissionエントリも必要です。サービングEndpointがルート最適化されているかどうかを確認するには、GET /api/2.0/serving-endpoints/<name>によって返されるroute_optimizedフィールドを参照してください。
- Python SDK : インデックスURLのクエリーに示すように、クライアントIDとシークレットを
AISearchClientに渡します。SDKは、必要なauthorization_detailsを持つトークンを要求し、サービングEndpointエントリを自動的に追加します。ルート最適化されたmodel_endpoint_name_for_queryEndpointの場合、databricks-ai-search0.79以上が必要です。 - REST API : トークンを自分でリクエストしてください。「AI Searchインデックスをクエリする方法」のREST API tabにあるService Principalの例を参照してください。
テスト用に、ノートブックトークン交換で取得したトークンを使用することもできます。本番運用にはService Principalを使用します。Databricks管理埋め込みモデルとquery_textを使用するDelta Syncインデックスにクエリーを実行するには、Service Principalトークンを使用してください。埋め込みモデルサービングEndpointがノートブックトークン交換からのトークンを403エラーで拒否する可能性があるためです。
権限の変更は、新しく発行されたトークンにのみ適用されます。権限を取り消しても、すでに発行されているトークンは無効になりません。そのトークンは、有効期限が切れるまで有効です。有効期限は最大1時間です。Python SDKを使用する場合、権限または埋め込みサービングEndpointの設定を変更した後でget_index()を再度呼び出してください。RESTの呼び出し元は、新しいトークンを要求する必要があります。
クエリーインデックスURL
Endpointのスケーリング状態が SCALING_CHANGE_APPLIED になったら、Service Principalトークンなど、インデックスに authorization_details を指定したOAuthトークンを使用してインデックスURLにクエリーを送信します。このURLは、target_qpsによってプロビジョニングされた追加のクエリー処理能力を使用するために必要です。
Pythonアプリケーションの場合は、get_index()を一度呼び出し、返されたインデックスオブジェクトを再利用してください。Python SDKはインデックスURLにクエリを送信します。
from databricks.ai_search.client import AISearchClient

client = AISearchClient(
    service_principal_client_id="...",
    service_principal_client_secret="...",
    workspace_url="https://<workspace-url>",
)

index = client.get_index(endpoint_name="my-high-qps-endpoint", index_name="catalog.schema.index")

# Reuse this index object for every query.
index.similarity_search(query_vector=[...], columns=["id", "text"], num_results=10)
REST または非 Python アプリケーションの場合は、最初にインデックス URL を取得し、その URL にクエリーリクエストを送信します。トークンは、インデックスに authorization_details を持つ OAuth トークンである必要があります。本番運用にはService Principalを使用してください。
export WORKSPACE_URL=https://<workspace-url>
export INDEX_NAME=catalog.schema.index
export TOKEN=<oauth-token>

export INDEX_URL=$(curl -X GET \
  -H "Authorization: Bearer $TOKEN" \
  "$WORKSPACE_URL/api/2.0/vector-search/indexes/$INDEX_NAME" \
  | jq -r '.status.index_url')

case "$INDEX_URL" in
  http://*|https://*) ;;
  *) INDEX_URL="https://$INDEX_URL" ;;
esac

curl -X POST \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  "$INDEX_URL/query" \
  --data '{"num_results": 10, "query_vector": [...], "columns": ["id", "text"]}'
高QPSの本番運用トラフィックには、/api/2.0/vector-search/indexes/<index_name>/queryのようなワークスペースクエリURLを使用しないでください。そのURLは最適化されたクエリ経路を使用していないため、エンドポイントが設定されたターゲットQPSに達する前に429エラーを返す可能性があります。
スケーリングの適用方法
目標QPSを設定すると、必要な容量が自動的にプロビジョニングされます。プロビジョニングが完了した後、新しいthroughputレベルが適用されます。変更をTriggerするためにインデックスを同期する必要はありません。
プロビジョニングには、インデックスのサイズとターゲット QPS の変化量に応じて、数分から数時間かかることがあります。進行状況を追跡するには、Endpoint の scaling_info.state を SCALING_CHANGE_APPLIED になるまで確認してください。
Endpointの状態がONLINEであっても、そのインデックスがクエリーを実行できる準備ができているとは限りません。Endpointに最初のインデックスを作成すると、Endpointのコンピュートが作成されている間、インデックスはPROVISIONING_ENDPOINTのままになります。トラフィックを送信する前に、インデックスのstatus.readyとstatus.detailed_stateを確認します。
スケーリング操作の進行中にターゲットQPSの更新を試行すると、RESOURCE_CONFLICTエラーが返されます。現在の操作が完了するのを待ってから、再試行してください。
429エラーのトラブルシューティング
高いQPSワークロードの場合、ボトルネックを見つけるには、以下のチェックを使用してください。
-
PATまたはワークスペースクエリーURLを使用している場合は、Service Principal OAuth 認証およびインデックスURLに切り替えてください。
-
scaling_info.stateがSCALING_CHANGE_IN_PROGRESSである場合、状態がSCALING_CHANGE_APPLIEDに変更されるまでお待ちください。 -
アプリケーションが
query_vectorでベクトルクエリーを送信する場合、埋め込みモデルはクエリーパス内にありません。スケーリング完了後に 429 エラーが継続する場合、リクエストの並行性を減らすか、より高いtarget_qpsを設定します。ターゲット QPS は約 10 件の結果を返すベクトルクエリーを想定しています。ハイブリッドクエリーおよび大きなnum_resultsの値はクエリーごとにより多くのキャパシティを使用するため、それらに対してより高いtarget_qpsを設定し、ワークロードの負荷テストを行います。 -
アプリケーションがDatabricksマネージド埋め込みモデルを持つDelta Syncインデックスにテキストクエリを送信する場合、埋め込みモデルがボトルネックになる可能性があります。の代わりに のようなより小さい埋め込みモデルを使用するか、
databricks-qwen3-embedding-0-6bdatabricks-gte-large-enプロビジョニングされたスループットの基盤モデルAPIエンドポイント または埋め込み用の別の専用Model Servingエンドポイントを使用してください。インデックスの埋め込みEndpointはインデックスの作成時に設定されるため、プロビジョニングされたthroughput Endpointなど、別の埋め込みEndpointを使用するには、新しいインデックスを作成します。作成時に、取り込み埋め込みモデルを保持し、
model_endpoint_name_for_queryで同じモデルを提供する別のクエリーEndpointのみを設定できます。
制限事項:
- オートスケールなし:予測されるトラフィックに基づいて、ターゲットQPSを手動で設定する必要があります。トラフィックがプロビジョニングされたレベルを超過した場合、429エラーが発生します。「クエリ スパイクの計画」を参照してください。
- 標準エンドポイントに限り:ストレージ最適化エンドポイントは
target_qpsをサポートしていません。 - 最適化されたルートが必要です : 構成されたターゲットQPSは、サービスプリンシパルOAuth認証とインデックスURLを使用するトラフィックに適用されます。PATトラフィックとワークスペースのクエリURLトラフィックは、数十QPSに制限されています。
- 管理対象の埋め込みモデルによって 2 つ目の制限が追加される可能性があります :テキストクエリーに管理対象の埋め込みモデルを使用する Delta Sync インデックスの場合、クエリーの throughput は埋め込みモデルサービングの Endpoint にも依存します。ターゲット QPS は、そのサービング Endpoint の容量を変更しません。予測可能なクエリーの throughput を実現するには、モデルサービングの容量を増やすか、プロビジョニングされた throughput を使用するか、またはセルフマネージドの埋め込みを使用します。