SQL と Spark API を使用した取り込み
このページでは、マネージド コネクタと比較してより高度な取り込みパイプラインのカスタマイズを提供する SQL および Spark API を使用して、Databricks Lakeflow Connect にデータを取り込む方法について説明します。これを使用して、データソースおよびパイプラインのカスタマイズのレベルに応じた取り込みアプローチを選択します。
ETLスタックのレイヤー
一部のコネクタは、ETL スタックの 1 つのレベルで動作します。たとえば、Databricks は、Salesforce などのエンタープライズ アプリケーションや SQL Server などのデータベース向けにフルマネージド コネクタを提供しています。その他のコネクタは、ETL スタックの複数のレイヤーで動作します。たとえば、完全なカスタマイズを行うために Structured Streaming で SQL および Spark API を使用することも、より管理されたエクスペリエンスのために Lakeflow pipelines を使用することもできます。
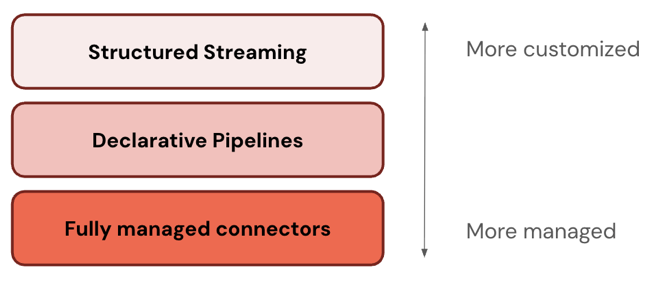
Databricks では、最も管理されたレイヤーから始めることをお勧めします。要件を満たさない場合 (たとえば、データソースをサポートしていない場合) は、次のレイヤーにドロップダウンします。
次の表では、インジェスト製品の 3 つのレイヤーを、最もカスタマイズ可能なものから最も管理しやすいものの順に説明しています。
層 | 説明 |
|---|---|
Apache Spark 構造化ストリーミングは、 Spark APIsを使用した exactly-once 処理保証を備えたエンドツーエンドのフォールト トレランスを提供するストリーミング エンジンです。 | |
LakeFlow PipelinesはStructured Streamingを拡張し、データパイプラインを作成するための宣言型フレームワークを提供します。データに対して実行する変換を定義でき、LakeFlow Pipelinesはオーケストレーション、モニタリング、データ品質、エラーなどを管理します。これらはStructured Streamingよりも、より多くの自動化と少ないオーバーヘッドを提供します。 | |
フルマネージド コネクタはLakeFlow Pipelinesに基づいて構築されており、最も一般的なデータソースに対してさらに多くの自動化を提供します。これらは、LakeFlow Pipelines機能を拡張し、ソース固有の認証、CDC、エッジケース処理、長期APIメンテナンス、自動再試行、自動スキーマ進化などを含みます。したがって、これらにより、サポートされているあらゆるデータソースに対してさらに多くの自動化が提供されます。 |
オプションを選択
次の表に、データソースおよびパイプラインのカスタマイズレベルごとの SQL および Spark の取り込みオプションを示します。完全自動化された取り込みエクスペリエンスを実現するには、代わりにマネージド コネクタを使用してください。
クラウドオブジェクトストレージからの増分データ取り込みに関する SQL の例では、CREATE STREAMING TABLE 構文を使用します。SQLユーザーにスケーラブルな取り込みエクスペリエンスを提供するいため、COPY INTOの推奨される代替手段となります。
ソース | その他のカスタマイズ | いくつかのカスタマイズ | さらなる自動化 |
|---|---|---|---|
クラウドオブジェクトストレージ |
| Auto Loader with LakeFlow Pipelines
|
|
SFTPサーバー | (Python、SQL) | N/A | N/A |
Apache Kafka |
| Kafkaソースを使用するLakeFlow Pipelines
|
|
Google Pub/Sub |
| LakeFlow Pipelines with Pub/Subソース
|
|
Apache パルサー |
| Pulsar ソースを使用したLakeFlow Pipelines
|
|
 Python
インジェスト スケジュール
インジェスト パイプラインは、定期的なスケジュールで実行するか、継続的に実行するように構成できます。