パイプラインの概念
LakeFlow Pipelinesは、SQLとPythonでバッチおよびストリーミングのデータパイプラインを構築するための宣言型フレームワークを提供します。その主要な概念は、パイプライン、フロー、ストリーミングテーブル、マテリアライズドビュー、およびシンクであり、これらは連携して自動オーケストレーションと増分更新によりデータを処理します。
LakeFlow Pipelines は、Apache Spark™ 宣言型パイプライン (SDP) を拡張したものです。SDP と LakeFlow Pipelines との比較について詳しくは、Apache Spark 宣言型パイプラインを参照してください。
パイプラインが初めてですか?「LakeFlow で Spark宣言型パイプラインを使用する方法」から起動して、パイプラインのライフサイクル全体でパイプラインを使用する方法と理由を理解し、各ステージのタスクへのLinkを参照してください。
パイプラインの利点は何ですか?
Apache Spark と Spark Structured Streaming APIs を Databricks Runtime 上で Lakeflow Jobs による手動のオーケストレーションを使用してデータエンジニアリングプロセスを開発する場合と比べると、パイプラインの宣言的な特性には次の利点があります。
- 自動オーケストレーション :パイプラインは、処理ステップ(「フロー」と呼ばれます)を正しい順序で最大限の並列性を保って実行し、一時的な障害を段階的に再試行します。まずSparkタスク、次にフロー、最後にパイプライン全体の順に再試行します。
- 宣言型処理 :宣言型関数を使用すると、手動で記述する数百行のSparkおよびStructured Streamingコードを数行に削減できます。AUTO CDC APIは、SCD Type 1およびType 2を含むチェンジデータキャプチャ(CDC)イベントを、順不同のイベントに対応する手動コードや、ウォーターマークなどのストリーミングの概念を必要とせずに処理します。
- インクリメンタル処理: インクリメンタル処理 エンジンは、マテリアライズドビューを最新の状態に保ちます。バッチセマンティクスで変換ロジックを記述すると、エンジンは可能な場合にのみ新規または変更されたソースデータを再処理します。
主要な概念
以下の図は、パイプラインの最も重要な概念を示しています。
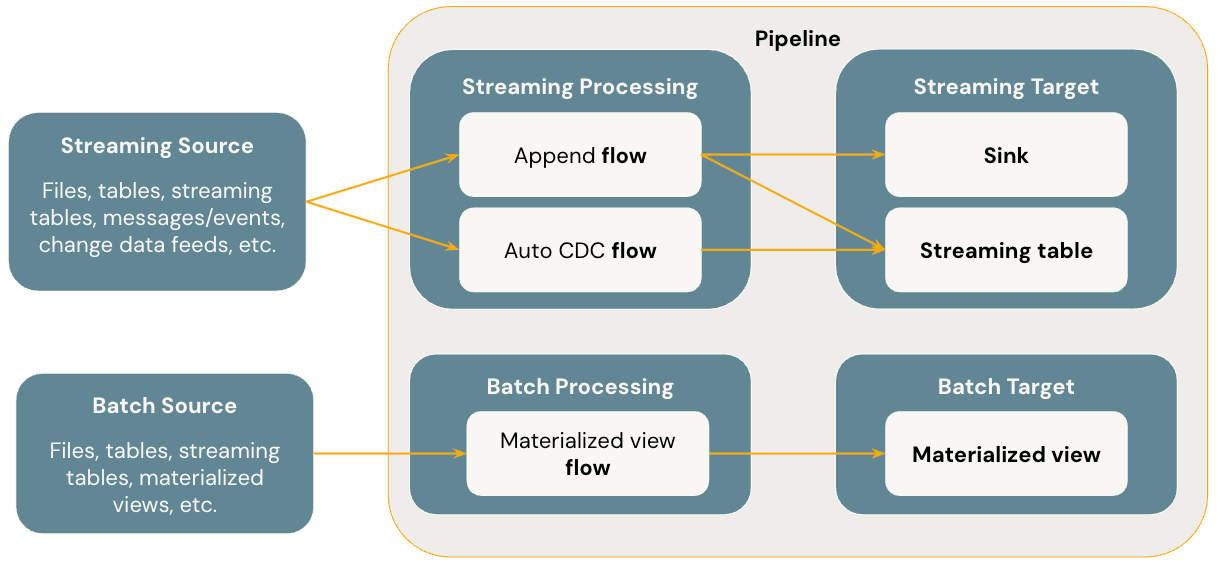
データセット
パイプラインは、それぞれ異なる処理セマンティクスを持つ3種類のデータセットを生成します:
データセットのタイプ | レコードの処理方法 |
|---|---|
ストリーミングテーブル | 各レコードは一度だけ処理されます。これは、追加専用のソースを前提としています。ストリーミングテーブルは、継続的に増加するデータの取り込みと増分処理に適しています。 |
マテリアライズドビュー | 必要に応じて結果が再計算され、データの現在の状態が反映されます。マテリアライズドビューは、複数のダウンストリームデータセットで利用される結果の変換、集計、または事前計算に適しています。 |
ビュー | オンデマンドで評価され、永続化されません。カタログに公開する必要がない中間変換とチェックには、ビューを使用します。 |
ストリーミングテーブル は、ストリーミングターゲットでもある Unity Catalog マネージドテーブルの形式です。ストリーミングテーブルには、1 つ以上のストリーミングフロー( Append 、 AUTO CDC )を書き込むことができます。ストリーミングフローを、ターゲットストリーミングテーブルとは別に明示的に定義することも、ストリーミングテーブル定義の一部として暗黙的に定義することもできます。
マテリアライズドビュー は、Unity Catalog マネージドテーブルの形式であり、バッチ ターゲットでもあります。マテリアライズドビューには、1 つ以上のマテリアライズドビューフローを書き込むことができます。マテリアライズドビューがストリーミングテーブルと異なるのは、常にマテリアライズドビューの定義の一部としてフローを暗黙的に定義する点です。
詳細については、ストリーミングテーブルおよびマテリアライズドビューを参照してください。
ビュー、マテリアライズドビュー、ストリーミングテーブルをどのような場合に使用するのか
パイプライン クエリを実装する際は、ユースケースに最適なデータセットの種類を選択してください。
ビューの使用を検討してください:
- 大規模または複雑なクエリを、より管理しやすいクエリに分割してください。
- エクスペクテーションを使用して中間結果を検証します。
- 永続化が不要な結果のストレージとコンピュート・コストを削減します。テーブルが具体化されるため、追加のコンピューティングおよびストレージリソースが必要となります。
マテリアライズドビューは、次の場合に使用を検討してください。
- 複数のダウンストリームクエリがテーブルを使用します。マテリアライズドビューはその結果をキャッシュするため、ダウンストリームクエリは、アクセスごとにクエリを再計算する代わりに、事前に計算された結果を読み込みます。
- 他のパイプライン、ジョブ、またはクエリがそのテーブルを利用します。マテリアライズドビューは Unity Catalog テーブルとしてマテリアライズされるため、それを定義するパイプラインの外部にあるコンシューマはそれをクエリできます。ビューはマテリアライズされないため、同じパイプライン内でのみ使用できます。
- 開発中にクエリの結果を検査したい場合があります。マテリアライズドビューは具体化されており、パイプラインの外部からクエリを実行できるため、開発中に計算の正確性を検証できます。検証後、具体化を必要としないクエリをビューに変換します。
- クエリが集計または結合を実行する場合、あるいはソースデータが追加されるだけでなく、更新や削除によって変更される可能性があります。マテリアライズドビューは、その結果をソースデータの現在の状態と一貫させます。一方、ストリーミングテーブルは追記専用のソース向けに設計されており、各レコードを1回処理します。
次のような場合は、ストリーミングテーブルの使用を検討してください。
- クエリーは、継続的または段階的に増加するデータソースに対して定義されます。
- クエリー結果は増分的にコンピュートされるべきです。
- パイプラインは高スループットと低レイテンシを必要とします。
ストリーミングテーブルは、常にストリーミング ソースに対して定義されます。 また、 AUTO CDC ... INTO でストリーミング ソースを使用して、CDC フィードからの更新を適用することもできます。「AUTO CDC APIs : パイプラインによる変更データ キャプチャの簡素化」を参照してください。
フロー
フローは、パイプラインにおける基本的なデータ処理の概念であり、ストリーミングおよびバッチセマンティクスの両方をサポートしています。フローは、ソースからデータを読み取り、ユーザー定義の処理ロジックを適用して、結果をターゲットに書き込みます。パイプラインは、Spark Structured Streaming と同じストリーミングフローのタイプ( 追加 、 更新 、 完了 )を共有します。(現在、 追加 フローと 更新 フローのみが公開されています。)詳細については、Structured Streaming の出力モードを参照してください。
パイプラインは、追加のフロータイプも提供します。
- AUTO CDC は、順序外れのCDCイベントを処理し、SCD Type 1 とSCD Type 2 の両方をサポートするLakeFlow Pipelines独自のストリーミングフローです。Auto CDC はSDPでは利用できません。
- マテリアライズドビュー は、パイプラインにおけるバッチフローであり、可能な限り新しいデータとソーステーブルの変更のみを処理します。
詳細については、LakeFlow Pipelines を使用してデータを増分的にロードおよび処理するを参照してください。
シンク
シンク はパイプラインのストリーミング ターゲットであり、Delta テーブル、Apache Kafka トピック、Azure EventHubs トピック、およびカスタム Python データソースをサポートしています。シンクには、1つ以上のストリーミングフロー ( Append , Update ) を書き込むことができます。
詳細については、Lakeflow pipelinesを参照してください。
パイプライン
「パイプライン」とは、開発と実行の単位であり、定義するフロー、ストリーミングテーブル、マテリアライズドビュー、シンクを格納するコンテナです。パイプラインソースコードでこれらのオブジェクトを定義し、パイプラインを実行することで、パイプラインを構築します。パイプラインの実行中に、定義されたオブジェクトの依存関係を分析し、実行順序と並列化を自動的にオーケストレーションします。
詳細については、「パイプラインとは?」を参照してください。
You can also define standalone マテリアライズドビュー and ストリーミングテーブル outside a Lakeflow pipeline, where Databricks manages the パイプライン for you.2つのアプローチを比較するには、スタンドアロンパイプラインとLakeflow pipelinesの比較を参照してください。
パイプラインはTriggerモードまたは継続的モードのいずれかで実行されます。このモードによって、利用可能なデータを更新して停止するか、新しいデータの到着に合わせてテーブルを最新の状態に保つかが制御されます。2つのモードを比較するには、「Trigger パイプライン モードと継続的パイプライン モード」を参照してください。
データ取り込み
パイプラインは、Databricksで利用可能なすべてのデータソースをサポートしています。Databricksでは、ほとんどのインジェストのユースケースでストリーミングテーブルを使用することをお勧めします。クラウドオブジェクトストレージ内のファイルについては、Auto Loader は段階的かつべき等な読み込みを提供します。ストリーミングデータの場合、パイプラインは Apache Kafka、Azure Event Hubs、Amazon Kinesis、Google Pub/Sub などのメッセージバスから直接取り込むことができます。「パイプラインでデータをロードする」を参照してください。
データ品質
期待値とは、データセットに付加されるオプションの条項であり、データがパイプラインを通過する際にその妥当性を検証するものです。期待値はSQLのBoolean制約として定義し、レコードが失敗した場合に何が起こるかを指定します。警告を表示する、レコードを削除する、または更新を失敗させる、といった具合です。パイプラインの期待値に基づいてデータ品質を管理する方法については、「パイプラインの期待値に基づいてデータ品質を管理する」を参照してください。
Delta 統合
パイプラインによって作成および管理されるすべてのテーブルはDeltaテーブルとなります。Delta Lake と同様に、ACIDトランザクション、タイムトラベル、スキーマ強制といった保証を備えています。パイプラインは追加のテーブルプロパティを追加し、予測的最適化を使用して自動メンテナンスを実行します。これには、OPTIMIZEおよびVACUUMの操作が含まれます。「Databricks の Delta Lake とは」を参照してください。