Databricks Feature Store の概要と用語集
Databricks Feature Store は、Machine Learningで使用される特徴量を一元化し、モデルのトレーニングと推論中に同じ特徴量計算が実行されるようにします。特徴量を特徴量ビューとして作成し、Databricksがコンピュートして管理する、または自分で入力する特徴量テーブルとして作成します。以下のセクションでは、一般的なワークフローと主要な用語の定義について説明します。
Databricks Feature Storeは何を提供しますか?
Feature Storeには、特徴量を作成する2つの方法があります。どちらも、バッチ推論に使用したり、低レイテンシのサービングのためにオンライン Feature Storeに公開したりできる Unity Catalog ガバナンス対応の特徴量を作成します。
- Feature Views は特徴量を宣言的に定義し、Databricks はユーザーに代わって特徴量パイプラインをコンピュートおよび管理します。Databricks では、新しいユースケースに対して Feature Views の使用を推奨しています。
- 特徴量テーブルは、特徴量値を書き込むことで独自に生成する Delta テーブルです。
それらの間での選択方法については、 「作成戦略の選択」を参照してください。
Databricks Feature Storeはどのように機能しますか?
Databricks で特徴エンジニアリングを使用する一般的な機械学習ワークフローは、次のパスに従います。
-
Feature エンジニアリング SDKを使用してヒストリカルデータとトレーニングセットを生成し、ノートブックで特徴量ビューのプロトタイプを作成します。満足するまで、特徴量の定義、データ、モデルを並行して繰り返します。
-
製品化:
- 特徴量を Unity Catalog に登録し、ガバナンス可能な再利用可能なアセットにします。
- MLflowでモデルをトレーニングしてログに記録し、トレーニングで使用される機能へのリネージをキャプチャします。
- 特徴量をオンラインストアまたはオフラインストアにマテリアライズします。
-
推論:
- バッチの場合は、
score_batchを使用します。 - オンラインの場合は、モデルまたは特徴量のオンラインサービングEndpointを設定します。
- バッチの場合は、

Feature Store用語集
Feature Store
Feature Storeは、 データサイエンティスト フィーチャーを検索して共有できるようにする一元化されたリポジトリです。また、Feature Storeを使用すると、モデル トレーニング中とモデルが推論に使用されるときとで、機能値をコンピュートするために使用されるコードが同じになるようになります。特徴量をDatabricksがコンピュートおよび管理する特徴量ビューとして、または特徴量テーブルとして作成できます。Unity Catalogが有効になっているワークスペースでは、主キー制約を特徴量テーブルとして含むUnity Catalog 内の任意のDelta テーブルを使用できます。
Machine Learningでは既存のデータを使用してモデルを構築し、将来の結果を予測します。生データを使用してモデルを構築するには、ほぼすべてのケースで、生データの前処理と変換が必要になります。このプロセスは特徴量エンジニアリングと呼ばれ、このプロセスの結果は、モデルのビルディングブロックとして特徴量と呼ばれます。Feature Viewsを使用すると、シンプルなPython定義で特徴量エンジニアリングを行い、Databricksがパイプラインを管理します。
特徴量の開発は複雑で時間がかかります。 さらに複雑なのは、機械学習の場合、モデルのトレーニングのために特徴計算を行う必要があり、その後、モデルを使用して予測を行うときに再度計算を行う必要があることです。 これらの実装は、同じチームによって、または同じコード環境を使用して行われない場合があり、遅延やエラーにつながる可能性があります。 また、組織内の異なるチームは、多くの場合、同様の特徴量のニーズを持っていますが、他のチームが行った作業を認識していない可能性があります。 特徴量ストアはこれらの問題に対処するために設計されています。
機能ビュー
Feature Viewsは、特徴量を定義するための抽象化です。Feature Viewを定義すると、Databricksがそれをコンピュートします。トレーニング時には、Feature エンジニアリング SDKが特定時点での正しい履歴特徴量データとトレーニングセットを生成します。推論のために、特徴量を適切なオンラインストアまたはオフラインストアにマテリアライズすると、Databricksはコンピュートをオーケストレートし、特徴量データがサービングの準備ができていることを保証します。
特徴ビューはバッチとストリーミングの両方の機能に対応しており、サブ秒からスケジュールされたクロンまでの鮮度を備えています。
特徴量テーブル
特徴量テーブルはプライマリーキー付きDeltaテーブルです。publish_tableを使用して、特徴量テーブルをオンラインストアに同期できます。特徴量テーブルのメタデータは、テーブルの生成元となったデータソースと、テーブルを作成またはテーブルに書き込んだノートブックとジョブを追跡します。
Databricks Runtime 13.3 LTS 以降では、ワークスペースが Unity Catalog に対して有効になっている場合、主キーを持つ Unity Catalog 内の任意の Delta テーブルを特徴量テーブルとして使用できます。Unity Catalog の特徴量テーブルを参照してください。
特徴量テーブルの特徴量は通常、一般的な計算関数を使用して計算、更新されます。
特徴量テーブルを オンラインストア に公開して、リアルタイム モデル推論を行うことができます。
FeatureLookup
多くの異なるモデルが特定の特徴量テーブルの特徴量テーブルを使用する可能性があり、すべてのモデルがすべての特徴量テーブルを必要とするわけではありません。 特徴量テーブルごとに FeatureLookup をトレーニングするには、特徴量テーブルごとにモデルをトレーニングします。 この FeatureLookup は、テーブルから使用するフィーチャを指定し、 create_training_setに渡されるラベル データに特徴量テーブルを結合するために使用するキーも定義します。
この図は、 FeatureLookup の仕組みを示しています。 この例では、 customer_features と product_featuresの 2 つの特徴量テーブルの特徴を使用してモデルをトレーニングします。 特徴量テーブルごとに FeatureLookup を作成し、テーブルの名前、テーブルから選択する特徴量(列)、特徴量を結合してトレーニング データセットを作成するときに使用するルックアップ キーを指定します。
次に、図に示されている create_training_setを呼び出します。 この API 呼び出しでは、生のトレーニング データ (label_df) を含む データフレーム 、使用する FeatureLookups 、 label、グラウンド トゥルースを含む列を指定します。 トレーニングデータには、特徴量テーブルの各主キーに対応する列が含まれている必要があります。 特徴量テーブルのデータは、これらのキーに従って入力 データフレーム に結合されます。 結果は、図に "トレーニング データセット" として示されています。
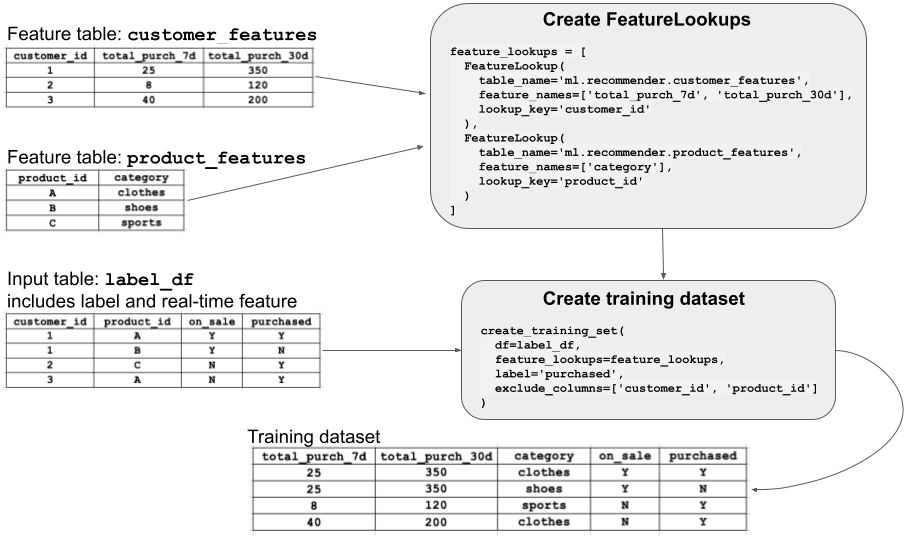
トレーニングセット
トレーニング セットは、特徴量のリストと、特徴量を検索するための生のトレーニング データ、ラベル、および主キーを含む データフレーム で構成されます。 トレーニング セットを作成するには、Feature Store から抽出する特徴量を指定し、モデルのトレーニング中にトレーニング セットを入力として提供します。
トレーニング セットを作成して使用する方法の例については、「 トレーニング データセットを作成する 」を参照してください。
Unity Catalogでの特徴量エンジニアリングを使用してモデルをトレーニングおよびログに記録すると、カタログエクスプローラ でモデルのリネージを表示できます。モデルの作成に使用されたテーブルと関数は、自動的に追跡され、表示されます。特徴量のガバナンスとリネージを参照してください。
FeatureSpec
FeatureSpec は、再利用可能な機能のセットを定義する Unity Catalog エンティティです。FeatureSpecは、特徴量テーブルとFeatureFunctionのFeatureLookupを、モデルトレーニングで使用できる単一の論理単位に結合します。
FeatureSpecは Unity Catalogによって保存および管理され、構成要素のオフライン特徴量テーブルと機能を完全に追跡します。 これにより、さまざまなモデルやアプリケーション間でのガバナンス、検出可能性、再利用が可能になります。
モデルトレーニングでFeatureSpecを使用するには、create_training_setのFeatureSpecを参照します。
時系列 特徴量テーブル (ポイントインタイムのルックアップ)
モデルのトレーニングに使用されるデータには、多くの場合、時間依存関係が組み込まれています。モデルを構築するときは、観測されたターゲット値の時点までの特徴値のみを考慮する必要があります。ターゲット値のタイムスタンプより後に測定されたデータに基づいて特徴をトレーニングすると、モデルのパフォーマンスが低下する可能性があります。
時系列特徴量テーブル には、トレーニング データセットの各行が行のタイムスタンプの時点で最新の既知の特徴値を表すことを保証するタイムスタンプ列が含まれています。 時系列特徴量テーブルは、時系列データ、イベントベースのデータ、時間集計データなど、特徴値が時間の経過とともに変化する場合に使用する必要があります。
時系列特徴量テーブルを作成するときは、主キーの時間関連列を時系列列として指定するには、引数 timeseries_columns ( Unity Catalogでの特徴量エンジニアリングの場合) または timestamp_keys 引数 (ワークスペース Feature Storeの場合) を使用します。 これにより、 create_training_set または score_batchを使用するときにポイントインタイムルックアップが可能になります。 システムは、指定された timestamp_lookup_key を使用して、タイムスタンプ時結合を実行します。
timeseries_columns 引数または timestamp_keys 引数を使用せず、時系列列を主キー列としてのみ指定した場合、Feature Store は結合中に時系列列にポイントインタイム ロジックを適用しません。代わりに、タイムスタンプより前のすべての行に一致するのではなく、時刻が完全に一致する行のみに一致します。
オフラインストア
オフライン特徴ストアは、特徴の検出、モデル トレーニング、バッチ推論に使用されます。 Deltaテーブルとして具体化された特徴量テーブルが含まれています。
オンライン機能ストア
Databricks Online Feature Store は、オンライン アプリケーションとリアルタイム機械学習モデルに特徴データを提供するための、高性能でスケーラブルなソリューションです。
Databricks Lakebase を搭載しているため、フィーチャ データへのガバナンス、リネージ、一貫性を維持しながら、フィーチャ データへの低遅延アクセスを高スケールで提供します。
Serverless Lakebase プラットフォームでオンライン ストアをプロビジョニングできます。APIを使用すると、インスタンスと読み取りレプリカを管理し、必要に応じてインスタンスをスケールできます。便利な APIs を使用して、 Unity Catalog テーブルをオンライン ストアに公開できます。これらのテーブルも、ソーステーブルへのリネージをネイティブに追跡する Unity Catalog エンティティです。
オンライン Feature Store は ベータ 段階であり、 us-central1、 us-east4、および europe-west3 (フランクフルト) リージョンで利用できます。サードパーティのオンラインストアはサポートされていません。
ストリーミング
バッチ書き込みに加えて、Databricks Feature Store はストリーミングをサポートしています。 ストリーミング ソースから特徴量テーブルに特徴量テーブルに特徴値を書き込むことができ、特徴量計算コードでは 構造化ストリーミング を利用して生データ ストリームを特徴に変換できます。
モデルパッケージ
Unity Catalogでの特徴量エンジニアリングまたはワークスペース Feature Store を使用して機械学習モデルをトレーニングし、クライアントの log_model() メソッドを使用してログに記録すると、モデルはこれらの特徴への参照を保持します。推論時に、モデルはオプションで特徴値を自動的に取得できます。呼び出し元は、モデルで使用される特徴 ( user_idなど) の主キーを指定するだけで、モデルは必要なすべての特徴値を取得します。
バッチ推論では、特徴値はオフラインストアから取得され、スコアリングの前に新しいデータと結合されます。 リアルタイム推論では、特徴値はオンラインストアから取得されます。
フィーチャー メタデータを使用してモデルをパッケージ化するには、FeatureEngineeringClient.log_model ( Unity Catalogでの特徴量エンジニアリングの場合) または FeatureStoreClient.log_model (ワークスペース Feature Storeの場合) を使用します。