Spark ステージの高 I/O
ステージが処理するデータが、クラスターが利用可能な時間内に読み取り、書き込み、またはシャッフルできる量より多いため、ステージが遅くなる可能性があります。I/O バウンドのステージを修正するには:
- ステージで処理されるデータ量を減らします。
- ステージでのデータの読み取りと書き込みを高速化してください。
- コンピュート容量を追加します。
最長のステージで歪度とspillが原因ではないことを確認した後、このページを使用してください。ステージの I/O 列は、そのステージが I/O バウンドかどうか、その場合はボトルネックが入力、出力、シャッフルのどれかを示します。
最長のステージの I/O 列を確認します。
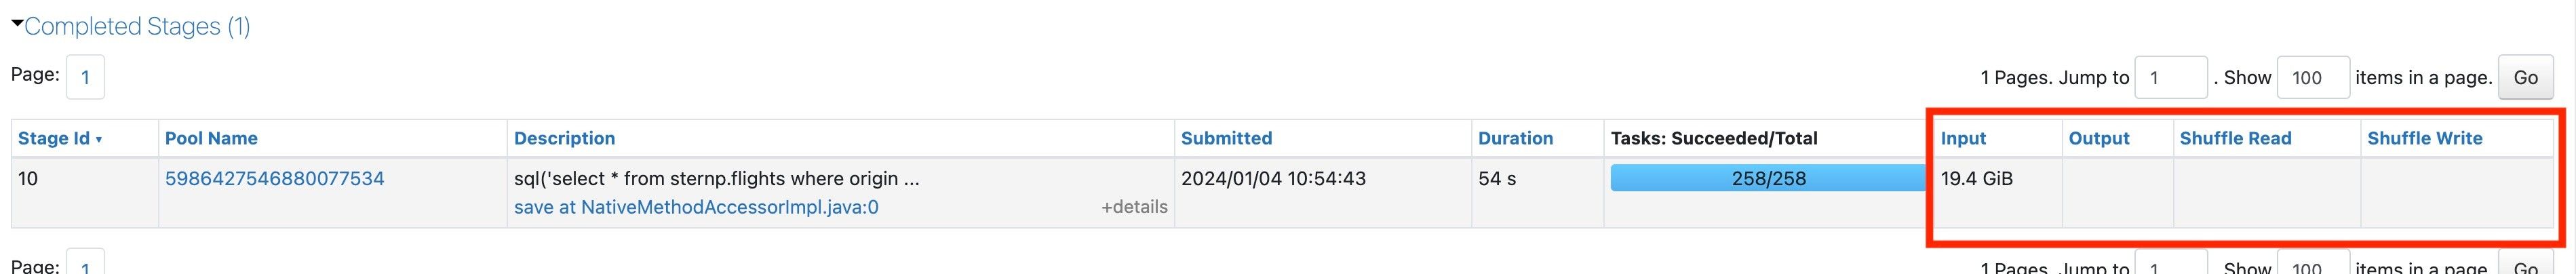
高I/Oとは?
各 CPU コアは、毎秒約 3 MB を読み書きできます。ステージの I/O が高いかどうかを確認するには、そのステージのコアあたりのthroughputをそのレートと比較します:
- ステージのI/O列の最大値を見つけます。
- その値を全ワーカーの全 CPU コアの合計数で割ります。
- 結果をステージ期間 (秒) で除算します。
結果が 1 秒あたり約 3 MB の場合、ステージが I/O バウンドである可能性があります。
高入力
入力列が大規模な場合、ステージはデータの読み取りに多くの時間を費やします。ステージが読み取るテーブルまたはファイルを見つけるには、SQL DAGで高コストな読み取りを特定するを参照してください。次に、読み取りを高速化するためにこれらのアプローチを試してください。
- データを Delta テーブルに保存します。
- リキッドクラスタリングを使用してデータスキップを改善します。
- Photonを有効にすると、特に幅の広いテーブルで読み取りを高速化できます。
- クエリーをより選択的にして、読み取るデータ量を減らしてください。
- データスキップの効果を高めるため、データLayoutを見直してください。
- ステージが同じデータを複数回読み取る場合は、ディスクキャッシュを使用します。
- ステージで結合を実行する場合、動的ファイルプルーニングが適用されるかどうかを確認してください。
- クラスターのサイズを大きくするか、Serverlessコンピュートを使用します。
高出力
出力列が大きい場合、ステージはデータの書き込みに多くの時間を費やします。次のアプローチを試してください:
-
書き換えを減らします。ステージでデータが書き換えられているかどうかを確認するには、Sparkが過剰なファイルを書き換えているかどうかの判断を参照してください。ステージで大量のデータが書き換えられている場合:
- 書き込みがMergeである場合は、Mergeを最適化します。
- 削除ベクトルを使用して、Parquet ファイルを書き換えずに既存の行を削除または変更としてマークします。
-
書き込みを高速化できる Photon を有効にします。
-
クラスターのサイズを大きくするか、Serverlessコンピュートを使用します。
ハイシャッフル
「シャッフル読み取り」列または「シャッフル書き込み」列の値が大きい場合、結合や集計のためにエグゼキューター間でデータをシャッフルするのにステージが多くの時間を費やしています。シャッフル時間を短縮するため、Databricks では、Spark がクエリープランと入力データサイズに基づいてシャッフルパーティション数を設定するよう、spark.sql.shuffle.partitions を auto に設定することをお勧めします。AQE の構成を参照してください。
高I/Oなし
I/O 列がいずれも大きくない場合、ステージが低速である他の理由があります。原因を見つけるには、I/O が少ない Spark ステージの低速化を参照してください。