スキューとスピル
スキューとspillは、単一のステージのラン時間が予想より大幅に長くなる最も一般的な原因のうち2つです。どちらもステージページに表示され、それぞれに試すべき修正方法も示されます。
ジョブで最も長いステージのステージページを開いた後に、このページを使用してください。そのステージを見つけるには、 「Spark の長いジョブを診断する」を参照してください。ステージのタスクが 1 つだけの場合は、代わりに 「タスクが 1 つの長い Spark ステージ」を参照してください。
こぼれ
Sparkの実行メモリが不足するとspillが発生します。Sparkはこのメモリをシャッフル、結合、ソート、集約に使用します。その後、Sparkはメモリからディスクにデータを書き込みますが、これにはコストがかかる可能性があります。データのシャッフル中にspillが最もよく発生します。
まず、ステージにspillがないか確認します。ステージページの上部にあるステージ詳細には、ステージにspillがある場合にspill統計が表示されます。
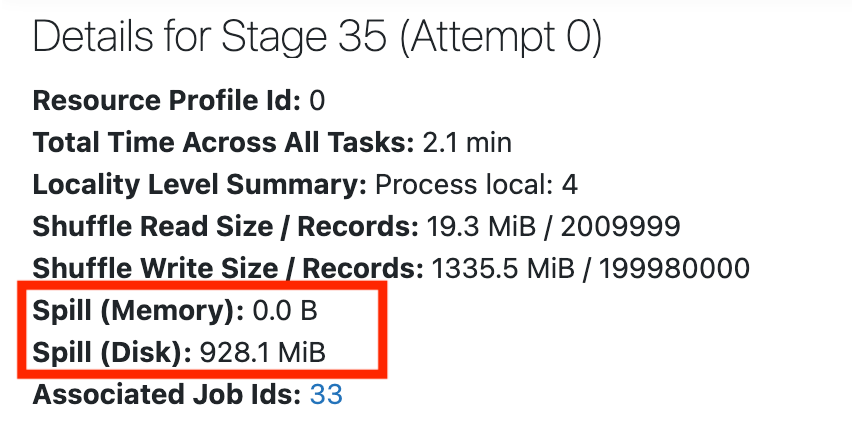
ステージの詳細には、ピーク実行メモリなどの他のメトリクスも含まれます。これらおよびその他のステージメトリクスの詳細については、Apache Sparkドキュメントのステージの詳細を参照してください。
If no spill 統計が表示されない場合は、ステージに spill がないことを意味します。ステージにspillがある場合は、次のアプローチを試してください。
- 自動最適化されたシャッフルを使用する。
spark.sql.shuffle.partitions=autoを設定して、Spark がクエリープランと入力データのサイズに基づいてシャッフルパーティションの数を選択できるようにします。AQEの構成を参照してください。 - メモリ内に保持されるデータを減らします。 クエリーが処理する行や列の数を減らします。あるいは、文字列、配列、マップ、構造体のような大きな列のサイズを減らします。「DATA_SPILL」を参照してください。
- エグゼキューターメモリ容量を増やします。 総エグゼキューターメモリ容量により、Sparkがディスクにspillする前にメモリに格納できるデータの量が決まります。より多くのメモリを持つインスタンスを使用します。複数のテーブルにまたがる結合を伴う複雑なバッチETLの場合、シャッフルされるデータの量を減らすために、より少なく大きなワーカーを使用します。複雑なバッチETLを参照してください。
- 構造化ストリーミングのバッチサイズを制限します。 ステージが構造化ストリーミング クエリーの一部である場合は、大きなマイクロバッチが spill を引き起こさないように入力レートを制限します。Databricksでの Structured Streaming のバッチ サイズの構成を参照してください。
スキュー
スキューは、1つまたはいくつかのタスクが他のタスクよりもはるかに時間がかかる場合に発生します。これらのタスクが終了する間、他のコアはアイドル状態になり、クラスターの使用率が低下し、ジョブが長くなります。
スキューを確認するには、下にスクロールして サマリーメトリクス を表示します。 最大 期間を75パーセンタイル期間と比較します。次のスクリーンショットは、75パーセンタイルと 最大 が同じである正常なステージを示しています。
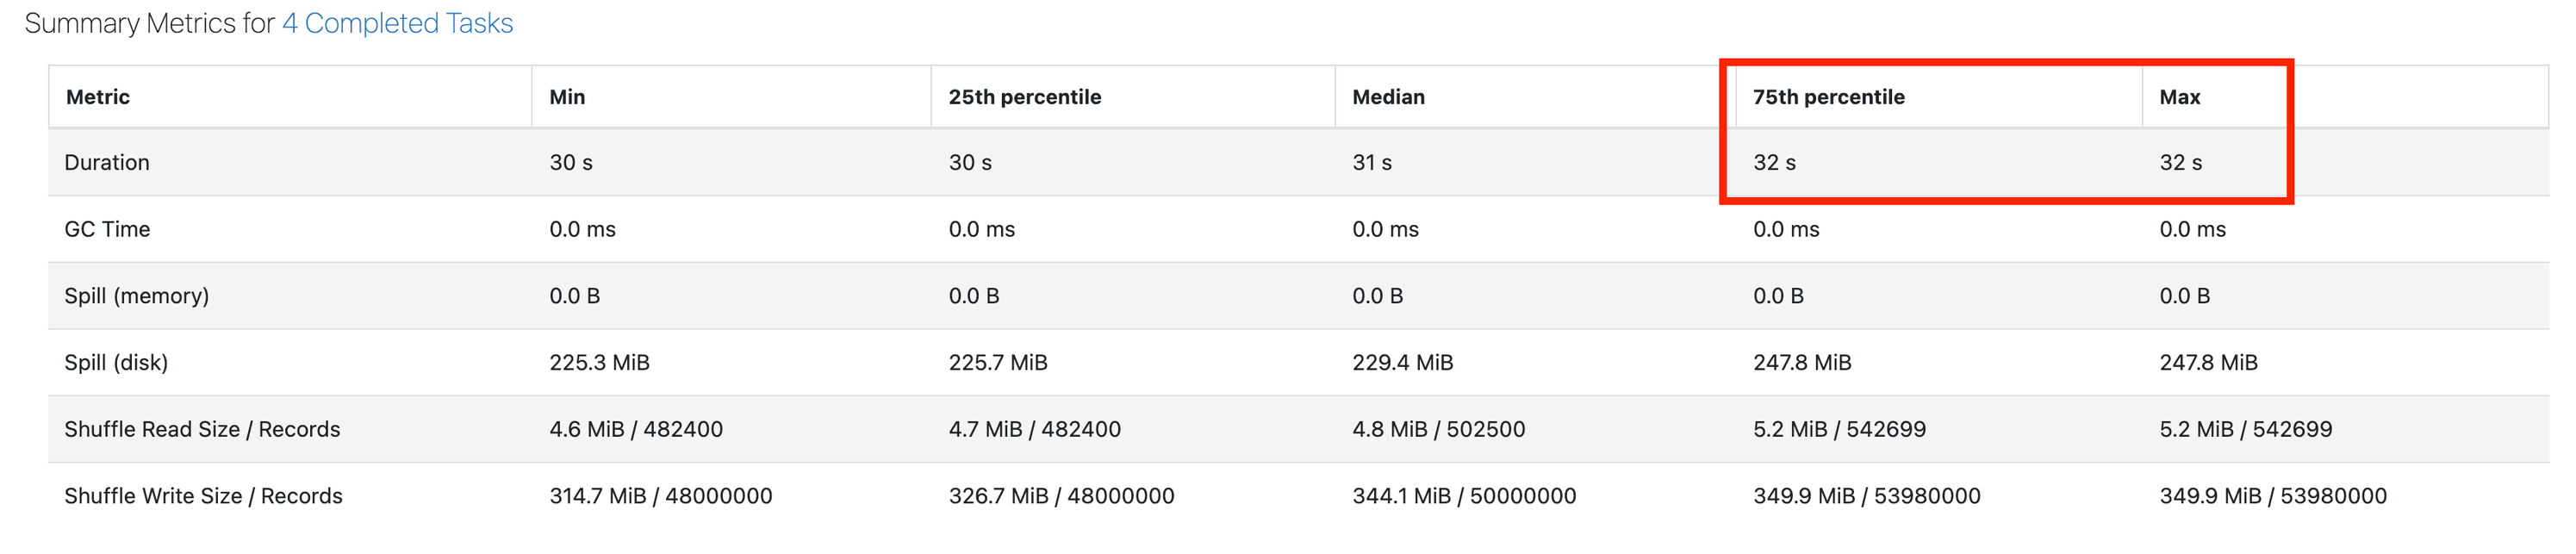
最大実行時間が 75パーセンタイルより 50%以上長い場合、ステージにスキューがある可能性があります。スキューを修正するには、次のアプローチを試してください。
- AQE がスキューを処理するかどうかを確認します。 スキューが発生したステージが ソートマージ結合 またはシャッフルハッシュ結合の一部である場合、適応型クエリー実行(AQE)は、パーティションがそのサイズしきい値の両方を超えた場合にのみ、スキューされたパーティションを自動的に分割します。ブロードキャスト結合はスキュー最適化されず、結合の種類によってAQEがどの側を最適化できるかが決まります。AQE がデータ スキューを検出しなかったのはなぜですか?を参照してください。
- AQEスキューthresholdを調整します。 スキューが発生しているパーティションがthresholdよりも小さい場合は、
spark.sql.adaptive.skewJoin.skewedPartitionFactorおよびspark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytesを調整してください。スキュー結合の動的な処理を参照してください。 - スキューキーのソルト化または事前集計。 結合または集約で少数のキー値がデータの大部分を占めている場合は、偏ったキーにランダムなバケット接尾辞を追加し、その後、2段階でグループ化と集約を行います。データのスキューを処理するを参照してください。
- ソーステーブルをクラスター化します。 スキューが格納されているテーブルのレイアウト方法に起因する場合は、データのスキューが大きいテーブルに適したリキッドクラスタリングを使用します。「テーブルにリキッドクラスタリングを使用する」を参照してください。
- 出力パーティションを再バランスします。 スキューが発生しているステージがテーブルに書き込む場合、
REBALANCEヒントを使用してください。Sparkは、どのパーティションも大きくなりすぎないように、スキューされた出力パーティションを分割します。AQE が有効になっていない場合、Spark はヒントを無視します。パーティショニングのヒントを参照してください。
スキューやこぼれはありません
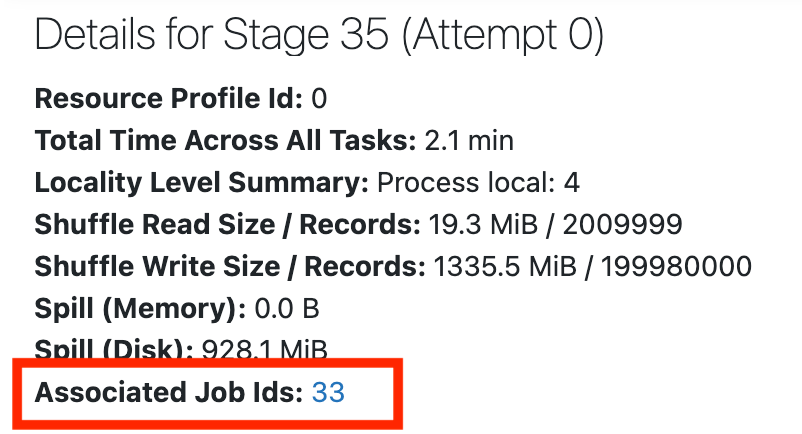
ステージにスキューや spill がない場合は、I/O 境界かどうかを確認してください。ジョブページに戻るには、ステージページの上部までスクロールして、 関連するジョブID をクリックします。
次にSpark ステージの高 I/O を参照してください。