Databricks Voicesのコンテンツは、独自の学習とDatabricksの知識を共有したいDatabricksの従業員によって作成および公開されています。このコンテンツは、このサイトの他のセクションにある公式のDatabricks製品ドキュメントを補足するものです。
宣言型オートメーションバンドルを用いたAzure DevOps:ステップバイステップの統合ガイド
信頼できる継続的インテグレーション/継続的デリバリー(CI/CD)プロセスを確立することは、Azure Databricks のデータおよび AI ワークロードのライフサイクルを効果的に管理するために極めて重要です。しかし、多くのセットアップオプションと絶えず進化しているプラットフォームでは、「どこから起動すればよいのでしょうか?」という大きな疑問があります。この包括的なブログは、複雑さを解消し、Azure Databricks の推奨される CI/CD アプローチの概要を説明します。

共有インフラストラクチャで複数のチームをサポートする場合でも、最小限の管理オーバーヘッドで強力なガバナンスをサポートする最新のベストプラクティスに焦点を当てています。これはDatabricksワークスペースUIで作業する開発者向けですが、Visual Studio CodeのようなIDEsも完全にサポートしています。
推奨されるアプローチでは、デプロイに宣言型オートメーションバンドル(DAB; 旧称:Databricksアセットバンドル)を使用します。バンドルは、バージョン管理のためのDatabricks Gitフォルダー、自動化のためのAzure DevOps、およびDatabricks接続のためのAzure DevOpsサービス接続とシームレスに統合されます。このブログの最後に、参考に、DevOpsとDatabricksを統合するためのDevOpsサービス接続とDatabricks OIDCアプローチを比較しています。
最後に、DevOpsでシンプルで効果的なトランクベースのブランチ戦略に従います。機能Branchのプルリクエストが承認され、mainにMergeされると、ステージングが自動的にデプロイされます。mainからの本番運用デプロイメントは、成功したステージングデプロイメントに依存し、実装する追加の承認ステップが必要になります。

このブログでは幅広いトピックを扱っていますが、最適な選択肢をガイドすることで、長期的には時間と労力を大幅に節約できます。コンテンツは3つの部分に分かれています。
- インフラストラクチャとガバナンス要件の調整
- バージョン管理されたバンドル開発プロセスの設定
- ステージングおよび本番運用にデプロイするための Azure DevOps パイプラインのセットアップ
パート1:インフラストラクチャとガバナンスの要件を揃える
Databricks ワークスペース、デプロイメント環境、Unity Catalog、DevOps プロジェクト、Git リポジトリに必要な分離および組織化のレベルについては、すべての組織が決定する必要があります。すべての組織に当てはまる唯一の正しい答えはありません。この記事のトピックに移る前に、考慮事項に触れることしかできません。
トピック | 考慮事項 | この記事では |
|---|---|---|
環境 | 3つが一般的ですが、2つを使用する場合もあれば、4つ以上を使用する場合もあります。 | dev (開発)、 staging (ステージング)、 prod (本番)を使用します。 |
Databricksワークスペース | 一般に、ワークスペースは環境と整合しています。より大規模な組織では、ビジネスユニットを個別のワークスペースに整理することもできます。3つのワークスペースの利点は、ワークスペース管理者が「dev」ワークスペースでプレビュー機能やその他の設定を自由に有効にでき、ステージングおよび本番環境のワークロードに影響を与えないことを確認できることです。 | 複数の独立したチームが、妥当なガバナンスを備えた2つのワークスペース( |
カタログ | Unity Catalogでデータを整理するための多くの戦略があります。 | カタログに |
Azure DevOpsプロジェクト | 小規模な組織では単一のプロジェクトを使用して設定を簡素化しますが、大規模な組織では複数のプロジェクトが必要になり、コード リポジトリと承認者の間に厳密な境界を設ける可能性があります。 |
|
Gitリポジトリ | 単一の「モノリポジトリ」と、複数のチームまたはドメインベースのリポジトリにはそれぞれ長所と短所があります。 | チームベースの DevOps プロジェクトを既に選択しているため、単一の default リポジトリ を使用します。 |
注:このブログで概説されている例と構成戦略に従うことで、プロセス全体がどのように効果的に連携するかを理解することをお勧めします。次に、学習した内容、組織のガバナンスと組織のニーズがどのように異なるかを検討し、必要な変更を加えることができます。これらの選択を終えたので、組織の戦略を目で見て確認してみましょう。

「企業」組織 (BU1) 内で、チーム 2 は人事データを処理し、それ以外のすべてはチーム 1 が処理します。これらの2つのチームは、共有のbu1-devおよびbu1-prodワークスペースで独立して作業します。これがうまく機能するためには、ワークスペース管理者として機能するために、1人または複数の個人が両方のチームから信頼されている必要があることに注意してください。これが調整可能であれば、インフラストラクチャの管理が簡素化されます。それができない場合は、チーム1とチーム2をそれぞれ独自の開発/本番ワークスペースに分割する必要があります。
将来的には、別の部門 (BU2) が買収される可能性がありますが、その部門は同じ Entra ID ディレクトリを共有しつつ、別のワークスペースと DevOps インフラストラクチャを持つことを選択するかもしれません。問題ありません。それが、Unity Catalogでカタログ名にプレフィックスを付ける理由です(例:bu1_dev、bu2_dev)。
各DevOpsプロジェクト内の「モノリポジトリ」アプローチに合わせて、宣言型オートメーションバンドルを使用してコードをさらに整理します。このブログでは、単一の「Hello World」バンドルを使用して、推奨される開発および CI/CD プロセスがどのように機能するかを説明します。実際には、特定のデータドメイン (財務など) に対して多くのバンドルがあり、これらはすべて同じリポジトリでバージョン管理できます。ステージングと本番運用デプロイメントには単一のDevOpsパイプラインを使用しますが、異なるパイプライン戦略を選択することもできます。

パート 2 - バージョン管理されたバンドル開発プロセスの設定
Databricks のバンドルと Git フォルダーは Azure DevOps とシームレスに連携し、CI/CD プロセスを成功に導きます。さあ、始めましょう。
初期 Azure DevOps セットアップ
これは非常に単純で、チームのAzure DevOpsプロジェクトを作成し、リポジトリを初期化する手順で構成されます。Branchを作成する必要はありません。組み込みの main Branch を使用し、組み込みのGit統合UIを使用してDatabricks内に feature Branch を作成します。
プロジェクトを作成し、メインブランチを初期化してから、リポジトリに移動し、次のステップのためにリポジトリURLをクリップボードにコピーします。

リポジトリにアクセスするためのリンク済みアカウントの作成
Databricksワークスペースでは、各開発者が独自の Azure DevOps (Microsoft Entra) リンクアカウントクレデンシャル を作成し、Gitリポジトリへの認証を行うことができます。これを行うには、dev ワークスペースの [設定] > [ユーザー] > [リンクされたアカウント] ページに移動します。本番ワークスペースではGit統合が必要ないため(DevOpsがコードを本番環境にプッシュするため)、これを行う必要はありません。

リポジトリを指すGitフォルダを作成する
各開発者は、 ホーム ディレクトリに、チームのリポジトリを指す独自の Gitフォルダ を作成します。このステップは、各開発者が一度だけ実行します。 作成 > Gitフォルダ をクリックします。

Azure DevOpsプロジェクトからリポジトリURLを貼り付け(クリップボードに残っているはずです)、 Gitフォルダの作成 をクリックします。

Git フォルダーには、ワークスペース UI のこの 2 つのボタンなど、特別なプロパティがあります。

[エディタで開く] をクリックすると、新しいブラウザtabが開き、Gitフォルダが新しい「フォーカス」 オーサリングモード で表示されます。これについては、少し後で説明します。
 このビューは今は使用しないので、開いたばかりの ブラウザtab を閉じます。
次に、以下に示す Git Branchボタン をクリックします。

Git統合UIで、 Branchの作成 をクリックし、フィーチャーブランチの名前(features/initial_work_on_hello_worldなど)を割り当てて、 作成 をクリックします。

Git統合ダイアログの右上にある「X」ボタンをクリックして閉じます。Microsoft Entraの認証情報を使用して、Databricks Git統合はAzure DevOpsのリポジトリにBranchを作成し、下図のようにワークスペースのUIでそのBranchに切り替えました。

ワークスペースUIのナビゲーション
2026年4月現在、この記事で示されているメニューの動作に影響を与えるUIプレビューが2つあります。ワークスペース管理者に プレビュー に移動し、「tree」を検索するよう依頼してください。defaultでは、新しい「作成」コンテキストプレビュー(以下の最初もの)が有効になっていますが、ファイルブラウザの新しいツリービューは有効になっていません。記事に沿って操作できるように、また、両方ともGitフォルダとアセットバンドルを扱いやすくするために、両方を有効にすることをおすすめします。参考としてドキュメントへのリンクを以下に示します。

最初のバンドルを作成し、「Dev」にデプロイする
Git フォルダで、 作成 をクリックし、 バンドル を選択します。

Gitフォルダ内のバンドルの開発コピーを整理するには、さまざまなアプローチがあります。以下に示すようなバンドルのフラットリストでも問題ありません。Gitフォルダの下にフォルダを作成して、その中にバンドルを整理することもできます。

このブログの目的として、 バンドル名 に hello_world のような名前を入力し、 空のプロジェクト オプションを選択します。 作成 をクリックすると、バンドルのアドオンリソースのリストが表示されます。 新しいジョブ定義の追加 を選択し、 Update Event Table のようなジョブタイトルを入力します。
「追加してデプロイ」ボタンはクリックしないでください。代わりに、 下矢印をクリック して 追加のみで、後でデプロイ を選択してください。誤って「追加してデプロイ」をクリックしても問題ありませんが、まだ何も行う必要のないジョブが開発環境にデプロイされました。

コードを追加し、ジョブを設定する
プロジェクトにコードを追加して、CI/CDプロセスが実際に動作することを確認してみましょう。このブログの目的のために、この場所から Hello_World.ipynb ノートブックをdownloadし、以下に示すようにバンドルフォルダにインポートできます。
以下に示すように、必ず hello_world アセットバンドルフォルダ(リソースフォルダではなく)にインポートしてください。

job.yml ファイルをまだ開いている状態で、 行のコメントを切り替え キーの組み合わせを使用して、ジョブYAMLファイルの8〜19行目のコメントを解除します(キーボードショートカットのリストは、以下に示すようにコンテキストメニューから取得できます)。行のコメントを解除した後、黄色で示された2つの変更を行います。パスは大文字と小文字が区別されますので注意してください。ジョブの最初のタスクの名前を変更し、インポートしたばかりのノートブックを指すようにしました。

Hello_World ノートブックを開き、いくつか注意点を確認します。最初のセルは、defaultなしで“catalog”と呼ばれるウィジェットを定義しています。インポートしたノートブックは上部にカタログウィジェットをレンダリングしていますが、空であるため、書き込むカタログを入力できます。このラボでは、bu1_dev というカタログを作成します。
以下に示すように、 「catalog」 ウィジェットフィールドの値を入力します。 「job_run_id」 というウィジェットにはdefault値がないことにも注意してください。

上部にある ラン all ボタンをクリックして、ノートブックを今すぐ実行してください。この記事では Serverless コンピュートを使用する必要があります。これにより、クラスターが起動するのを待つ必要がなくなります。

出力とカタログエクスプローラで、時刻とコードを実行したユーザーを含む 1 行が挿入されたことに注目してください。

ワークスペースで、バンドルの デプロイ ボタン(「ロケット」のアイコン)をクリックし、 バンドルリソース リストの読み込みが終了するまで待機してから、 デプロイ ボタンをクリックします。

更新されたジョブ定義をデプロイすることを確認するために、もう一度 デプロイ をクリックします。

おめでとうございます!開発ターゲットに正常にデプロイされたというメッセージが表示されます。
サイドナビゲーションの ワークスペース をクリックして、何がどこにデプロイされたかを確認します。

Databricks は、アセット バンドルを Home/.bundle フォルダにデプロイします。これは、以下で青色で強調表示されている 開発デプロイメント環境 で表されます。現時点では、Azure DevOps バージョン管理には何もありません。

サイドナビゲーションの ジョブ & パイプライン をクリックします。
バンドルのデプロイによってジョブも作成されました。ジョブ タイトルの先頭に [dev your_user_id] が付加されることに注意してください。
ジョブを開き、 「タスク」 tabをクリックします。以下の情報を確認してください。

メッセージ(1)および(4)は、このジョブがバンドル展開によって作成されたため、UIで編集すべきではない(編集は可能ですが、次回バンドルをデプロイする際に編集内容は上書きされます)ことを示しています。ノートブックタスク(2)の名前は、Update Event Table.job.ymlファイルで編集した内容と一致しています。ジョブ.ymlファイルで指定したノートブックパス(3)が使用されます。ジョブは、あなた(5)として実行するように設定されている。現在、ジョブパラメーター(6)は表示されていません。これについては次に説明します。UIに 「ソースとの接続を解除」 (7)ボタンがあります。
ソースリンクされたデプロイメント は、バンドル デプロイメントのオプション機能で、開発デプロイメントではdefaultで有効になっています。開発ジョブがワークスペースのHome/bu1-team1/hello_world folderからノートブックを参照するため、これは便利な機能です。コピーは開発 (Home/.bundle/hello_world) の バンドルデプロイメントフォルダ にプッシュされません。開発でのソースリンクされたデプロイメントに便利なのは、 アセットバンドルを再デプロイせずに 、ノートブックを反復的に修正し、ジョブUIからジョブを再実行できることです。
ラン tabに戻り、 今すぐ実行 ボタンをクリックします。 Serverless ジョブ コンピュート を使用すると、ジョブ クラスターが起動するのを待つ必要はありません。

ノートブックがカタログ変数の値を見つけることができないため、ジョブは失敗します。ノートブックを手動で実行したときは、カタログウィジェットに値を入力しましたが、ジョブからノートブックを実行したときは、カタログウィジェットが空で、最初のセルにもdefault値が指定されていませんでした。
開発、ステージング、本番の各環境でこのノートブックを実行できるようにしたいので、カタログのdefault値は設定しません。それが実行されている環境に基づいて、特定のカタログ名をジョブに送信したいと考えています。それについて次に構成しましょう。
ノートブックに渡されるカタログ名のパラメータ化
このセクションでは、まもなく download する 2 つのファイルを使用します。まず、それらがどのように連携するかを確認しましょう:
-
バンドル構成 (job.yml) - カスタム変数 catalog_var とそれに対する環境固有の値( bu1_dev 、 bu1_stg 、 bu1_prd )を定義します。これには、デプロイ環境の ターゲット (開発、ステージング、本番)を定義することも含まれます。
-
ジョブ構成 (job.yml) - デプロイメント中にバンドル変数から値を受け入れるジョブパラメーター catalog を定義し、ジョブパラメーターをノートブックで利用できるようにジョブタスク base_parameter を構成します。これらのトピックの情報については、上記の用語の背後にあるリンクをクリックしてください。視覚的には、変数/パラメーターの配線は次のようになります。

ご覧のとおり、バンドル構成ファイル (databricks.yml) には、1行目から12行目に一般的な設定情報が含まれ、14行目から環境 ターゲット が含まれています。各ターゲット(開発、ステージング、本番)は、その環境のバンドルの特性を定義します。これには、Databricks ワークスペースにアクセスする方法、渡す変数名/値、環境に使用する デプロイメント モード が含まれます。
バンドル変数 catalog_var を定義し、「dev」ターゲット環境にデプロイするときに bu1_devに設定します。ステージング環境では bu1_stgに設定します。これらの環境ターゲットは、ユーザーが定義します。任意の数を作成し、好きな名前を付けることができます。ただし、後述するように、バンドルの検証ステップとデプロイステップについては、 バンドルのターゲット名が Azure DevOps パイプラインで指定された値と一致している必要があります 。
デプロイメントモード設定には、開発と本番運用の2つの値があります。devターゲットは開発モードを使用し、ステージングと本番運用は両方とも本番運用モードを使用します。開発モードでは、デプロイされたジョブに [dev <your_user_name>] というプレフィックスが付けられるため、自分と他のメンバーが異なる環境で同じバンドル/パイプラインのコピーを使用している場合に区別しやすくなります。開発モードでは、前述の ソースリンクされたデプロイメント も有効になるため、バンドルの配線とノートブックのコードの反復処理が容易になります。ここでは、バンドルの mode: 設定の動作に関する完全なリファレンスを示します。

時間を節約するために、ここでは私たちが従っている例の完成したコードを紹介します。これらをEvent Table ジョブ.ymlおよびdatabricks.ymlファイルにコピーします。
Home/bu1-team1/hello_world/リソース/Update Event Table.job.yml
以下のハイライトされた行にあなたのEメールを指定してください。
コードには、イベントテーブルに書き込めるように ジョブ ラン ID をキャプチャする 2 番目のパラメーターが含まれていることに注意してください。構文 {{job.run_id}} は、ラン ID を動的にキャプチャします。これを文字列 job_run_id_ に追加します。このパラメーターがテーブルに書き込まれるときに表示されます。必要に応じて、パラメーターの定義を変更し、プレフィックスを削除できます。このパラメーターはジョブによって動的に定義されるため、catalog_var のようにバンドル変数を作成する必要はありません。
resources:
  jobs:
    Update_Event_Table:
      name: Update Event Table
      queue:
        enabled: true
      parameters:
        - name: catalog
          default: ${var.catalog_var}
        - name: job_run_id
          default: 'job_run_id_{{job.run_id}}'
      tasks:
        - task_key: notebook_task_1
          notebook_task:
            notebook_path: ../Hello_World.ipynb
            base_parameters:
              catalog: ${var.catalog_var}
              job_run_id: 'job_run_id_{{job.run_id}}'
      email_notifications:
        on_failure:
          - your_email@example.com
      trigger:
        periodic:
          interval: 1
          unit: DAYS
ホーム/bu1-team1/hello_world/databricks.yml
環境に合わせてワークスペースURLを編集し、必要に応じてカタログ名を変更します。このブログでは、 開発 と ステージング に同じワークスペースを使用していますが、必要に応じて開発/ステージング/本番に3つの別々のワークスペースを使用することもできます。以下の編集を行うだけです。
# Declarative Automation Bundle (DAB) configuration; more info here:
# https://docs.databricks.com/en/dev-tools/bundles/settings.html
bundle:
  name: 'hello_world'

include:
  - resources/*.yml
  - resources/*/*.yml
# Define custom variables; more info here:
# https://docs.databricks.com/en/dev-tools/bundles/reference#variables
variables:
  catalog_var:
    description: Custom variable containing the target catalog
    default: ''

targets:
  # TODO - adjust the catalog names and workspace URLs to match your deployment
  # The "dev" target used by the bundle deploy feature
  dev:
    mode: development
    default: true
    variables:
      catalog_var: bu1_dev
    workspace:
      host: https://adb-###########.#.azuredatabricks.net

  # The "staging" target used by Azure DevOps
  staging:
    mode: production
    variables:
      catalog_var: bu1_stg
    workspace:
      host: https://adb-###########.#.azuredatabricks.net
      root_path: /Workspace/devops/staging/bu1-team1/.bundle/${bundle.name}

  # The "prod" target used by Azure DevOps
  prod:
    mode: production
    variables:
      catalog_var: bu1_prd
    workspace:
      host: https://adb-###########.#.azuredatabricks.net
      root_path: /Workspace/devops/prod/bu1-team1/.bundle/${bundle.name}
databricks.ymlファイルのワークスペースURLを更新した後、Webブラウザの 再読み込み ボタンをクリックしてください。
これは、ワークスペース URL のプレースホルダーテキスト (##########) でファイルをソースし、バンドル UI が編集を行うとすぐにそれを認識するためです。これにより、次のステップで混乱が生じ、デプロイ先の有効なターゲットがないと判断されます。そのため、編集を行ってWebブラウザでワークスペースUIを再読み込みしたら、次のステップに進んでください。
バンドルの デプロイ ボタンをクリックし、 ターゲット プルダウンメニューをクリックします。

他のワークスペースへのデプロイはサポートされていないというメッセージに注意してください。実際、これはバンドルデプロイ機能がローカルに、つまり現在いるワークスペースにのみデプロイするように設計されていることを意味します。
bundle deployボタンを使用して、バンドルを開発ターゲットにローカルにプッシュする場合のみ、この設定を使用します。Azure DevOpsを使用して、バンドルをステージング環境と本番環境にデプロイします。
Escキー を押してドロップダウンメニューを閉じ、 [デプロイ] ボタンをクリックします。

もう一度 デプロイ をクリックして、以下の出力メッセージを確認します。

DABが開発環境にデプロイされたら、ジョブページに移動し、ランボタンをクリックしてジョブを起動します。起動後にジョブをクリックすると、実行中の状態を確認できます。

完了したら、ジョブをクリックすると、カタログとジョブ実行IDのパラメーターが期待通りに作成されて設定され、コードが bu1_dev.default.test_events テーブルに行を追加したことがわかります。

開発環境でコードが動作するようになったら、Gitにコミットしましょう。
「ワークスペース」(「フォルダ」)ボタンをクリックし、新しいワークスペースUIに慣れるまで数分時間を取ってください。「すべてのファイル」ボタンをクリックしてから、その横の「フォルダー」ボタンに戻ります。これは単に、DABバンドルフォルダにいるかどうかを切り替えるだけであることに注意してください。また、右側に開いているファイルtabにも注目してください。異なるフォルダー/サブフォルダーにあっても、一度に複数のファイルを開き、左側のフォルダー構造をナビゲートせずにそれらの間を切り替えることができるのは便利です。

準備ができたら、バンドルフォルダの横にある Git ボタンをクリックします。

コメントを追加して、最初のDABプロジェクトで commit&プッシュ をクリックします!

画面上部のメッセージで、 プルリクエストを作成 Linkをクリックして、ここからプルリクエストを作成すると便利です。これで Azure DevOps に直接移動し、プルリクエストの詳細を入力できます!

作成 をクリックしてPRを作成し、ここで停止します。
Azure DevOps デプロイメントパイプラインをセットアップしましょう。このように、DevOps に移動して PR を承認してマージすると、新しい DevOps パイプラインが自動的に初期の hello world コードをステージングにデプロイします。
パート 3 - CI/CD 用の Azure DevOps デプロイパイプラインの作成
復習として、CI/CDの要件は次のとおりです。
-
承認された開発者のPRは main にMergeされ、自動的にステージングにデプロイされる必要があります。ここで、Mergeされたコードをデータプラットフォームのより広いコンテキストでテストできます。これには、本番環境へのプロモーションを待機している他の承認された変更も含まれる可能性があります。
-
その後、さらなる承認を経て、メインBranchが本番環境にデプロイされます。
まず、ステージングプロセスをセットアップします。これには、DevOps サービス接続 の作成、それを Entra ID 管理の Databricks Service Principal (SP) へのマッピング、ステージング用のワークスペース デプロイメントフォルダ の作成、およびそのフォルダと Unity Catalog の bu1_stg カタログ に対する SP の権限付与が含まれます。本番環境でもこのプロセスを繰り返します。次に、DevOps 変数グループ 、本番 環境 のゲート/承認者、およびこれらすべてをまとめて実行する パイプライン を作成します。その後、テストできます!
次に、記載されている場合を除き、2回実行するステップの概要を示します(ステージングで1回、本番環境で1回)。
ステップ | ここでは | Whatとは | 理由 |
|---|---|---|---|
1 | Azure DevOps > プロジェクト設定 |
| DevOpsとAzure Databricks間の安全で柔軟な接続を促進し、バンドルをステージング環境および本番環境にデプロイします。新しいDatabricks OIDCベースのアプローチとの比較については、この記事の最後のトピックを参照してください。 |
2 | Azureポータル |
| |
3 | Databricks ワークスペース > 設定 |
| これは、DevOpsによってデプロイされたリソースの所有者になります。このプリンシパルにデプロイフォルダーへの書き込みアクセス権とUnity Catalogへの権限を付与する必要があります。 |
4 | Databricks ワークスペース > フォルダ | SPと | チームベースのフォルダーにデプロイすることで、必要に応じて各チームがデプロイされたコードを表示できるように権限を設定できます。 |
5 | Databricks ワークスペース > カタログ | Unity CatalogでSPと他のグループに適切な権限を与えます。 | SPによって作成されたテーブルとスキーマは、SPによって所有されます。 |
6 | Azure DevOps > ライブラリ | 各ステージの変数グループを作成します | これらは、ステージのワークスペースのURLを持つ変数 |
7 | Azure DevOps > 環境 | これは「prod」のみに対して作成します。 | これは、本番デプロイメントの承認ゲートを設定するために使用されます。 |
8 | Azure DevOps > リポジトリ | パイプラインコード用の「/.cicd」などのルートフォルダを作成します。 | これにより、パイプラインコードとバンドルコードが分離されます。このルートフォルダー内のファイルのコード変更には、特別な承認者を割り当てることを検討してください。 |
9 | Azure DevOps > パイプライン | hello_worldプロジェクトのリリースパイプラインを作成する | これにより、必要な承認後にコードがステージング環境および本番環境にデプロイされます。 |
10 | 試してみてください! | ステージングおよび本番カタログのイベントテーブルに書き込まれたメッセージを確認する | バンドルとデプロイパイプラインをどのように構成するかを検討できます。1つのパイプラインに複数のバンドルをデプロイすることも、より細かく制御するために1:1に保つこともできます。 |
ステージングサービス接続とアプリ登録を作成する
DevOps プロジェクトの プロジェクト設定 > パイプライン > サービス接続 に移動し、 サービス接続の作成 をクリックします。
Azure Resource Manager オプションを選択し、 次へ をクリックします。

重要! IDタイプ については、2つのオプションが表示されます。
以下に強調表示されている App registration or managed identity (manual) オプションを選択します(推奨としてタグ付けされているオプションは 選択しないでください )。
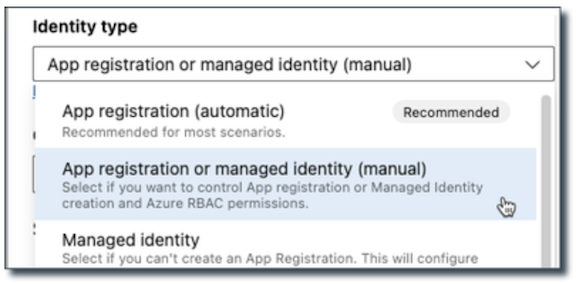
これにより、Azureポータルで アプリ登録 を明確に指定し、DevOps サービス接続 にバッキングを提供できます。これが重要なのは、Azure アプリ登録の名前が Databricks の Service Principal の名前と同期され、データチームが Unity Catalog とワークスペース リソースの権限を付与する際に検索することになるからです。
他のオプションを選択した場合、アプリ登録名はAzureによって<devops_org>-<project>-<GUID>として自動的に生成され、それがステージング用か本番用かを示すものはありません。名前は変更できず、後で権限を割り当てることが困難になります。この記事で推奨する手動アプローチは、もう少しステップが必要ですが、最適なオプションです。
注:どちらの方法でも、Azureポータルでアプリ登録を作成する必要があります。この権限がない場合、エラーが発生し、権限のある誰かと共にこれらのステップに取り組む必要があります。
[アプリの登録またはマネージド ID (手動)] を選択し、 [パート 1: 基本] セクションに [サービス接続名] (例: bu1-team1-staging-svc-conn)、説明、ディレクトリ (テナント) ID を入力して、 [次へ] をクリックします。
これで、 パート2:アプリ登録の詳細 に移動します。
ヒント: テナントIDを見つけるには、DevOpsポータルバナーバーのユーザーIDの丸をクリックし、 [ディレクトリの切り替え] リンクをクリックします。テナント ID は、現在のディレクトリの下にある文字列になります。

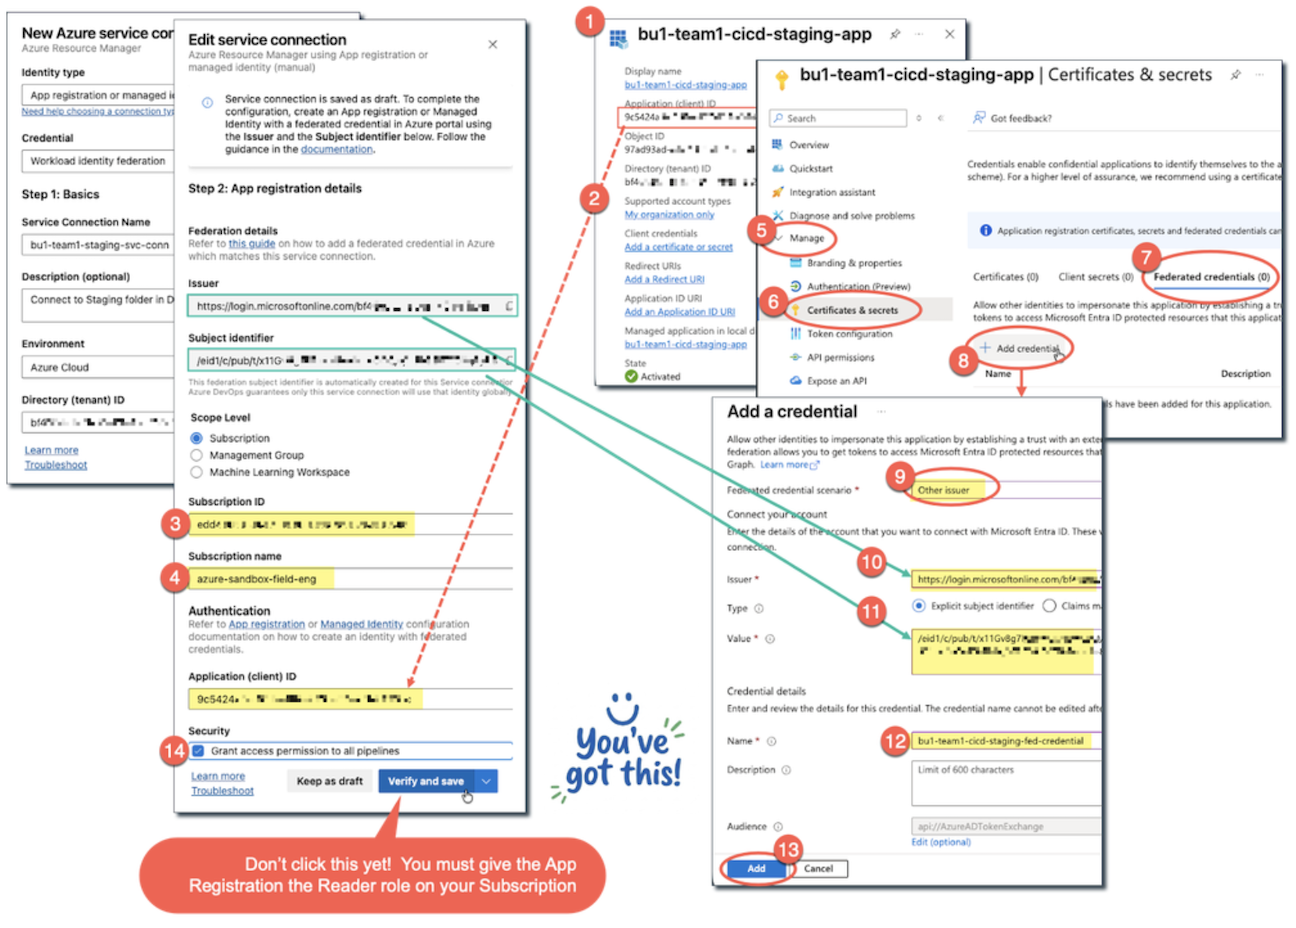
この時点で、パート2の画面を開いたままにし、別のtabでAzure Portalを開く必要があります。以下のステップに従って、下の画像で図解されていることを確認できます。
- Azureポータルで アプリの登録 (例:
bu1-team1-cicd-staging-app) を作成します。 - アプリケーション ID (以前はクライアント ID と呼ばれていました) をコピーし、DevOps サービス接続パート 2 フィールドの アプリケーション (クライアント) ID とラベルが付いたフィールドに追加します。
- その間に、 サブスクリプションID を入力してください。サブスクリプションIDは、Azureポータルで「サブスクリプション」を検索して取得できます。
- サブスクリプション名 を入力します - まだ [検証して保存] ボタンはクリックしないでください。
- Azureポータルのアプリの登録ページに戻り、左側の 管理 をクリックします。
- 次に、 証明書とシークレット をクリックします。
- フェデレーション資格情報 tabをクリックします。
- [資格情報の追加] をクリックします。
- 「 他の発行者 」を選択します。
- パート2 のサービス接続から 発行者URL をコピーし、 発行者 フィールドに貼り付けます。
- Subject identifier をコピーし、 Value フィールドに貼り付けます。
- 認証情報の 名前 を入力します(例:
bu1-team1-cicd-staging-fed-credential)。 - [ 追加 ] をクリックします。
- サービス接続画面に戻り、 すべてのパイプラインにアクセス許可を付与する ボックスをオンにします。これは、
bu1-team1DevOps プロジェクトのすべての DevOps パイプラインを意味するため、問題ありません。物事を別の方法で整理している場合は、後でいつでもこの接続へのアクセスを許可できます。
確認と保存 はまだクリックしないでください! サブスクリプションの読み取り権限をアプリ登録に付与する必要があります。誤ってクリックした場合は、エラーメッセージを慎重に確認してください。パート1の作業が下書きとして保存されたことがわかります。必要なステップを実行した後、戻ってパート2を完了できます。
Azureポータル に移動し、サブスクリプションを見つけます。 アクセス制御(IAM) に移動し、 ロールの割り当ての追加 をクリックします。名前の下の 閲覧者 をクリックし、 次へ をクリックします。 アクセス権の割り当て オプションを ユーザー、グループ、またはService Principal に設定したまま、 メンバーの選択 リンクをクリックします。 Service Principal を見つけます(注:アプリの登録によって、バックグラウンドで同じ名前、例:bu1-team1-cicd-staging-appを持つService Principalが作成されています)。選択して、 選択 をクリックします。

[ 確認と割り当て ] をクリックします。
次に、Azure DevOpsに戻り、 「サービス接続 パート2の編集」 画面で 「検証および保存」 ボタンをクリックします。
おめでとうございます!ステップは多いですが、Azure DevOps プロジェクトと Azure Portal アプリ登録/Service Principal間の信頼関係を確立する必要があるため、これは不可欠です。これらのサービスは、defaultで互いに信頼し合っているわけではありません。
次に、Azure アプリ登録/Service Principal と、Azure DevOps がワークスペースにデプロイしたリソースをランする Databricks Service Principal との間の信頼関係を構成します。
CI/CDタスク用のDatabricks Service Principalを作成する
ステージング ワークスペース(この記事では bu1-dev ワークスペースを使用)に移動します。ワークスペース 設定 > ID とアクセス > Service Principal に移動し、 管理 をクリックします。 Service Principal を追加 をクリックして、 新規追加 ボタンをクリックします。
「管理」で Microsoft Entra ID で管理 を選択し、Azure アプリ登録から アプリケーション ID をコピーします。
[Microsoft Entra IDマネージド]オプションで以下に表示されるUIには、Service Principal名を入力するためのフィールドが表示されます。このフィールドで値を入力および保存できますが、Databricks全体のアクセス許可UIでこのService Principalを検索するときに表示されるように、この値は保持されません。
bu1-team1-cicd-staging-spのような 名前 を付けて (すぐにアプリ登録の名前を変更します) 、 追加 をクリックします。

注:単一の Azure DevOps Service Connection、Azure App Registration、および Databricks Service Principal をすべての CI/CD プロセス(ステージング環境および本番運用へのデプロイの両方を含む)で使用できます。ただし、作成しているこれらの CI/CD リソースの名前に「staging」という用語を含めているため、後で「prod」バージョンを追加し、CI/CD プロセスに対してより正確なガバナンスを実行できることに気付くでしょう。
作成されたDatabricks SPをクリックします。コードによっては、 ワークスペースアクセス および SQLアクセス の資格が必要になります。試行錯誤のCI/CDテストをスピードアップするために、特に開発中にはServerlessジョブを使用することをお勧めします。Serverlessジョブを使用している場合、 無制限でクラスター作成を許可する 資格を割り当てる必要はありません。
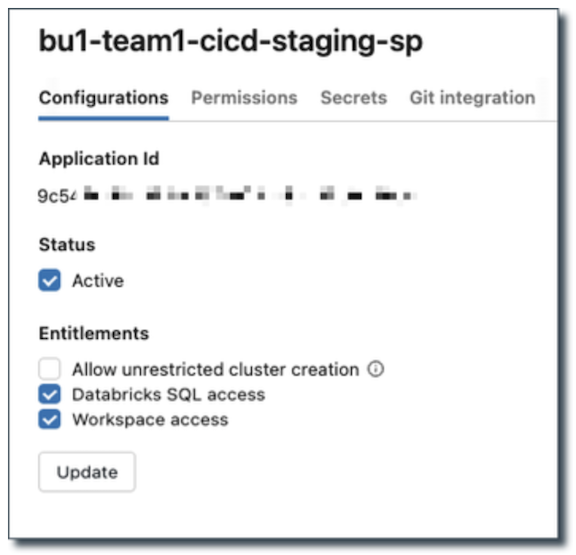
[ 権限 ] tabを確認します。これにより、この SP がワークスペースで何ができるかではなく、誰が SP を管理および使用できるかを決定できます。ステージング環境のチームが何らかの理由でジョブを手動で再実行する必要があるかどうかを検討できます。この場合、そのチームにUSE権限を与えてください。
Git連携 tabを確認します。この機能を使用すると、SPはGitリポジトリに接続できます。これは、ジョブが実行時にGitからノートブックコードをプルするように構成されている場合に必要です。このブログではそのアプローチは使用しません。ノートブックコードとバンドルリソースを各環境にプッシュするようにDevOpsを構成しています。SPのGit連携は構成しないままにします。
ステージング デプロイメント フォルダーを作成する
ワークスペースで、Azure DevOps パイプラインがコードをデプロイするステージング場所を作成します。次に、このフォルダを右クリックして、 共有 (権限) メニューを選択します。SP を検索し、以下に示すように 管理可能 権限を付与します (前述したように、Azure ポータルで作成したアプリ登録を検索していることを忘れないでください。これは、作成した Databricks Service Principal の名前に同期されます)。
開発チームにここにデプロイされているものを表示させたい場合は、彼らに表示権限を付与してください。一般に、開発者、QAチーム、および管理者は、ステージングバンドルのターゲットデプロイメントフォルダに対する書き込みアクセス権を持つべきではありません。

Service Principalへの Unity Catalog 権限の割り当て
カタログとスキーマの作成と権限管理には、いくつかのアプローチがあります。このブログでは、カタログを手動で作成し、SPにデータエディタの権限を割り当てます。また、管理権限も付与されるため、ジョブコードで実行する必要がある場合は、SPはテーブルを削除したり、権限を管理したりできます。必要に応じて、変更や検討を自由に行ってください。
以下に示すように、SP に ステージカタログ にデータアセットを作成する権限を付与します。

ステージングカタログのdefaultスキーマに移動し、これらの権限の多くが予想通りに継承されていることに注目してください。bu1_stg.defaultスキーマの権限を確認します。SP はこのスキーマの所有者ではありませんが、読み取りおよび書き込みを行えることに注意してください (カタログを作成したときに作成されたため、あなたが所有者になります)。
Azure DevOps パイプラインの作成 (bu1-team1-hello-world-pipeline.yml)
CI/CD パイプラインには、次の 2 つのステージを設定します。
-
DeployStaging - フィーチャーBranchからのコードが承認され、メインBranchにMergeされたときに自動的にランされます。
-
DeployProd - DeployStagingの後、および構成可能な承認の後に実行されます。ワークスペース URL の保存には DevOps 変数グループを使用し、本番環境へのデプロイを制御する承認プロセスの定義には DevOps 環境を使用します。
DevOpsプロジェクト > パイプライン > ライブラリ に移動し、 + 変数グループ ボタンをクリックします。 stagingVariables という名前を付け (パイプラインの最初のステージでこれを参照します)、 DATABRICKS_HOST の変数と、ステージングワークスペースのホスト名 (この記事の例では bu1-dev) を指すURLを追加します。その後、 保存 をクリックします。
prodVariables という別の変数グループに対してこのプロセスを繰り返します。これはパイプラインの第 2 段階で参照します。

[DevOps プロジェクト] > [環境] に移動し、 [環境の作成] ボタンをクリックします。名前を prod に設定し (パイプラインの第 2 ステージで参照します)、[リソース] を [なし] に設定したまま、 [作成] をクリックします。
次に、 「承認とチェック」 tabをクリックし、 「承認」 チェックをクリックします。この記事では、2人の承認者を選択するだけですが、組織の要件に応じてこれを構成できます。

メインにマージした後に条件なし、承認なしで自動的にデプロイする予定のため、ステージング環境を作成する必要はありません。
DevOpsプロジェクト > Repos > ファイル ページに移動し、新しいフォルダ( .cicd など)を作成しますそして、その中にHello Worldパイプラインを作成します。

以下のYAMLをコピーして、 33行目と102行目のazureSubscription値 をDevOpsサービス接続の名前と一致するように編集します(はい、サービス接続名が必要であることに混乱します)。コメントを確認し、必要に応じてその他の調整を行います。
- このリンクからファイルをdownloadすることもできます - https://github.com/databricks-solutions/databricks-dab-examples/blob/main/knowledge-base/azure-devops-cicd-example/bu1-team1-hello-world-pipeline.yml
# This triggers the pipeline on a commit to the 'main' branch
trigger:
  branches:
    include:
      - main

# Prevents the pipeline from triggering on Pull Requests; only on merges
pr: none

stages:
  # -----------------------------------------------
  # Stage 1: Deploy to Staging (automatic on merge)
  # -----------------------------------------------
  # TODO - In the bundle validate/deploy steps below, change "workingDirectory"
  # to the folder containing your databricks.yml and edit the target values if
  # your choice differs from "staging" used in the example below.
  - stage: DeployStaging
    displayName: 'Deploy to Staging'
    variables:
      - group: stagingVariables
    condition: |
      eq(variables['Build.SourceBranch'], 'refs/heads/main')
    jobs:
      - job: deployStagingJob
        pool:
          vmImage: ubuntu-latest

        steps:
          - task: UsePythonVersion@0
            inputs:
              versionSpec: 3.11

          - task: AzureCLI@2
            displayName: 'Get Databricks Token (Staging)'
            inputs:
              # TODO - Change azureSubscription value to the name of your DevOps "staging" Service Connection
              azureSubscription: bu1-team1-staging-svc-conn
              scriptType: 'bash'
              scriptLocation: 'inlineScript'
              failOnStandardError: true
              # Set the token as a pipeline variable for subsequent steps; note that the "echo"
              # line does not print the token to the pipeline logs. The resource ID is the well-known
              # Azure AD application ID for Databricks (same for all tenants).
              inlineScript: |
                set -e
                DATABRICKS_TOKEN=$(az account get-access-token --resource 2ff814a6-3304-4ab8-85cb-cd0e6f879c1d --query "accessToken" -o tsv)
                echo "##vso[task.setvariable variable=DATABRICKS_TOKEN]$DATABRICKS_TOKEN"

          # Clone the repository so the bundle files are available to the pipeline agent
          - checkout: self
            displayName: 'Checkout repository'

          # Install Python dependencies here if your bundle requires them
          # For example:
          # - script: pip install -r requirements.txt
          #   displayName: 'Install Python dependencies'

          - script: |
              curl -fsSL https://raw.githubusercontent.com/databricks/setup-cli/main/install.sh | sh
              databricks --version
            displayName: 'Install Databricks CLI'

          - script: databricks bundle validate -t staging
            displayName: 'Validate bundle for the "staging" environment'
            env:
              DATABRICKS_HOST: $(DATABRICKS_HOST)
              DATABRICKS_TOKEN: $(DATABRICKS_TOKEN)
            workingDirectory: $(Build.SourcesDirectory)/hello_world

          - script: databricks bundle deploy -t staging
            displayName: 'Deploy bundle to the "staging" environment'
            env:
              DATABRICKS_HOST: $(DATABRICKS_HOST)
              DATABRICKS_TOKEN: $(DATABRICKS_TOKEN)
            workingDirectory: $(Build.SourcesDirectory)/hello_world

  # -----------------------------------------------
  # Stage 2: Deploy to Production (requires approval in Azure DevOps)
  # -----------------------------------------------
  # TODO - In the bundle validate/deploy steps below, change "workingDirectory"
  # to the folder containing your databricks.yml and edit the target values if
  # your choice differs from "prod" used in the example below.
  - stage: DeployProd
    displayName: 'Deploy to Prod'
    dependsOn: DeployStaging
    condition: succeeded()
    variables:
      - group: prodVariables
    jobs:
      # A "deployment:" job (rather than a regular "job:") is required to
      # connect to an Azure DevOps Environment and enable the approval gate.
      - deployment: deployProdJob
        displayName: 'Deploy to Prod'
        pool:
          vmImage: ubuntu-latest
        # Setup the approval gate. The value for "environment" must match
        # the Azure DevOps Environment name where approvals are configured.
        environment: 'prod'
        strategy:
          runOnce:
            deploy:
              steps:
                - checkout: self

                - task: UsePythonVersion@0
                  displayName: 'Use Python 3.11'
                  inputs:
                    versionSpec: 3.11

                - task: AzureCLI@2
                  displayName: 'Get Databricks Token (Prod)'
                  inputs:
                    # TODO - Change azureSubscription value to the name of your DevOps "prod" Service Connection
                    azureSubscription: bu1-team1-prod-svc-conn
                    scriptType: 'bash'
                    scriptLocation: 'inlineScript'
                    failOnStandardError: true
                    # Set the token as a pipeline variable for subsequent steps; note that the "echo"
                    # line does not print the token to the pipeline logs. The resource ID is the well-known
                    # Azure AD application ID for Databricks (same for all tenants).
                    inlineScript: |
                      set -e
                      DATABRICKS_TOKEN=$(az account get-access-token --resource 2ff814a6-3304-4ab8-85cb-cd0e6f879c1d --query "accessToken" -o tsv)
                      echo "##vso[task.setvariable variable=DATABRICKS_TOKEN]$DATABRICKS_TOKEN"

                # Install Python dependencies here if your bundle requires them
                # For example:
                # - script: pip install -r requirements.txt
                #   displayName: 'Install Python dependencies'

                - script: |
                    curl -fsSL https://raw.githubusercontent.com/databricks/setup-cli/main/install.sh | sh
                    databricks --version
                  displayName: 'Install Databricks CLI'

                - script: databricks bundle validate -t prod
                  displayName: 'Validate bundle for the "prod" environment'
                  env:
                    DATABRICKS_HOST: $(DATABRICKS_HOST)
                    DATABRICKS_TOKEN: $(DATABRICKS_TOKEN)
                  workingDirectory: $(Build.SourcesDirectory)/hello_world

                - script: databricks bundle deploy -t prod
                  displayName: 'Deploy bundle to the "prod" environment'
                  env:
                    DATABRICKS_HOST: $(DATABRICKS_HOST)
                    DATABRICKS_TOKEN: $(DATABRICKS_TOKEN)
                  workingDirectory: $(Build.SourcesDirectory)/hello_world
Commit をクリックして、リポジトリのmainブランチに保存します。

DevOps パイプラインを作成してこのファイルを指す前に、最初の Hello World DABs プルリクエストを承認してマージし、デプロイするコードがあるようにしましょう。
Azure DevOpsプロジェクトで、 Repos > プルリクエスト をクリックし、Databricks Git統合UIから以前に作成したプルリクエストを選択します。

[完了] をクリックし、 Mergeを完了 ボタンをクリックする前にMergeオプションを選択してください。

バンドルコードがメインBranchに移動したことを確認できます。
では、パイプラインを作成しましょう。 プロジェクト > パイプライン > パイプライン メニューに移動し、 パイプラインの作成 をクリックします。 Azure Repos Git を選択します。

チームのリポジトリを選択し、[ 既存の Azure パイプライン YAML ファイル ] をクリックします。
パイプラインファイルのパスを入力し、 続行 をクリックします。

パイプラインを実行する前に、次のいずれかを行う必要があります。
- 前のステップを繰り返して、本番環境のサービス接続(
bu1-team1-prod-svc-conn)、本番環境のワークスペース上のDatabricks SPとデプロイメントフォルダ、本番環境カタログの権限を作成するか、 - 検証エラーを回避するために、パイプラインのすべてのステージ2行をコメントアウトします。
ステージングへのデプロイ
決定したら、[ラン]をクリックします。

次に表示される画面で設定を変更する必要はありません。

「ステージングへのデプロイ」ジョブが実行されます。初回実行時、ステージング変数グループへのアクセス許可を求めるメッセージが表示されます。許可を与えます。

ステージングデプロイが完了したら、ジョブを見つけてランします。

データがService Principalによって追加されたことを確認します。UIのセクションに応じて、以下に示すようにアプリケーション登録のアプリIDまたは名前のいずれかが表示されます。

コードのデプロイ、ジョブの実行、テーブルへのデータの書き込みはすべてAzure App RegistrationのSPによって実行されましたが、ワークスペース設定でこれを有効にしたのはワークスペース管理者であり、スキーマに対するエディター権限を付与したのはUnity Catalog所有者です。

本番運用へのデプロイ
準備ができたら、[確認]ボタンをクリックし、プロダクションデプロイメントステージの実行を承認します。

バンドルは prod ワークスペースにデプロイされている必要があります。ジョブを見つけてランし、prod カタログを確認して実行されたことを確認します。
おめでとうございます!ここまで来れば、あなたはAzure Databricks CI/CDのチャンピオンです。
Workload ID フェデレーションの 2 つのアプローチの比較: Azure AD ブローカー サービス接続と Databricks OIDC 統合
このブログでAzure DevOpsとDatabricksを統合するために採用されているアプローチは、アプリケーション登録によってバックアップされたAzure DevOpsサービス接続を使用します。これは、2つのクラウドサービス間でパイプラインワークロードを安全に連動させるための十分に確立されたパターンです。しかし、最近Databricksは、OIDCに基づく代替アプローチを導入しました。これらをどのように比較し、どれが最適なオプションでしょうか?
どちらの手法も、セキュアなトークンベースのプロトコル(OIDCとOAuth)を使用しています。違いは発行者です。ブログではDevOpsサービス接続機能を使用しています。つまり、DevOpsパイプライン(AzureCLI@2タスク経由)がAzure ADアクセストークンを取得し、それをDatabricks CLIにDATABRICKS_TOKENとして渡します。これは、パイプラインが同じService Principalを介して他のAzureリソース(Storage、Key Vaultなど)にアクセスする必要がある場合にうまく機能します。
Databricks は、新しい代替手段である OAuth トークンフェデレーション (ワークロード ID フェデレーションまたは OIDC とも呼ばれます) もサポートしています。このアプローチでは、Azure DevOps パイプラインは Databricks に直接認証されます — Azure AD 中継ぎ、サービス接続、および明示的なトークン取得ステップはありません。Databricks Service Principalに Azure DevOps 組織の OIDC 発行者を信頼するフェデレーションポリシーを作成し、Databricks CLI はパイプラインの組み込み System.AccessToken を使用してトークン交換を自動的に処理します。
これにより、より単純なパイプライン(AzureCLI@2タスクなし、Azureサービス接続なし)になりますが、Databricksに対してのみ認証が行われます。他のAzureリソースへのアクセスが必要な場合は、このブログで示されている他のサービス接続アプローチが必要です。詳細については、Databricksドキュメントのdev-tools/auth/provider-azure-devops.mdを参照してください。

観点 | アプローチ 1: Azure ADブローカー認証(このブログ) | アプローチ 2: Databricks ネイティブ OIDC フェデレーション (代替オプション) |
|---|---|---|
ドキュメントLink | ||
成熟度 | 確立されたパターン | 新しい方 (Databricks OAuth フェデレーション) |
使用されるプロトコル | OIDC、OAuth 2.0、ベアラートークン | OIDC → Databricks OAuth 2.0 |
認証仲介者 | Azure AD(トークンブローカー) | なし(直接OIDC) |
トークンの取得 | 明示的 | Databricks SDK または Databricks CLI による自動 |
パイプライン内のAzure CLI | 必須 | 必要なし |
Azureサービス接続 | 必須(環境ごとに1つ) | 必要なし |
フェデレーションポリシー | Azure AD上(Azure DevOpsを信頼) | Databricks SPの場合(Azure DevOpsを信頼) |
複雑さ | 2ホップ; ステージごとに8つのパイプラインステップ | 1ホップ。ステージごとに2~3のパイプラインステップ |
Azureリソースアクセス | 同じSPは他のAzureリソース(キーコンテナーなど)にアクセスできます。 | Databricksへの認証のみ |
次の場合に最適 |
|
|
何が違いますか | Azure ADを完全にスキップします。フェデレーション ポリシーは、 Azure DevOps OIDC 発行者 ( | |
必要 |
|