Extração de Informações
Esta página aborda a nova versão da Extração de Informações. Para obter informação sobre a versão anterior, consulte Use a Extração de Informações (legado)
A Extração de Informação transforma documentos e textos não estruturados em informações-key e percepções estruturadas, usando um esquema definido. Isso permite o uso de informações incorporadas em textos não estruturados, PDFs, imagens ou tabelas, diretamente para análise, relatórios ou agentes e aplicativos subsequentes.
Exemplos de Extração de Informações incluem:
- Extraindo partes legais e termos de contratos.
- Extraindo itens de linha e termos de pagamento de faturas.
- Extraindo detalhes chave de prontuários e anotações médicas.
Extração de Informação usa armazenamento default para armazenar transformações de dados temporários, pontos de verificação de modelo e metadados internos que alimentam cada agente. Quando um agente é excluído, o Databricks remove todos os dados associados ao agente do armazenamento default.
A extração de informações está disponível através da IU do Agent Bricks, em SQL, com a API REST e com a API Assíncrona (Beta).
Criar um agente de extração de informações na IU
Requisitos
Vá para  Agentes no painel de navegação esquerdo do seu workspace. Clique em Criar agente > Extração de informações .
O passo 1. Selecione os dados para extrair informações
-
Na página Comece com seus dados , selecione os arquivos ou dados dos quais você deseja extrair informações. Você pode fazer qualquer um dos seguintes:
- Arraste e solte um ou mais arquivos na área de upload ou clique para procurar arquivos para fazer upload.
- Clique em Selecionar volume para selecionar um volume do Unity Catalog com tipos de arquivo compatíveis.
- Clique em Selecionar tabela para selecionar uma tabela do Unity Catalog que contém dados de texto.
-
Se você selecionar uma tabela, selecione a coluna que contém os dados a serem extraídos. É necessário selecionar uma coluna com um tipo compatível, como STRING ou VARIANT, antes de prosseguir. Se a tabela não tiver colunas suportadas, selecione uma tabela diferente.
-
Clique em Criar Agente . Este botão é ativado somente depois de selecionar uma fonte de dados válida e, para uma tabela, uma coluna suportada.
O passo 2. Configure e refine seu esquema de extração
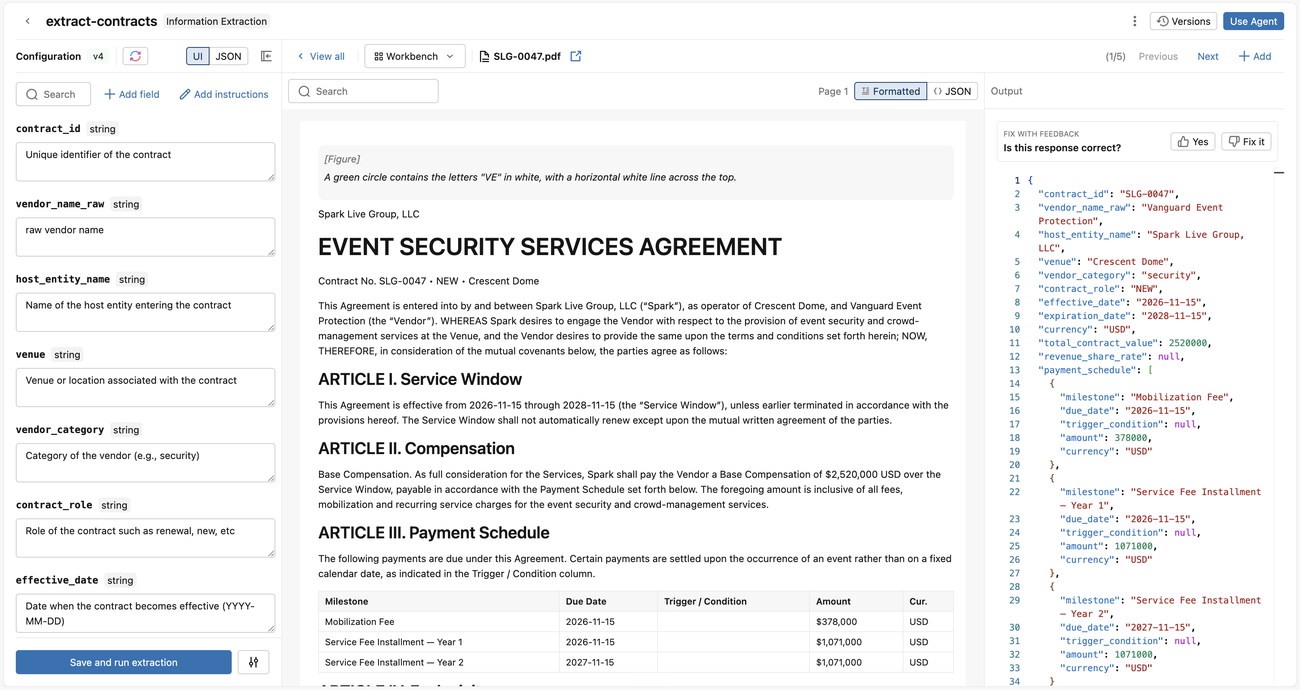
Depois que a Extração de Informação processar seus dados, configure e refine quais dados deseja extrair de seus documentos.
-
Em Configuração, defina seu esquema de extração. Existem várias maneiras de fazer isso:
-
Insira linguagem natural que descreva as informações que você deseja extrair e clique em Gerar Esquema . A Extração de Informações gera automaticamente um esquema JSON com nomes de campos e definições para você. Edite essas descrições conforme necessário.
-
Alternativamente, clique em Ou, defina manualmente para definir o seu esquema manualmente:
- Clique em Adicionar campo .
- Insira o nome, o tipo e a descrição do campo.
- Clique em Confirmar .
- Repita para cada campo que deseja extrair.
- Clique em Salvar e executar extração .
-
Você também pode clicar em JSON para editar o esquema JSON diretamente. Clique em Aplicar alterações quando concluir.
Cada vez que você atualiza seu esquema e clica em Salvar e execução de extração , a Extração de informação atualiza o agente de extração, executa a extração e mostra os resultados para cada entrada.
Para configurar opções adicionais, clique na alternância de opções
 ao lado de Salvar e execução da extração e, em seguida, habilite uma ou mais das seguintes opções:
- Modo de precisão : melhora a precisão para campos complexos e documentos longos.
- Citações : exibe referências de origem para valores extraídos.
- Pontuações de confiança : mostra os níveis de confiança para os valores extraídos.
-
-
À esquerda, examine o documento analisado e a extração do agente. Itere os resultados da extração de duas maneiras. Primeiro, forneça feedback em linguagem natural sobre uma ou mais entradas, o que ajusta automaticamente suas descrições ao pressionar Salvar e execução de extração . Segundo, revise manualmente as descrições do esquema, que entram em vigor ao pressionar Salvar e execução de extração .
-
Utilize as versões para comparar ou reverter para uma configuração anterior. Clique em Versões e, em seguida, clique em Comparar para comparar a definição de esquema de uma versão anterior com a versão atual. Clique em Restaurar para restaurar uma versão anterior.
O passo 3. Avaliar e melhorar a qualidade da extração
Para medir o desempenho do seu agente e aprimorá-lo sistematicamente, avalie o agente em relação a um dataset rotulado. Uma avaliação pontua cada extração em relação a uma resposta correta conhecida (ground truth), para que seja possível rastrear a precisão no nível do campo em diferentes versões e direcionar os campos que precisam de atenção.
Adicionar um dataset de avaliação
Antes de executar uma avaliação, é necessário ter um dataset de avaliação no Unity Catalog. O dataset deve ser uma tabela do Unity Catalog com duas colunas:
- Uma coluna de entrada com o texto ou documento para extrair. Isso pode ser
STRINGtexto ou a saídaVARIANTdeai_parse_document. - Uma **coluna da verdade fundamental** com o resultado de extração esperado como uma string JSON. Cada valor deve estar em conformidade com o esquema de extração do seu agente, correspondendo ao
ai_extractesquema avançado.
Executar uma avaliação
Para executar uma avaliação para seu agente de extração:
- No workbench, abra o dropdown de avaliação e clique em Execução da avaliação . Isso abre a caixa de diálogo Criar execução de avaliação .
- Na **tabela de dataset de avaliação**, selecione a tabela do Unity Catalog que contém seus exemplos rotulados.
- Em Mapeamento de colunas , selecione a coluna de Entrada que contém a entrada do agente e a coluna de verdade comprovada que contém a resposta esperada.
- Clique em **Executar avaliação**. A Extração de Informações salva a configuração atual como uma nova versão e pontua cada linha em relação à sua verdade fundamental.
Revisar os resultados da avaliação
Conforme a execução avança, os documentos são transmitidos para a tab **Documentos** e quaisquer campos incompatíveis são exibidos por documento. Quando a execução termina, a Extração de Informações exibe a tab **Visão Geral**, que inclui:
- Um scorecard com Precisão geral do campo e Documentos totalmente corretos . Se existir uma execução de avaliação anterior, o scorecard mostrará a alteração dessa execução.
- Uma tabela de **Pontuações por campo**. Clique em qualquer campo para abrir sua análise detalhada, que mostra precisão, exatidão, revocação e F1. Clique em **Mostrar documentos com falha** para ver cada documento que falhou ao extrair esse campo e sua saída extraída.
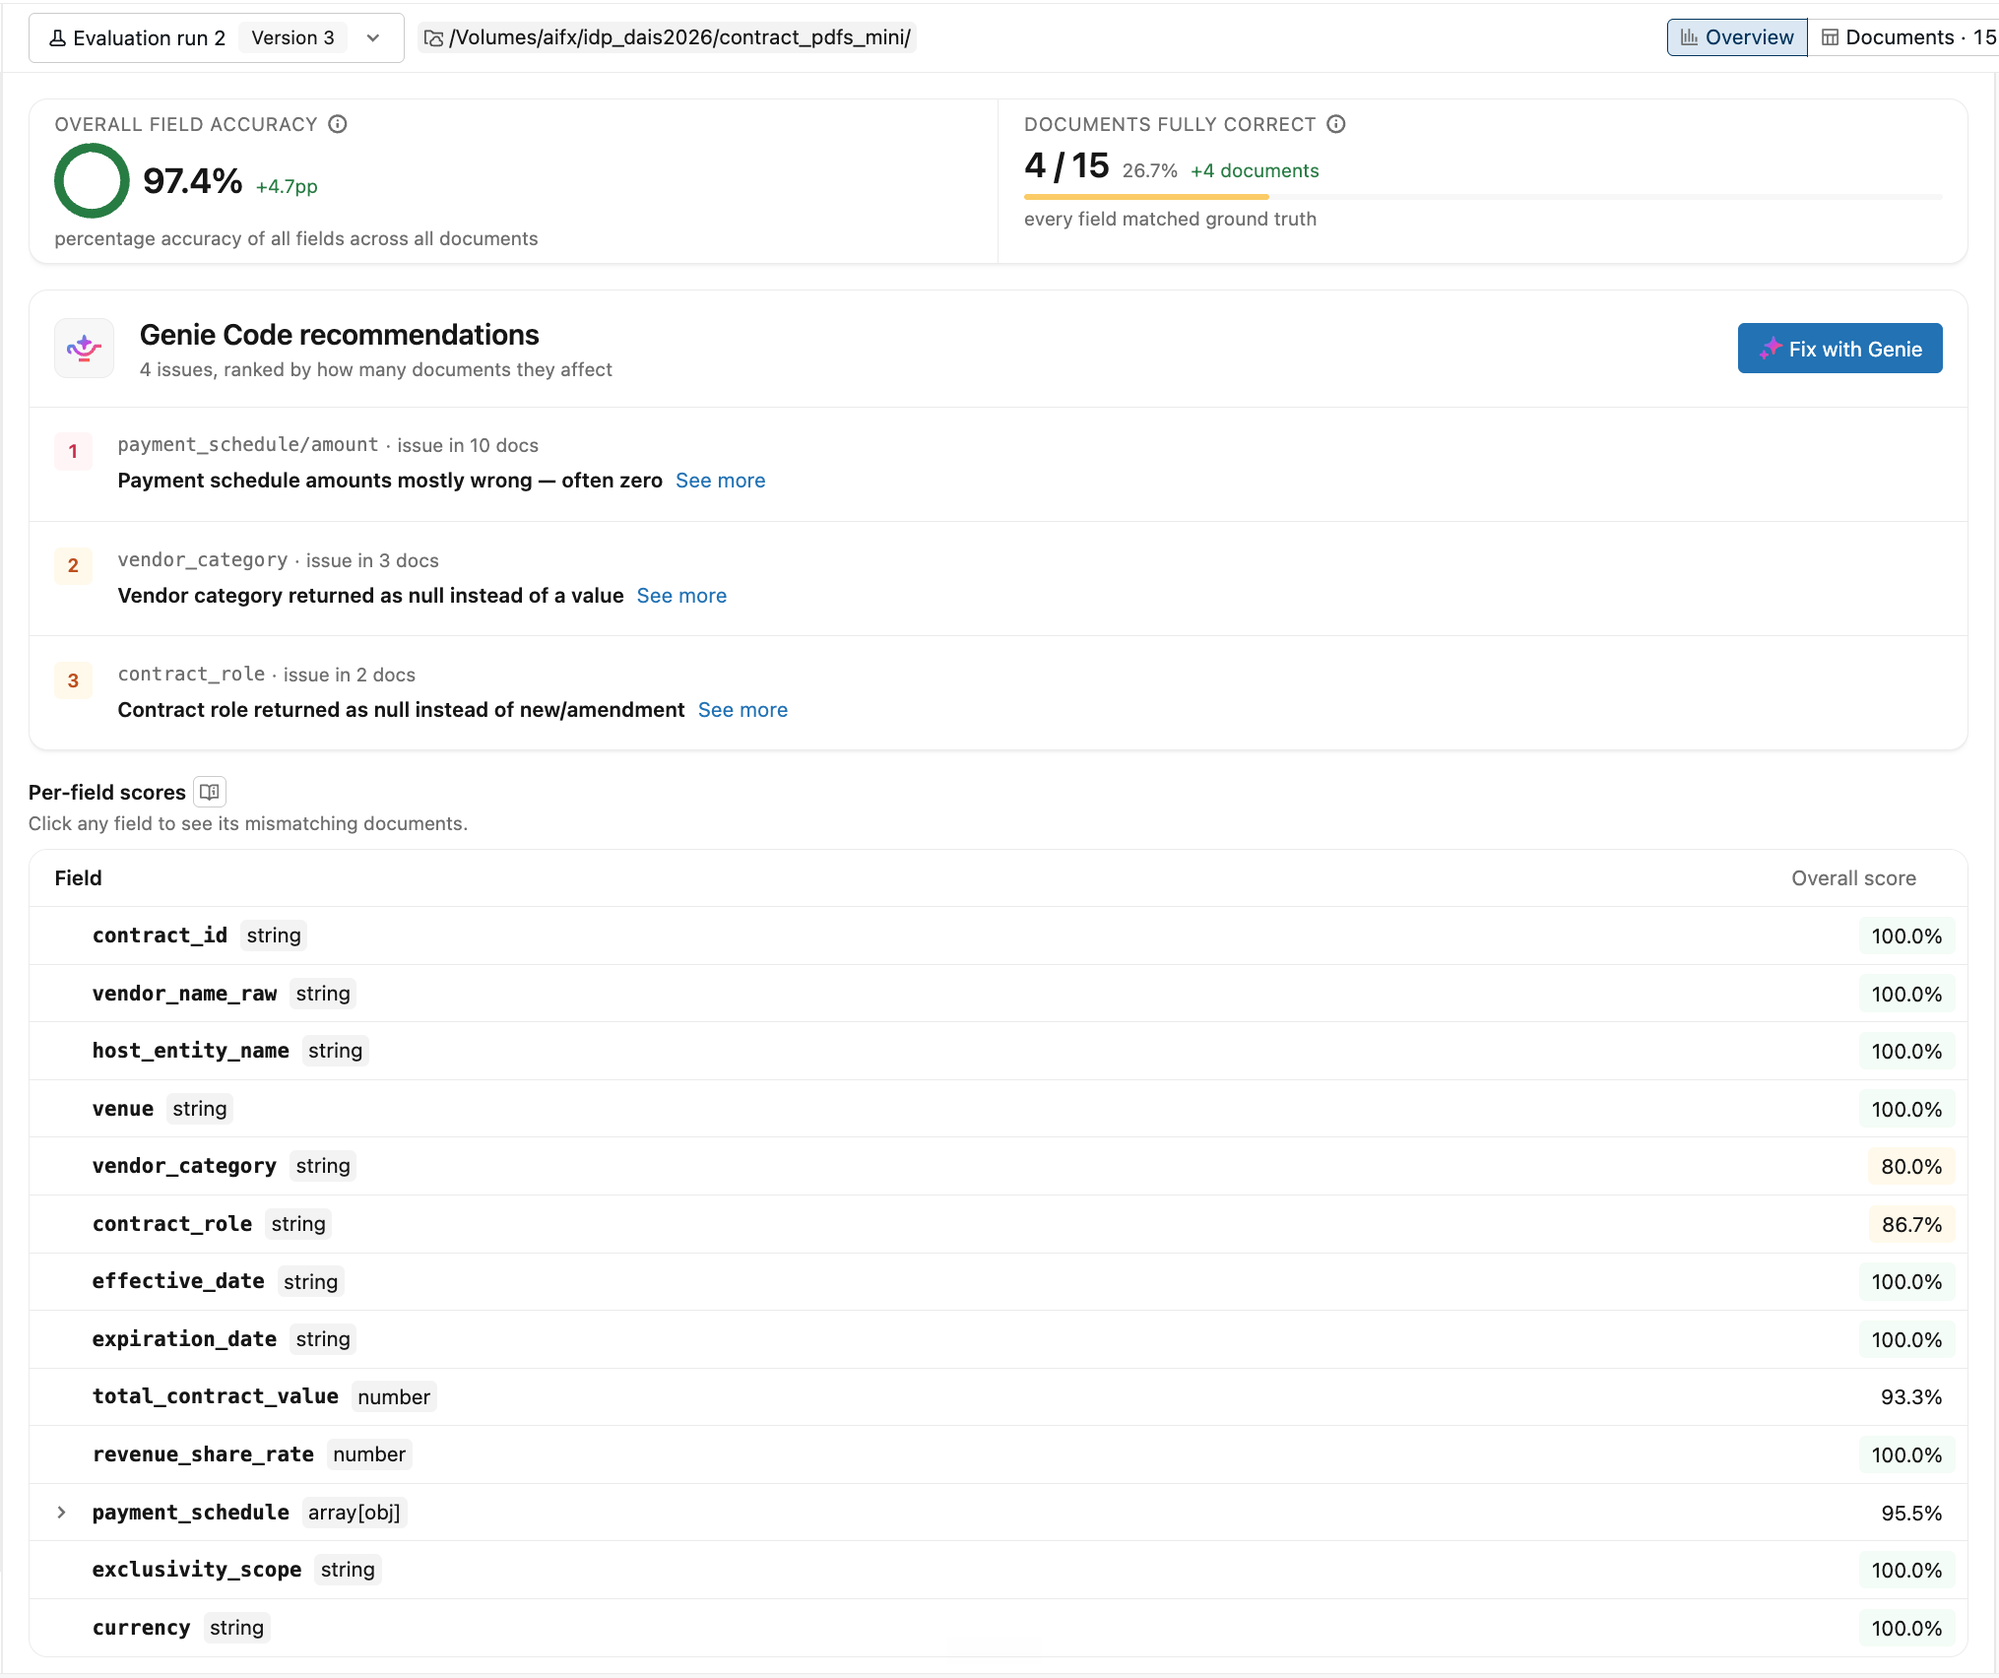
Mude para a **tab Documentos** para inspecionar documentos individuais. Cada linha exibe a proporção de campos correspondentes e os campos incompatíveis. Use o **dropdown Campos** para filtrar documentos que continham um campo incompatível específico. Clique em um documento para comparar a resposta do agente com a verdade fundamental lado a lado.
Aplicar correções do Genie Code
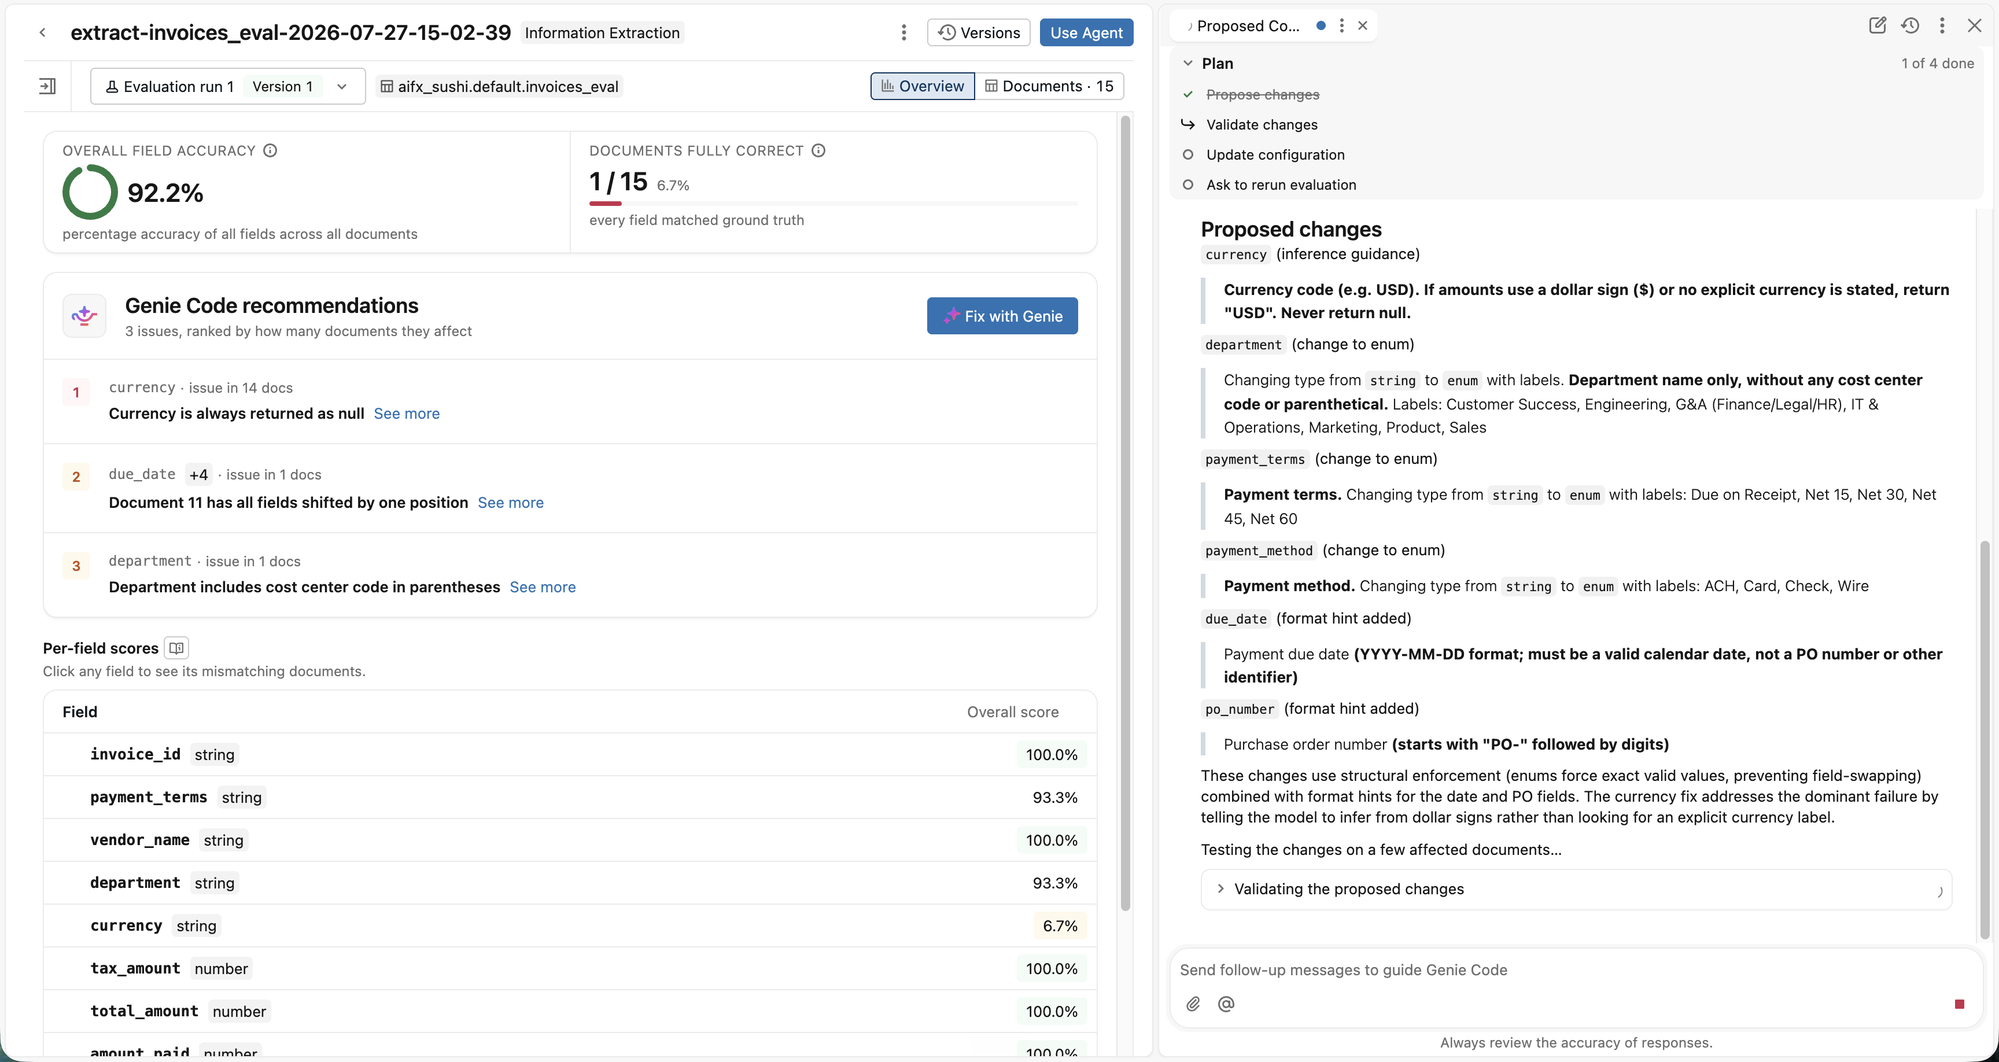
Após a conclusão de uma execução, a Extração de Informação analisa os resultados e exibe problemas nas recomendações do Genie Code , classificadas pelo número de documentos afetados. Cada descoberta descreve um possível problema de qualidade. Clique em Corrigir com Genie para abrir um chat interativo do Genie Code que propõe alterações de esquema e instrução, as valida em relação aos documentos afetados e oferece para executar uma avaliação completa novamente.
O passo 4. Use seu agente de extração.
Depois de estar satisfeito com o desempenho do agente, use-o para extrair informações.
Clique em Usar Agente no canto superior direito. Você pode selecionar uma das opções a seguir:
- Execução em SQL para usar o agente para extrair informação de todos os seus dados. Isso abre uma consulta SQL que usa
ai_extractpara extrair informações do seu volume ou tabela usando o esquema definido. Para obter mais informações sobre como usarai_extractem consultas SQL, consulte a funçãoai_extract. - Crie um pipeline do Lakeflow que realize a execução em intervalos programados para invocar seu agente com novos dados. Isso cria um pipeline do Lakeflow que atualiza uma tabela de transmissão com sua extração de dados. Você pode configurar para programar o pipeline para a execução quando novos dados chegarem. Para obter mais informações sobre LakeFlow Pipelines, consulte Spark Declarative Pipelines on Lakeflow.
Extrair informações em SQL
Chame ai_extract em SQL para extrair campos em escala:
SELECT ai_extract(
  'Invoice #12345 from Acme Corp for $1,250.00 dated 2024-01-15',
  '{
    "invoice_id": {"type": "string", "description": "Unique invoice identifier"},
    "vendor_name": {"type": "string", "description": "Legal business name"},
    "total_amount": {"type": "number", "description": "Total invoice amount"},
    "invoice_date": {"type": "string", "description": "Date in YYYY-MM-DD format"}
  }',
  options => map('version', '2.1')
);
Consulte a referência de SQL ai_extract.
Extrair informação com a API REST
Use a API REST para extrair campos estruturados de aplicativos, serviços e fluxos de trabalho de automação. Consulte a documentação da API REST para obter referência.
O limite de taxa default para as solicitações da API REST de ai_extract é de 120 solicitações por minuto por workspace. Entre em contato com sua equipe de account Databricks para solicitar um limite maior.
O exemplo a seguir extrai campos estruturados do texto da fatura:
curl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/ai-extract" \
     -H "Authorization: Bearer $DATABRICKS_TOKEN" \
     -H "Content-Type: application/json" \
     -d '{
  "content": "Invoice #12345 from Acme Corp for $1,250.00 dated 2024-01-15",
  "schema": {
    "vendor_name": {
      "type": "string"
    },
    "total_amount": {
      "type": "number"
    }
  }
}'
Extrair informações com a API assíncrona (Beta)
Para processamento em lotes, o Databricks recomenda tarefas de Função de AI no Lakeflow Jobs. Para extrair campos em um job, use uma tarefa ai_extract, que faz o seguinte:
- Realiza a execução do processamento em segundo plano e grava os resultados em uma tabela do Unity Catalog, para que você não precise enviar lotes, verificar seus status ou fazer download de arquivos de saída.
- Processa apenas as linhas que são novas ou alteradas desde a execução anterior.
- Mostra o progresso de cada execução e quantos inputs foram bem-sucedidos e falharam.
Use a API assíncrona do AI Functions (Beta) em vez disso quando quiser integrar o processamento em um aplicativo existente ou em um orquestrador externo e gerenciar os envios e resultados por conta própria.
Beta
Este recurso está em Beta. Para usá-lo, um administrador do Workspace deve ativar a API assíncrona de AI Functions na página Prévias . Consulte Gerenciar prévias do Databricks.
Para os campos de solicitação e resposta e para as solicitações para cancelar e listar lotes, consulte a referência da API assíncrona.
Arquivo de entrada
O arquivo de entrada de um lote ai_extract é um arquivo JSONL em um volume do Unity Catalog, com uma solicitação em cada linha. Cada linha é um objeto JSON com exatamente os seguintes campos:
campo | Descrição |
|---|---|
| Uma string que identifica a solicitação. Cada linha do arquivo de saída tem a |
| O texto do qual extrair campos, no formato |
O arquivo de entrada a seguir contém duas solicitações:
{"custom_id": "invoice-001", "body": {"text": "Invoice #12345 from Acme Corp for $1,250.00 dated 2024-01-15"}}
{"custom_id": "invoice-002", "body": {"text": "Invoice #12346 from Globex for $980.00 dated 2024-02-03"}}
O arquivo de entrada contém apenas o texto e o ID de cada registro. Você define os outros parâmetros de ai_extract em params quando cria o lote, e eles se aplicam a todas as solicitações:
schema(obrigatório): Os campos a serem extraídos, como uma lista de nomes de campo ou como um objeto que mapeia cada campo para seutypeedescription.options: As opções da função, comoinstructionsemode.
Para saber o que cada parâmetro faz, consulte a referência da API REST AI Extract. Em params.options, escreva cada nome de opção em camelCase, por exemplo enableCitations em vez de enable_citations.
Quando você cria um lote, a API verifica o arquivo de entrada inteiro e params primeiro. Se o arquivo de entrada ou params violar uma das seguintes regras, a solicitação falha com HTTP 400 e nenhum lote é criado:
-
O arquivo está codificado em UTF-8 e cada linha é um objeto JSON com exatamente os campos
custom_idebody. O arquivo não possui linhas em branco. -
Cada
custom_idé uma string não vazia e não existem duas linhas com a mesmacustom_id. -
Cada
bodytem exatamente uma key,text.- Se um valor
textnão for uma string, o lote ainda será criado e essa solicitação falhará com o tipo de erroinvalid_request.
- Se um valor
-
O arquivo tem de 1 a 50.000 linhas e tem no máximo 200 MiB.
- Para processar mais registros, divida-os em vários arquivos de entrada e crie um lote para cada arquivo.
-
paramstemschemae nenhum parâmetro queai_extractnão leve.
Para um problema em uma linha do arquivo de entrada, a mensagem de erro fornece o número da linha e a regra, por exemplo Batch input line 3 custom_id must be unique. Se você não conseguir ler o arquivo de entrada ou gravar em output_ref, a solicitação falhará com HTTP 403.
A API copia o arquivo de entrada quando cria o lote, portanto, as alterações feitas posteriormente no arquivo não afetam o lote.
Execução de um lote
Para extrair campos com a API assíncrona:
-
Crie o arquivo de entrada e faça upload dele para um volume do Unity Catalog, por exemplo, com a API de arquivos.
-
Crie um lote que faça a execução de
ai_extractno arquivo de entrada. Definainput_refcomo o caminho do arquivo de entrada,paramscomo os parâmetros de cada solicitação eoutput_refcomo um diretório de volume ou um novo caminho de arquivo para o arquivo de saída:Bashcurl -X POST "$DATABRICKS_HOST/api/2.0/ai-functions/batches" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-H "Content-Type: application/json" \-d '{"endpoint": "ai_extract","input_ref": "/Volumes/my_catalog/my_schema/my_volume/requests.jsonl","params": {"schema": {"vendor_name": {"type": "string"},"total_amount": {"type": "number"}}},"output_ref": "/Volumes/my_catalog/my_schema/my_volume/output/"}'A resposta contém o lote
name. Use-o em vez de<batch-name>nos próximos passos. Por default, um workspace pode ter até 20 lotes inacabados por vez, em todos os usuários. Se estiver no limite, o pedido falhará com HTTP 409. Crie o lote novamente após outro lote terminar ou ser cancelado. -
Verifique o status do lote. O lote termina quando
statuséCOMPLETED,CANCELLEDouFAILED:Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/ai-functions/batches/<batch-name>" \-H "Authorization: Bearer $DATABRICKS_TOKEN"Quando o arquivo de saída estiver pronto,
output_refna resposta conterá o caminho dele. -
Faça o download do arquivo de saída com a API de arquivos:
Bashcurl -X GET "$DATABRICKS_HOST/api/2.0/fs/files/Volumes/my_catalog/my_schema/my_volume/output/<batch-name>_output.jsonl" \-H "Authorization: Bearer $DATABRICKS_TOKEN" \-o output.jsonl
Arquivo de saída
A API assíncrona grava o arquivo de saída de um lote ai_extract no local em output_ref:
- Se
output_refterminar com/ou nomear um diretório existente, a API gravará o arquivo de saída em<batch-name>_output.jsonlnesse diretório. Vários lotes podem compartilhar um único diretório de saída. - Caso contrário,
output_refé o caminho do arquivo de saída. O arquivo não deve existir ao criar o lote.
O arquivo de saída tem uma linha para cada linha do arquivo de entrada. As linhas estão na mesma ordem do arquivo de entrada. Cada linha tem o custom_id da sua solicitação e um dos seguintes campos:
response: O resultado da solicitação. Ele tem os mesmos campos que a resposta da API REST AI Extract.error: Otypeemessagedo erro, se a solicitação falhou. Se o lote foi cancelado antes que a solicitação fosse posta em execução, o tipo serácancelled.
O exemplo a seguir mostra uma linha para uma solicitação que foi bem-sucedida e uma linha para uma solicitação que falhou:
{"custom_id": "invoice-001", "response": {...}}
{"custom_id": "invoice-002", "error": {"type": "request_failed", "message": "..."}}
Limitações
- Consulte Limitações