Registrar solicitações e respostas para Endpoint de serviço (legado)
Uma nova experiência do Unity Gateway está disponível de forma geral. É o plano de controle corporativo para governar endpoints de LLM e agentes de codificação com recursos aprimorados. Consulte governança de AI com o Unity Gateway.
Este artigo descreve as tabelas de inferência habilitadas pelo AI Gateway (legado) para monitoramento de modelos servidos. A tabela de inferência captura automaticamente as solicitações recebidas e as respostas enviadas para um Endpoint e as registra como Logs em uma tabela Delta do Unity Catalog. Você pode usar os dados desta tabela para monitorar, avaliar, comparar e realizar ajustes finos em modelos do machine learning.
O que são tabelas de inferência habilitadas pelo AI Gateway (legado)?
As tabelas de inferência habilitadas pelo AI Gateway (legado) simplificam o monitoramento e o diagnóstico de modelos registrando continuamente as entradas e respostas (previsões) de solicitações de serviço de endpoints do Model Serving e salvando-as em uma tabela Delta no Unity Catalog. Em seguida, você poderá usar todos os recursos da plataforma Databricks, como consultas do Databricks SQL e notebooks para monitorar, depurar e otimizar seus modelos.
É possível habilitar tabelas de inferência em endpoints de servindo modelo existentes ou recém-criados, e as solicitações para esse endpoint são então automaticamente registradas em uma tabela no Unity Catalog.
Algumas aplicações comuns para tabelas de inferência são as seguintes:
- Crie um corpus de treinamento. Ao unir tabelas de inferência com rótulos de ground truth, você pode criar um corpus de treinamento que pode usar para retreinar ou ajustar e melhorar seu modelo. Usando Jobs do Lakeflow, você pode configurar um ciclo de feedback contínuo e automatizar o retreinamento.
- Monitorar a qualidade dos dados e do modelo. É possível monitorar continuamente o desempenho do modelo e o desvio de dados usando o perfil de dados, que gera automaticamente dashboards de qualidade de dados e modelos que o senhor/a senhora pode compartilhar com as partes interessadas. Além disso, é possível habilitar alertas para saber quando o senhor/a senhora precisa retreinar seu modelo com base em mudanças nos dados de entrada ou reduções no desempenho do modelo.
- Depurar problemas de produção. As tabelas de inferência registram dados como códigos de status HTTP, código JSON de solicitação e resposta, tempos de execução do modelo e saída de rastreamentos durante os tempos de execução do modelo. É possível usar esses dados de desempenho para fins de depuração. Também é possível usar a data histórica em tabelas de inferência para comparar o desempenho do modelo em solicitações históricas.
- Monitore agentes implantados. Tabelas de inferência também podem armazenar rastros do MLflow para agentes, ajudando você a depurar problemas e monitorar o desempenho.
Requisitos
-
as tabelas de inferência habilitadas pelo AI Gateway (legado) são suportadas apenas para Endpoint que servem um dos seguintes itens:
-
Um workspace do Databricks em uma região onde o servindo modelo é suportado. Consulte disponibilidade de recursos de serviço de modelo.
-
O compute serverless precisa ser habilitado no workspace.
-
A Databricks recomenda que você habilite a otimização preditiva para um desempenho otimizado de suas tabelas de inferência.
-
Seu workspace deve ter o Unity Catalog habilitado.
-
Tanto o criador do endpoint quanto o modificador devem ter permissão **Pode Gerenciar** no endpoint. Consulte Listas de controle de acesso.
-
Tanto o criador quanto o modificador do endpoint devem ter as seguintes permissões no Unity Catalog:
USE CATALOGpermissões no catálogo especificado.USE SCHEMApermissões no esquema especificado.CREATE TABLEPermissões no esquema.
-
O catálogo não pode ser um catálogo OpenSharing para o metastore atual.
Não há suporte para a especificação de uma tabela existente. O Databricks cria automaticamente uma nova tabela de inferência quando você cria um endpoint ou atualiza a configuração do AI Gateway (legado) com a configuração da tabela de inferência ativada.
A tabela de inferência poderá parar de registrar dados ou ser corrompida se realizar alguma das seguintes ações:
- Altere o esquema da tabela.
- Altere o nome da tabela.
- Excluir a tabela.
Habilitar e desabilitar tabelas de inferência
Esta seção mostra como habilitar ou desabilitar tabelas de inferência usando a interface do usuário de Serving. O proprietário das tabelas de inferência é o usuário que habilitou a tabela de inferência. Todas as listas de controle de acesso (ACLs) na tabela seguem as permissões padrão do Unity Catalog e podem ser modificadas pelo proprietário da tabela.
Para habilitar tabelas de inferência durante a criação do endpoint, use os passos a seguir:
- Clique em Serviço na IU da Databricks.
- Clique em Criar endpoint de serviço .
- Na seção do AI Gateway, selecione Habilitar tabelas de inferência .
Também é possível habilitar tabelas de inferência em um endpoint existente. Para editar uma configuração de endpoint existente, faça o seguinte:
- Na seção Gateway de AI, clique em Editar gateway de AI .
- Selecione **Habilitar tabelas de inferência**.
Siga estas instruções para desativar tabelas de inferência:
- Navegue para sua página de endpoint.
- Clique em **Editar gateway de AI**.
- Clique em **Habilitar tabela de inferência** para remover a marca de seleção.
- Depois de definir as especificações do AI Gateway (legado) de acordo com suas preferências, clique em Atualizar .
Habilitar tabelas de inferência para agentes
Você também pode habilitar tabelas de inferência para agentes implantados; essas tabelas de inferência armazenam detalhes de carga útil e solicitação, bem como logs de rastreamento do MLflow.
Habilite as tabelas de inferência para agentes usando os seguintes métodos:
- Agentes implantados utilizando a API
mlflow.deploy()têm tabelas de inferência habilitadas automaticamente. Consulte Implantar um agente para aplicações de IA (Model Serving). - Para implantações programáticas, defina a variável de ambiente
ENABLE_MLFLOW_TRACINGcomoTruena configuração do endpoint. Consulte Adicionar variáveis de ambiente de texto simples.
Para saber mais sobre o rastreamento de agentes do MLflow, consulte Visão geral do rastreamento.
Consulte e analise os resultados na tabela de inferência
Depois que seus modelos servidos estiverem prontos, todas as solicitações feitas aos seus modelos são registradas automaticamente na tabela de inferência, juntamente com as respostas. Você pode view a tabela na UI, consultar a tabela do Databricks SQL ou de um Notebook, ou consultar a tabela usando a API REST.
Para view a tabela na IU: Na página do endpoint, clique no nome da tabela de inferência para abrir a tabela no Catalog Explorer.
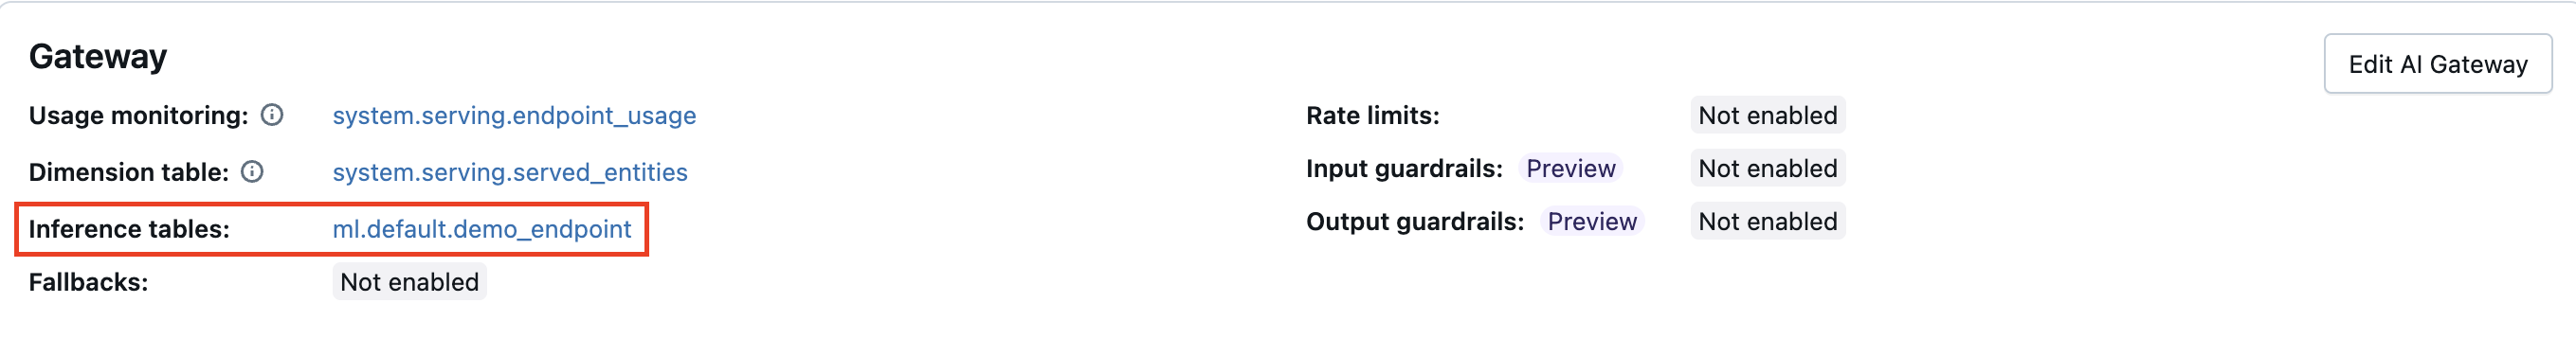
Para consultar a tabela do Databricks SQL ou de um Notebook Databricks: Você pode executar um código semelhante ao seguinte para consultar a tabela de inferência.
SELECT * FROM <catalog>.<schema>.<payload_table>
**Para fazer o join dos dados da sua tabela de inferência com detalhes sobre o modelo base subjacente disponibilizado em seu endpoint:** Os detalhes do modelo base são capturados em system.serving.served_entities tabela do sistema.
SELECT * FROM <catalog>.<schema>.<payload_table> payload
JOIN system.serving.served_entities se on payload.served_entity_id = se.served_entity_id
Esquema da tabela de inferência para o AI Gateway (legado)
As tabelas de inferência habilitadas usando o AI Gateway (legado) têm o seguinte esquema:
Nome da coluna | Descrição | Tipo |
|---|---|---|
| A data UTC em que a solicitação de servindo modelo foi recebida. | Data |
| Um identificador de solicitação gerado pela Databricks anexado a todas as solicitações de servindo modelo. | String |
| O identificador de solicitação fornecido pelo usuário que pode ser especificado no corpo da solicitação de servindo modelo. | String |
| O carimbo de data/hora no qual a solicitação é recebida. | Timestamp |
| O código de status HTTP que foi retornado do modelo. | INT |
| A fração de amostragem usada caso a solicitação tenha sido subamostrada. Este valor está entre 0 e 1, onde 1 representa que 100% das solicitações recebidas foram incluídas. | double |
| O tempo em milissegundos em que o modelo realizou a inferência. Isso não inclui latências adicionais de rede e representa apenas o tempo que o modelo levou para gerar previsões. | BigInt |
| O corpo JSON da solicitação bruta que foi enviado ao endpoint servindo modelo. | String |
| O corpo JSON da resposta bruta que foi retornado pelo endpoint de servindo modelo. | String |
| O ID exclusivo da entidade servida. | String |
| Os erros que ocorreram quando os dados não puderam ser registrados. Os códigos de erro incluem | matriz |
| A ID do usuário ou da entidade de serviço cujas permissões são usadas para a solicitação de invocação do endpoint de disponibilização. Este campo retorna | String |
Esquemas de tabela de inferência de agente
Logs de solicitação e logs de avaliação foram descontinuados e serão removidos em uma versão futura. Consulte a descontinuação dos logs de solicitação e de avaliação para obter orientações de migração.
Para agentes, o Databricks cria três tabelas de inferência para cada implantação para registrar solicitações e respostas de e para o Endpoint de servindo modelo:
Tabela de inferência | Exemplo de nome de tabela do Databricks | Conteúdo da tabela |
|---|---|---|
Payload |
| Payloads de solicitação e resposta JSON brutos |
Logs de solicitação de payload |
| Solicitação e respostas formatadas, rastreamentos do MLflow |
Logs de avaliação de payload |
| Feedback formatado, conforme apresentado no aplicativo de avaliação, para cada solicitação |
Os usuários podem esperar os dados nas tabelas de payload dentro de uma hora após a interação com o endpoint de serviço. Os logs de solicitação de payload e os logs de avaliação podem levar mais tempo para serem preenchidos, e são derivados da tabela de payload bruta. Você pode extrair logs de solicitação e avaliação da própria tabela de payload. Exclusões e atualizações na tabela de payload não são refletidas nos logs de solicitação de payload ou nos logs de avaliação de payload.
Veja a seguir o esquema da tabela de logs de solicitação de payload:
Nome da coluna | Descrição | Tipo |
|---|---|---|
| Um identificador de solicitação gerado pela Databricks anexado a todas as solicitações de servindo modelo. | String |
| Um identificador de solicitação opcional gerado pelo cliente que pode ser especificado no corpo da solicitação do servindo modelo. | String |
| A data UTC em que a solicitação de servindo modelo foi recebida. | Data |
| O carimbo de data/hora em milissegundos de época de quando a solicitação de servindo modelo foi recebida. | Long |
| Carimbo de data/hora da solicitação. | Timestamp |
| O código de status HTTP que foi retornado do modelo. | INT |
| A fração de amostragem usada caso a solicitação tenha sido subamostrada. Este valor está entre 0 e 1, onde 1 representa que 100% das solicitações recebidas foram incluídas. | double |
| O tempo de execução em milissegundos para o qual o modelo realizou a inferência. Isso não inclui latências adicionais de rede e representa apenas o tempo que o modelo levou para gerar previsões. | Long |
| O ID da conversa extraído do log de solicitação. | String |
| A última consulta do usuário da conversa do usuário. | String |
| A última resposta ao usuário. | String |
| A representação de strings do pedido. | String |
| Representação de strings da resposta. | String |
| Representação de cadeia de caracteres de traço extraído do | String |
| Um mapa de metadados relacionado ao endpoint servindo modelo associado à solicitação. Este mapa contém o nome do endpoint, o nome do modelo e a versão do modelo utilizados para o endpoint. | MAP<STRING, STRING> |
| A versão do esquema. | String |
A seguir é exibido o esquema para a tabela de log de avaliação de payload:
Nome da coluna | Descrição | Tipo |
|---|---|---|
| Um ID de solicitação do Databricks. | String |
| O ID do o passo, derivado da avaliação de recuperação. | String |
| Um campo de struct contendo a informação sobre quem criou a avaliação. | struct |
| Carimbo de data/hora da requisição. | Timestamp |
| Os dados para qualquer feedback sobre as respostas do agente do aplicativo de avaliação. | String |
| Os dados para qualquer feedback sobre os documentos recuperados para uma resposta. | String |
Tabela de inferência rápida para endpoints de servindo modelo personalizados
Para endpoints de servindo modelo (modelo personalizado), o AI Gateway (legado) entrega payloads de solicitação e resposta à tabela de inferência por meio de telemetria de endpoint, portanto, as linhas geralmente ficam disponíveis em segundos.
A tabela de inferência ({catalog_name}.{schema_name}.{model_name}_payload) é uma view sobre uma tabela de logs de telemetria ({catalog_name}.{schema_name}.{model_name}_otel_logs). Quando a tabela de inferência está habilitada, as cargas úteis de solicitação e resposta são gravadas em _otel_logs, e a view _payload faz a leitura a partir dela. Faça uma query na view _payload para ler solicitações e respostas.
A tabela de logs de telemetria _otel_logs é criada no mesmo catálogo e esquema que a tabela de inferência e permanece visível mesmo quando você habilita apenas a tabela de inferência — isso é esperado, pois _payload é uma view sobre ela. Quando apenas a tabela de inferência está habilitada, _otel_logs contém apenas os dados de solicitação e resposta da tabela de inferência; ele não inclui os campos adicionais presentes quando outros sinais de telemetria (logs, spans ou métricas) estão habilitados.
A tabela de inferência rápida usa o Zerobus no backend para fornecer telemetria, portanto, está sujeita às mesmas limitações e cotas do Zerobus. Consulte cotas do Zerobus Ingest.
A entrega e a amostragem de telemetria de endpoint se aplicam apenas a endpoints de servindo modelo personalizados de CPU. Endpoints que atendem a throughput provisionada, modelos externos, cargas de trabalho de API do Foundation Model ou agentes seguem o comportamento de entrega em Limitações.
Amostragem
A amostragem é uma funcionalidade da tabela de inferência rápida: para Endpoint de servindo modelo personalizados de CPU, você pode configurar a fração de solicitações que são registradas em log. A amostragem reduz o volume de logs em endpoints de alto throughput, mantendo uma amostra representativa do tráfego.
- **Default**: 100%. Todas as solicitações são registradas, a menos que você defina uma taxa menor.
- **Intervalo**: 0% a 100%, armazenado como um
sampling_fractionentre 0 e 1. - Cada linha de log grava a taxa aplicada em sua coluna
sampling_fraction.
Para definir a taxa na interface do usuário, insira uma **taxa de amostragem (%)** ao habilitar as tabelas de inferência na seção AI Gateway. Para configurá-lo programaticamente, especifique sampling_fraction na configuração de telemetria do endpoint.
Volume de ponto de verificação interno
Para dar suporte a tabelas de inferência habilitadas pelo AI Gateway (legado), o Databricks cria um volume interno no esquema da tabela de inferência. O volume tem um nome gerado pelo sistema no formato <catalog>.<schema>.<payload table ID>_checkpoints. A exclusão desse volume pode deixar as tabelas de inferência mal formatadas. O Databricks exclui automaticamente o volume quando você exclui o endpoint de servindo modelo correspondente.
Limitações
-
A entrega de log da tabela de inferência para servindo modelo endpoints que disponibilizam modelos personalizados leva cerca de 2 horas.
-
A entrega de log das tabelas de inferência para endpoints de servindo modelo que atendem a cargas de trabalho da API de Modelo Base, modelos externos ou agentes é atualmente um melhor esforço. Você pode esperar que os logs estejam disponíveis dentro de 1 hora após uma solicitação. Entre em contato com sua equipe de account da Databricks para obter mais informações.
-
O tamanho máximo de solicitação, resposta e rastreamento que são registrados é 1 MiB (1.048.576 bytes). Payloads que excedem isso são log como
nullelogging_error_codessão preenchidos comMAX_REQUEST_SIZE_EXCEEDEDouMAX_RESPONSE_SIZE_EXCEEDED. -
Tabelas de inferência para otimizados por rota endpoints de servindo modelo estão em pré-visualização pública.
-
Logs da tabela de inferência não têm garantia de serem preenchidos se o endpoint de servindo modelo retornar um erro.
- Para endpoints de modelo personalizados, os logs podem não ser registrados para quaisquer erros 4xx ou 5xx.
- Para outros endpoints, os registros podem não ser gravados para erros 401, 403, 429 ou 500.
Para obter limitações específicas do AI Gateway (legado), consulte Limitações. Para ver limitações gerais do endpoint de servindo modelo, consulte Limites e regiões de serviço do modelo.