Dimensionar a taxa de transferência do endpoint de Pesquisa de IA com QPS alto
Por default, endpoints padrão suportam 20–200 QPS dependendo do tamanho do índice. Aplicações em tempo real, como barras de pesquisa, sistemas de recomendação e correspondência de entidades, frequentemente exigem 100 a 1.000+ QPS. Somente em endpoints padrão, é possível definir um QPS alvo. A Databricks provisiona a infraestrutura para melhor corresponder àquele nível de taxa de transferência (melhor esforço, não garantido).
A definição de um QPS alvo provisiona capacidade adicional, o que aumenta o custo do endpoint. É cobrado por essa capacidade adicional independentemente do tráfego real de query. O escalonamento de throughput é de melhor esforço e não é garantido.
Usar alta QPS quando:
- Seu aplicativo requer mais de 50 QPS de taxa de transferência sustentada.
- Você recebe erros 429 (excesso de solicitações) sob carga normal.
- A latência é comprometida com o aumento do tráfego, mesmo quando a utilização média aparenta ser baixa.
Requisitos
-
Alta QPS está disponível apenas para endpoints padrão. Endpoints otimizados para armazenamento não são suportados.
-
Use a autenticação OAuth para entidade de serviço e o URL do índice para cargas de trabalho de produção de alto QPS. Tokens de acesso pessoal (PATs) e o URL de consulta do workspace são apropriados para prototipagem, mas não usam a rota de consulta otimizada e são limitados a algumas dezenas de QPS.
-
Se o workspace tiver um objeto de configurações de acesso privado anexado, nenhum índice no workspace poderá usar a rota de query otimizada, independentemente do tipo de índice ou das configurações do objeto.
- Os Workspace que usam o Private Service Connect para conectividade de front-end ou back-end têm um objeto de configurações de acesso privado.
- Nessa configuração, as queries usam a URL de query do workspace, que é limitada a algumas dezenas de QPS, portanto, o endpoint não pode atingir um alvo de QPS mais alto.
- Para cargas de trabalho de alto QPS, use um workspace que não tenha um objeto de configurações de acesso privado anexado. Se você não puder usar um workspace diferente, entre em contato com sua equipe de account do Databricks.
-
Os índices de sincronização Delta que usam modelos de incorporação gerenciados não podem usar a rota de query otimizada se o workspace tiver o recurso de lista de acesso IP habilitado.
- Nessa configuração, as queries ao índice usam a URL de query do workspace, que é limitada a algumas dezenas de QPS, portanto o endpoint não pode atingir um alvo de QPS mais alto. Isso se aplica a todas as queries ao índice, incluindo queries que passam
query_vector. - : Em um workspace sem um objeto de configurações de acesso privado, use incorporações autogerenciadas para atingir seu QPS de destino: um índice de sincronização Delta com uma coluna de vetor de incorporação ou um índice de acesso vetorial direto. : Consulte opções para fornecer incorporações.
- Nessa configuração, as queries ao índice usam a URL de query do workspace, que é limitada a algumas dezenas de QPS, portanto o endpoint não pode atingir um alvo de QPS mais alto. Isso se aplica a todas as queries ao índice, incluindo queries que passam
Configurar QPS alvo
Defina um QPS alvo ao criar um novo endpoint ou ao atualizar um existente. A capacidade adicional necessária para melhor corresponder ao throughput alvo é provisionada automaticamente. O escalonamento de throughput é de melhor esforço e não é garantido: o QPS real depende do tamanho do índice, dimensionalidade do vetor, complexidade da query e uso do filtro.
- Databricks UI
- Python SDK
- REST API
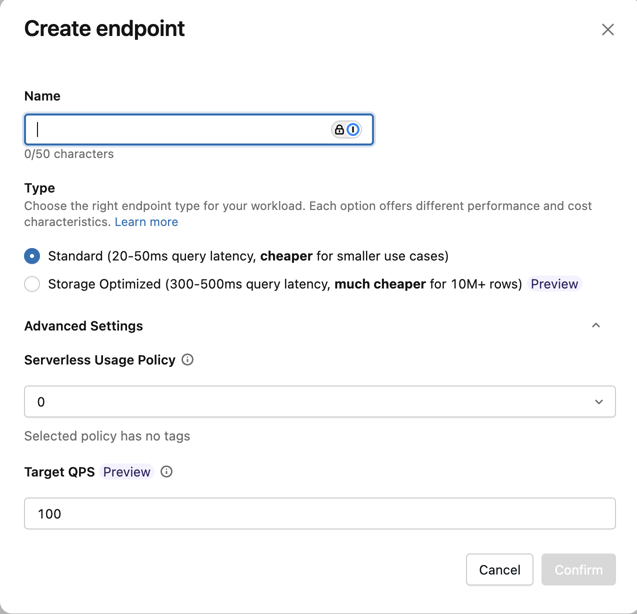
Ao criar um novo endpoint:
-
Na barra lateral esquerda, clique em Compute .
-
Clique na tab Pesquisa de IA e clique em Criar endpoint .

-
Em Configurações avançadas , insira o valor de QPS alvo .
Ao atualizar um endpoint existente:
-
Acesse a página de detalhes do endpoint.
-
No painel direito, clique no ícone de lápis
 ao lado de **QPS alvo**.

-
Insira o novo valor e clique em Salvar .

from databricks.ai_search.client import AISearchClient

client = AISearchClient()

# Create a new endpoint with target QPS
endpoint = client.create_endpoint(
    name="my-high-qps-endpoint",
    endpoint_type="STANDARD",
    target_qps=500,
)

# Update an existing endpoint's target QPS
response = client.update_endpoint(name="my-endpoint", target_qps=500)

# Check scaling status
scaling_info = response.get("endpoint", {}).get("scaling_info", {})
print(f"Requested target QPS: {scaling_info.get('requested_target_qps')}")
print(f"State: {scaling_info.get('state')}")
# State is "SCALING_CHANGE_IN_PROGRESS" while capacity is being provisioned,
# then transitions to "SCALING_CHANGE_APPLIED"
Criar um endpoint com QPS alvo
POST /api/2.0/vector-search/endpoints
{
  "name": "my-high-qps-endpoint",
  "endpoint_type": "STANDARD",
  "target_qps": 500
}
Atualizar QPS alvo em um endpoint existente:
PATCH /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
{
  "target_qps": 500
}
Verificar status de escalonamento:
GET /api/2.0/vector-search/endpoints/<ENDPOINT_NAME>
O campo scaling_info da resposta mostra o requested_target_qps e o dimensionamento state. O estado é SCALING_CHANGE_IN_PROGRESS enquanto a capacidade está sendo provisionada, e depois transiciona para SCALING_CHANGE_APPLIED.
Configurar um Service Principal
As consultas de alto QPS precisam de um token OAuth com authorization_details para o índice. Use um service principal para produção. Para configurar o service principal:
-
Adicione uma Service Principal e atribua-a ao Workspace que contém o índice.
-
Criar um segredo OAuth para o Service Principal:
-
Siga os passos em Criar um segredo do OAuth.
-
Em Escopos , selecione os escopos mais restritos que seu cliente suporta. Um tokens não pode exceder os escopos do seu segredo.
- Execução teste de carga na página do Endpoint do AI Search, o Notebook de teste de carga e
databricks-ai-search0.81 e acima: selecionevector-search, maismodel-servingse o índice usar um modelo de embedding gerenciado pelo Databricks. Esses clientes solicitamall-apisprimeiro e usam escopos mais restritos se o segredo não permitir. Para que o SDK solicite exatamente os escopos que você escolher, passe-os no parâmetrooauth_scopesdeAISearchClient, por exemplooauth_scopes=["vector-search", "model-serving"]. Se o índice fizer embedding por meio de um serviço de modelo do Unity Catalog, selecione tambémai-gatewaye inclua-o emoauth_scopesse você definir esse parâmetro. O Notebook e o SDK usam escopos que incluemai-gateway, mas Execução teste de carga na página do Endpoint não o solicita, portanto, use um segredo comall-apispara essa página. - Versões anteriores do
databricks-ai-searche a solicitação de tokens REST em Como fazer query em um índice de pesquisa de AI: Selecione todas as APIs . Esses clientes solicitam o escopoall-apis, então um segredo limitado a escopos mais restritos não consegue obter um token para eles. Especifique quais recursos o service principal do App Space acessará.
- Execução teste de carga na página do Endpoint do AI Search, o Notebook de teste de carga e
-
Armazene o ID do cliente e o segredo em um Secret Scope em vez de no código do seu aplicativo.
-
-
Conceda à Service Principal os seguintes privilégios do Unity Catalog:
- USE CATALOG no catálogo que contém o índice.
- USE SCHEMA no esquema que contém o índice.
- SELECIONE no índice.
- SELECT e MODIFY no índice, se o service principal fizer upsert ou excluir dados em um índice de acesso vetorial direto.
Se o service principal possuir o índice, ele não precisará de SELECT ou MODIFY, mas ainda precisará de USE CATALOG e USE SCHEMA.
-
Para um índice que usa um modelo de incorporação gerenciar pelo Databricks, conceda permissões no Endpoint de servindo modelo de incorporação e, se o índice definir
model_endpoint_name_for_query, nesse endpoint também. A permissão necessária depende do tipo de endpoint:- Endpoint de APIs do Foundation Model pay-per-token , como
databricks-gte-large-en: Nenhuma concessão é necessária, a menos que sua account restrinja os modelos de base com permissões do Unity Catalog. Nesse caso, conceda EXECUTE no modelo. - throughput provisionada e endpoints de serviço personalizados : Conceda Can Query para query com
query_text. Conceda pelo menos Can View mesmo que você query apenas comquery_vectore use o Python SDK, porqueget_index()lê esses Endpoint de serviço e falha sem permissão.
- Endpoint de APIs do Foundation Model pay-per-token , como
Fazer query de um índice não requer nenhuma permissão no próprio Endpoint de Pesquisa de AI.
A Service Principal autentica com autorização OAuth máquina a máquina (M2M). O token OAuth deve incluir authorization_details que permitam ReadVectorIndex no índice, ou WriteVectorIndex para upserts e deletes.
Se o Endpoint de servindo modelo de incorporação ou o Endpoint model_endpoint_name_for_query estiver otimizado para rota, o token também precisará de uma entrada workspace_permission que permita query_inference_endpoint em cada um. Para verificar se um endpoint de serviço está otimizado para rota, consulte o campo route_optimized retornado por GET /api/2.0/serving-endpoints/<name>.
- Python SDK : passe o ID do cliente e o segredo para
AISearchClient, conforme mostrado em query o URL do índice. O SDK solicita um tokens com oauthorization_detailsnecessário e adiciona as entradas do Endpoint de atendimento automaticamente. Para um Endpointmodel_endpoint_name_for_queryotimizado para rotas, isso requerdatabricks-ai-search0.79 ou acima. - API REST : Solicite o token você mesmo. Consulte o exemplo de Service Principal na tab API REST de Como fazer query de um índice de Pesquisa de AI.
Para testes, você também pode usar um tokens obtido por meio de troca de tokens de notebook. Use um service principal para produção. Para query um índice do Delta Sync que usa um modelo de embedding gerenciado pelo Databricks com query_text, use um token de Service Principal, porque o Endpoint de servindo modelo de embedding pode rejeitar um token da troca de token de Notebook com um erro 403.
As alterações de privilégio se aplicam apenas aos tokens recém-emitidos. A revogação de um privilégio não invalida um token que já foi emitido. Esse tokens permanece válido até expirar, o que leva até uma hora. Com o SDK Python, chame get_index() novamente depois de alterar os privilégios ou a configuração do endpoint de servir embedding. Os chamadores REST devem solicitar um novo token.
query o URL do índice
Depois que o estado de dimensionamento do Endpoint for SCALING_CHANGE_APPLIED, envie query para o URL do índice usando tokens OAuth com authorization_details para o índice, como um token de service principal. Este URL é necessário para usar a capacidade de query adicional com provisionamento por target_qps.
Para aplicativos Python, chame get_index() uma vez e reutilize o objeto de índice retornado. O Python SDK envia queries para a URL do Índice.
from databricks.ai_search.client import AISearchClient

client = AISearchClient(
    service_principal_client_id="...",
    service_principal_client_secret="...",
    workspace_url="https://<workspace-url>",
)

index = client.get_index(endpoint_name="my-high-qps-endpoint", index_name="catalog.schema.index")

# Reuse this index object for every query.
index.similarity_search(query_vector=[...], columns=["id", "text"], num_results=10)
Para aplicações REST ou que não sejam Python, primeiro obtenha o URL do índice e, em seguida, envie solicitações de query para esse URL. O token deve ser um token OAuth com authorization_details para o índice. Use um Service Principal para produção.
export WORKSPACE_URL=https://<workspace-url>
export INDEX_NAME=catalog.schema.index
export TOKEN=<oauth-token>

export INDEX_URL=$(curl -X GET \
  -H "Authorization: Bearer $TOKEN" \
  "$WORKSPACE_URL/api/2.0/vector-search/indexes/$INDEX_NAME" \
  | jq -r '.status.index_url')

case "$INDEX_URL" in
  http://*|https://*) ;;
  *) INDEX_URL="https://$INDEX_URL" ;;
esac

curl -X POST \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  "$INDEX_URL/query" \
  --data '{"num_results": 10, "query_vector": [...], "columns": ["id", "text"]}'
Não use o URL de query do workspace, como /api/2.0/vector-search/indexes/<index_name>/query, para tráfego de produção de alto QPS. Esse URL não usa a rota de consulta otimizada e pode retornar erros 429 antes que o endpoint atinja o QPS de destino configurado.
Como o dimensionamento se aplica
Depois de definir um QPS alvo, a capacidade necessária é provisionada automaticamente. O novo nível de throughput é aplicado após a conclusão do provisionamento. Você não precisa sincronizar índices para Trigger a alteração.
O provisionamento pode levar de minutos a horas, dependendo do tamanho do índice e de quanto o QPS de destino muda. Para acompanhar o progresso, verifique o scaling_info.state do endpoint até que esteja SCALING_CHANGE_APPLIED.
Um estado de Endpoint ONLINE não significa que seus índices estão prontos para query. Ao criar o primeiro índice em um endpoint, o índice permanece em PROVISIONING_ENDPOINT enquanto o compute do endpoint é criado. Verifique status.ready e status.detailed_state do índice antes de enviar o tráfego.
A tentativa de atualizar o QPS alvo enquanto uma operação de escalonamento está em andamento retorna um erro RESOURCE_CONFLICT. Aguarde a conclusão da operação atual antes de tentar novamente.
Solucionar problemas de erros 429
Para cargas de trabalho de alto QPS, use estas verificações para encontrar o gargalo:
-
Se você usar um PAT ou a URL de query do workspace, alterne para autenticação OAuth de service principal e a URL de índice.
-
Se
scaling_info.stateforSCALING_CHANGE_IN_PROGRESS, aguarde até que o estado mude paraSCALING_CHANGE_APPLIED. -
Se o seu aplicativo envia queries de vetor com
query_vector, o modelo de embedding não está no caminho da query. Se os erros 429 continuarem após a conclusão do escalonamento, reduza a simultaneidade da solicitação ou defina umtarget_qpsmais alto. O QPS alvo assume queries de vetor que retornam cerca de 10 resultados. Queries híbridas e valores denum_resultsmaiores usam mais capacidade por query, portanto, defina umtarget_qpsmais alto para eles e faça um teste de query de carga em sua carga de trabalho. -
Se o aplicativo enviar consultas de texto para um índice Delta Sync com modelos de incorporação gerenciados pelo Databricks, o modelo de incorporação pode ser o gargalo. Use um modelo de incorporação menor, como
databricks-qwen3-embedding-0-6b, em vez dedatabricks-gte-large-en, ou use um endpoint provisionado de Taxa de transferência para Foundation Model APIs ou outro endpoint dedicado de Model Serving para incorporações.Os endpoints de embedding de um índice são definidos quando você cria o índice, portanto, para usar um endpoint de embedding diferente, como um endpoint de throughput provisionado, crie um novo índice. Ao criá-lo, você pode manter o modelo de embedding de ingestão e definir apenas um endpoint de query separado que fornece o mesmo modelo com
model_endpoint_name_for_query.
Limitações
- No autoscale : é preciso definir o QPS alvo manualmente com base no tráfego esperado. Se o tráfego exceder o nível de provisionamento, erros 429 ocorrerão. Ver Plano para picos de consulta
- Somente endpoints padrão: endpoints otimizados para armazenamento não
target_qpssuportam. - Rota otimizada necessária : o QPS de destino configurado se aplica ao tráfego que usa autenticação OAuth de entidade de serviço e o URL do índice. O tráfego PAT e o tráfego de URL de consulta do workspace são limitados a algumas dezenas de QPS.
- Os modelos de embedding gerenciados podem adicionar um segundo limite : Para índices de Delta Sync que usam um endpoint de servindo modelo de embedding gerenciado para queries de texto, o throughput da query também depende do endpoint de servindo modelo de embedding. O QPS de destino não altera a capacidade desse endpoint de servindo modelo. Aumente a capacidade de servindo modelo, use throughput provisionado ou use embeddings autogerenciados para um throughput de query previsível.