Migre da compute clássica para a compute serverless
Migre suas cargas de trabalho da compute clássica para a compute serverless . compute sem servidor lida automaticamente com o provisionamento, o escalonamento, as atualizações de tempo de execução e a otimização.
A maioria das cargas de trabalho clássicas pode ser migrada com alterações mínimas ou nenhuma alteração de código. Esta página se concentra nessas cargas de trabalho. Alguns recursos, como df.cache, ainda não são suportados em serverless, mas não exigirão alterações de código quando estiverem disponíveis. Determinadas cargas de trabalho que dependem de R ou Scala Notebook exigem compute clássica e não poderão ser migradas para serverless. Para obter uma lista completa das limitações atuais, consulte Limitações compute sem servidor.
Migre com o agente de migração
Beta
Este recurso está em Beta. Workspace administrators can enable it from the Previews page by opting into the Compute Agent preview. See Gerenciar Databricks previews.
Você pode usar um agente de migração para migrar um único notebook ou job para o compute serverless. O agente analisa o ambiente, as bibliotecas, as configurações do Spark, as tags e o código do workload e, em seguida, propõe cada alteração como uma sugestão individual para você aceitar ou rejeitar. As alterações aceitas são aplicadas no local e podem ser revertidas.
O que o agente revisa e altera
Área | O que o agente faz |
|---|---|
Ambiente e bibliotecas | Converte instalações de bibliotecas em uma especificação de ambiente serverless, incluindo instalações de |
Variáveis de ambiente | Traduz variáveis de ambiente do cluster para seus equivalentes serverless, preservando as referências de segredo do workspace e omitindo os valores gerenciados pela plataforma. |
Data and storage access | Reescreve caminhos incompatíveis com o serverless, como disco local, |
Configurações do Spark | Classifica cada configuração do Spark, comenta as configurações que podem ser removidas com segurança e sinaliza e remove as configurações que o serverless não aceita. Abrange configurações anexadas aos clusters e nos Notebooks. |
Código do Workload | Reescreve o código que o serverless não oferece suporte em equivalentes compatíveis, como operações RDD reescritas em operações DataFrame, e ajusta o código para o comportamento de SQL no modo ANSI no serverless. |
Tags | Traduz Cluster Tags personalizadas, como uma tag de centro de custo, para seus equivalentes Serverless. |
Modo de desempenho | Sugere um modo de desempenho com base na configuração do cluster. Consulte Escolher um modo de desempenho. |
Requisitos
-
Workspace admin access is recommended to ensure a complete migration. This is because the agent also inspects workspace-level global init scripts beyond the target workload. You might be able to migrate if you have
CAN MANAGEpermission on the workload, but without admin permissions, it can result in missing libraries, environment settings, or tags. -
Confirme se você tem acesso ao agente. Digite
/computeno Genie Code./computedeve aparecer no menu de preenchimento automático. Se ela não aparecer, um administrador do workspace deverá habilitar a prévia no seu workspace.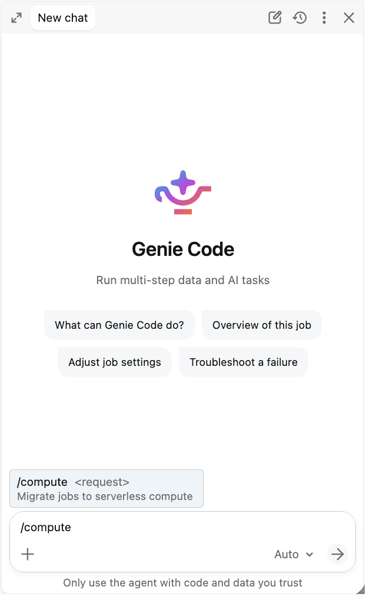
Migrar um notebook
- Abra o notebook que você deseja migrar.
- Abra o Genie Code e execute
/compute migrate to serverlessna paleta de comandos/. - Revise as descobertas do agente. O agente examina o ambiente, as bibliotecas e o código do notebook, e propõe uma alteração para cada item que precise de uma, como mover a instalação de uma biblioteca para uma especificação de ambiente ou reescrever uma célula de código para ser executada no serverless.
- Accept or reject each proposed change.
- Aplique as alterações que você aceitou. Eles são gravados no notebook localmente.
- Anexe o notebook ao Serverless e execute-o para confirmar se ele se comporta conforme o esperado. Consulte Verifying a migrated workload.
Migrar um job
- Abra o job que você deseja migrar.
- Abra o Genie Code e execute
/compute migrate to serverlessna paleta de comandos/. - O agente clona o seu job e tenta migrar o job clonado para serverless.
- Revise as descobertas do agente. Para um job com várias tarefas, o agente enumera cada tarefa e sua configuração de cluster por tarefa, e propõe alterações para cada uma enquanto preserva a programação do job.
- Accept or reject each proposed change across the migration surface: environment and bibliotecas, Spark configurations, and any workload code that must change.
- Aplique as alterações que você aceitou. O compute do job é alternado para serverless.
- Execute o job no serverless e confirme os resultados. Consulte Verifying a migrated workload.
- Opcionalmente, como etapa final, o agente promove o clone migrado. Ele copia a configuração e os notebooks do clone de volta para o seu job original diretamente (mantendo o mesmo ID de job, agendamento e permissões) e, em seguida, exclui o clone. Se você pular a promoção e mantiver ambos os jobs, pause o agendamento em qual job não estiver executando, ou o mesmo trigger acionará ambos e poderá duplicar gravações ou outros efeitos colaterais.
Verificar uma carga de trabalho migrada
O agente propõe e aplica alterações, mas não executa sua carga de trabalho nem verifica a saída dela. Sempre execute uma carga de trabalho migrada no serverless e confirme os resultados antes de confiar nela, especialmente para cargas de trabalho que gravam em tabelas de produção. Se o agente propuser uma alteração que pareça incorreta, rejeite-a e envie-nos um feedback para que possamos melhorar o agente. Consulte Submit produto feedback.
Enquanto valida uma carga de trabalho migrada, execute-a no modo otimizado para desempenho. Ele começa mais rápido do que o modo padrão, permitindo obter um feedback mais ágil ao confirmar os resultados. Mude para o modo que melhor se adapta à carga de trabalho antes de executá-la em produção. Consulte Escolher um modo de desempenho.
Quando o agente encontra algo que não pode migrar com segurança, ele relata um bloqueador e para por default. Você pode instruí-lo explicitamente a prosseguir após alguns bloqueadores de compatibilidade ou dependência, mas ao fazer isso, você aceita o risco de que essas dependências, a atribuição de custos ou o comportamento de runtime não sejam transferidos, e a carga de trabalho poderá falhar no serverless.
Reverter alterações da migração
As alterações aplicadas pelo agent são reversíveis.
For a notebook, open it and restore the revision from just before the migration. See Version history in Databricks notebooks.
No caso de um job, se você não promoveu o clone migrado, seu job original nunca foi alterado: execute-o como antes e exclua o clone. Se você promoveu o clone, restaure a partir do backup que o agent gravou antes de fazer qualquer alteração:
- Abra a pasta de backup na pasta inicial do seu workspace:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. O agente mostrou esse caminho durante a migração. Se houver vários Timestamp, escolha aquele de pouco antes da migração. - Open
job.yaml, which holds your pre-migration job settings, and apply those settings back to the same job with aPOST /api/2.2/jobs/resetrequest, which overwrites the job's settings with the ones you supply. You can also paste them into the job's JSON definition in the UI. This returns the job to classic compute. - Open
mapping.yaml, which lists each backed-up file and the original path it came from. Copy each backup file back over its original path to undo the code rewrites. - Execute o job para confirmar se ele se comporta como antes da migração.
A migração nunca exclui este backup. As tarefas que o agente não modificou, como tarefas de origem Git, SQL ou dbt, são registradas em job.yaml, mas os arquivos delas não são copiados para o backup. Portanto, restaure-os da sua fonte de verdade, se necessário.
Limitações conhecidas
-
Os seguintes itens são relatados como bloqueadores: imagens personalizadas, variantes do ML Runtime, versões do Databricks Runtime anteriores à 13, configurações do Spark que não podem ser ignoradas com segurança no serverless e dependências como arquivos eggs, JARs e bibliotecas do Maven. Um bloqueador significa que o agente é interrompido em vez de migrar esse item. Você pode resolver o problema por conta própria e executar a migração novamente ou instruir o agente a migrar de qualquer forma, o que deixa esse item não resolvido e pode fazer com que a carga de trabalho falhe no serverless.
-
The agent reads init scripts stored in workspace files or Unity Catalog volumes. Init scripts stored in GCS or DBFS cannot be read and are reported as blockers.
-
O agente não inspeciona todos os atributos de compute clássica. A entrega de logs do cluster e as chaves SSH não são modeladas e, embora detecte muitas dependências de montagem do DBFS a partir do código de carga de trabalho, ele não enumera nem resolve todas as montagens.
-
Cache and checkpoint APIs, global temporary views, DBFS mount-management calls, and Scala or R code are hard blockers by default. You can instruct the agent to proceed, but the unresolved functionality is left unchanged and may fail on serverless.
-
Jobs com mais de 10 tarefas passíveis de migração não podem ser migrados no momento.
-
O agente migra uma carga de trabalho por vez. Não há descoberta em toda a frota, migração em massa ou fluxo de trabalho de aprovação de administrador.
-
O agente propõe alterações e aplica as que você aceita, mas ele não executa sua carga de trabalho nem verifica a correção da saída. Verifique uma carga de trabalho migrada antes de confiar nela para dados de produção.
-
If your workload's source of truth is a Databricks Bundle de ativos or a Git folder, the agent applies changes to the workspace object in place. Reconcile those changes with your bundle or repository so that a later deploy does not overwrite the migration.
Migrate to serverless manually
Para migrar suas cargas de trabalho da compute clássica para a compute serverless , siga estes passos:
- Verifique os pré-requisitos : Certifique-se de que seu workspace, rede e acesso ao armazenamento cloud atendam aos requisitos. Consulte a seção " Antes de começar".
- Atualizar código : Faça todas as alterações necessárias no código e na configuração. Consulte Atualizar seu código.
- Teste suas cargas de trabalho : Valide a compatibilidade e a correção antes da migração. Consulte a seção "Teste suas cargas de trabalho".
- Escolha um modo de desempenho : Selecione o modo de desempenho que melhor se adapte aos requisitos da sua carga de trabalho. Consulte Escolher um modo de desempenho.
- Migre em fases : implemente a serverless de forma incremental, começando com cargas de trabalho novas e de baixo risco. Veja Migrar em fases.
- Monitore os custos : acompanhe o consumo DBU serverless e configure alertas. Consulte a seção Custos do Monitor.
Antes de começar
Antes de iniciar a migração, talvez seja necessário atualizar algumas configurações antigas em seu workspace.
Pré-requisito | Ação | Detalhes |
|---|---|---|
O espaço de trabalho está habilitado para Unity Catalog | Migre do Hive metastore se necessário. | |
Rede configurada | Substitua o peering de VPC por NCCs, Private Link ou regras de firewall. | |
acesso ao armazenamento em nuvem | Substitua os padrões legados de acesso a dados por locais externos do Unity Catalog. | Conectar ao armazenamento de objetos na cloud usando o Unity Catalog |
Atualize seu código
As seções a seguir listam as alterações de código e configuração necessárias para tornar suas cargas de trabalho compatíveis com serverless.
Acesso a dados
Os padrões de acesso a dados legados não são suportados em serverless. Atualize seu código para usar o Unity Catalog.
Padrão clássico | substituição sem servidor | Detalhes |
|---|---|---|
Caminhos DBFS ( | Volumes Unity Catalog | |
Tabelas Hive metastore | Tabelas Unity Catalog (ou Federação HMS ) | |
Credenciais account de armazenamento | Locais externos Unity Catalog | Conectar ao armazenamento de objetos na cloud usando o Unity Catalog |
JARs JDBC personalizados | Federação lakehouse |
O acesso DBFS é limitado em serverless. Atualize todos os caminhos dbfs:/ para volumes Unity Catalog antes da migração. Para obter mais informações, consulte Migrar arquivos armazenados em DBFS.
Exemplo: Substituir caminhos DBFS e referências Hive metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs e código
Determinadas APIs e padrões de código não são suportados em serverless. Consulte esta tabela para verificar se o seu código precisa ser atualizado.
Padrão clássico | substituição sem servidor | Detalhes |
|---|---|---|
APIs RDD ( | APIs de DataFrame | |
| Remover chamadas de cache | |
| Use | |
Variáveis do Hive ( | SQL | |
Configurações do Spark não suportadas | Remover configurações não suportadas. O modelo sem servidor ajusta automaticamente a maioria das configurações. | Configure as propriedades Spark para Notebooks e Jobs serverless . |
Exemplo: Substitua operações de RDD por DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Exemplo: Substitua SparkContext e cache.
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
biblioteca e ambientes
Você pode gerenciar bibliotecas e ambientes no nível workspace usando ambientes base e no nível do Notebook usando o ambienteserverless do Notebook.
Padrão clássico | substituição sem servidor | Detalhes |
|---|---|---|
Init scripts | ambientes sem servidor | |
biblioteca com escopo de cluster | Notebook- biblioteca de escopo ou ambiente | |
Maven/ BibliotecaJAR | Suporte a tarefas JAR para Job; PyPI para Notebook | |
contêineres Docker | Ambientes sem servidor para necessidades de bibliotecas |
fixe o pacote Python em requirements.txt para ambientes reproduzíveis. Consulte Especificar versões de pacotes Python.
transmissão
As cargas de trabalho do Transmissão são suportadas em serverless, mas certos gatilhos não são suportados. Atualize seu código para usar os gatilhos compatíveis.
Gatilho Spark | Apoiado | Notas |
|---|---|---|
| Sim | Recomendado |
| Sim | Isso está obsoleto. Use |
| Não | Devolve |
| Não | Use LakeFlow Pipelines no modo contínuo em vez disso. |
padrão (não definir | Não | Omitir |
Para transmissão contínua, migre para o pipeline declarativoSpark no modo contínuo ou use o Job de programação contínua com AvailableNow. Para fontes grandes, defina maxFilesPerTrigger ou maxBytesPerTrigger para evitar erros de falta de memória.
Exemplo: Corrigir gatilhos de transmissão
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Teste suas cargas de trabalho
- Teste rápido de compatibilidade : execute a carga de trabalho em compute clássico com o modo de acesso padrão e Databricks Runtime 14.3 ou superior. Se a execução for bem-sucedida, a carga de trabalho poderá migrar para serverless sem qualquer alteração de código.
- Comparação A/B (recomendada para produção): execução da mesma carga de trabalho em um ambiente clássico (controle) e em serverless (experimento). Compare as tabelas de saída e verifique se estão corretas. Repita o processo até que as saídas coincidam.
- Configurações temporárias : Você pode definir temporariamente configurações compatíveis com o Spark durante os testes. Remova-os assim que estiverem estáveis.
Selecione um modo de desempenho
Os recursos de tarefas e pipelines sem servidor oferecem suporte a dois modos de desempenho: padrão e otimizado para desempenho. O modo de desempenho que você escolher dependerá dos requisitos da sua carga de trabalho.
Mode | Disponibilidade | startup | Melhor para |
|---|---|---|---|
Standard | Jobs, Lakeflow pipelines | 4-6 minutos | lotes sensíveis ao custo |
Otimizado para desempenho | Notebooks, Jobs, LakeFlow Pipelines | Segundos | Interativo, sensível à latência |
Migrar em fases
- Novas cargas de trabalho : inicie todos os novos Notebooks e Jobs em serverless.
- Cargas de trabalho de baixo risco : Migre cargas de trabalho PySpark/SQL que já estejam no modo de acesso padrão e com Databricks Runtime 14.3 ou superior.
- Cargas de trabalho complexas : Migrar cargas de trabalho que necessitam de alterações de código (reescritas de RDD, atualizações de DBFS, correções de gatilhos).
- Carga de trabalho restante : Revisar periodicamente à medida que as capacidades se expandem.
Monitorar custos
A cobrança de serviços sem servidor é baseada no consumo DBU , não no tempo de atividade cluster . Antes de migrar em grande escala, valide as expectativas de custo com cargas de trabalho representativas. Para obter ferramentas e estratégias para monitorar os custos de computação serverless , consulte Monitorar o custo da compute serverless.
Recursos adicionais
- Melhores práticas para compute serverless: dicas de otimização para cargas de trabalho serverless
- Limitações compute sem servidor: Lista completa das limitações atuais e recursos não suportados.
- Configure o ambiente serverless: gerencie bibliotecas e dependências.
- Configurações Spark suportadas: Configurações Spark disponíveis em serverless
- Spark Connect vs. Sparkclássico: diferenças comportamentais na arquitetura serverless
- Segurança de rede sem servidor: NCCs, link privado e configuração de firewall
- compute sem servidor notas sobre a versão: Rastreie novos recursos à medida que são lançados
- Guia de atualizaçãoUnity Catalog: Migrar do Hive metastore para o Unity Catalog
Você também pode consultar a seguinte postagem no blog para mais informações:
- O que é computação serverless ?: Visão geral das capacidades da computação serverless e resultados obtidos por clientes.
- Evolução da engenharia de dados: como compute serverless está transformando Notebooks e LakeFlow Job: como serverless potencializa os trabalhos e pipelines LakeFlow