Materialização de dataset em dashboards AI/BI
Beta
Esse recurso está em Beta. Para usá-lo, o administrador de um workspace deve ativar AI/BI Dashboard Materialization na página Pré-visualizações . Consulte Gerenciar prévias do Databricks.
AI/BI dashboards are built on dashboard-scoped datasets. By default, every dataset is evaluated live, so each time a dashboard loads or a viewer interacts with it, the underlying queries, joins, and source scans run again on your SQL warehouse. For dashboards built on expensive source queries or many joins, rerunning those queries on every interaction is slow and costly.
A materialização de dataset faz o pré-computo e armazena os resultados por trás de um dataset, de modo que o trabalho pesado ocorra uma vez em uma programação, em vez de a cada carregamento ou interação do dashboard. As interações são renderizadas a partir dos resultados armazenados, o que torna os dashboards publicados mais rápidos.
Materialization uses Unity Catalog metric view materialization tecnología. See Materialization for metric views.
O que é materializado
A materialização faz pré-compute e armazena os dados do dataset. O que é armazenado difere entre os dois tipos de dataset:
- Para datasets SQL, o resultado completo da query é pré-computado e armazenado.
- Para métricas views locais, o modelo de dados em nível de linha (dados de origem, joins e campos de filtro) é armazenado, enquanto as medidas ainda são computadas no momento da query em relação à base pré-computada.
Benefícios
A materialização de dataset oferece os seguintes benefícios:
- Dashboards mais rápidos sem remodelação. Joins caros e varreduras de origem são executados uma vez em um agendamento, em vez de a cada carregamento, o que elimina a espera que os visualizadores experimentam quando um dashboard faz novas queries em tabelas grandes.
- Lower warehouse cost on read. Pre-computing the base data model avoids repeating the same heavy query for every viewer and every page load, which reduces redundant warehouse usage.
- Sem sobrecarga operacional. O Databricks cria, armazena e faz o refresh dos dados materializados para você. Não há nenhum pipeline, esquema ou armazenamento para gerenciar.
Custos
A materialização de dataset gera custos de armazenamento e compute:
- Armazenamento. You pay for storing the materialized data. Charges depend on the underlying storage used. Para obter uma visão geral do armazenamento no Unity Catalog, consulte Connect to cloud object storage using Unity Catalog.
- compute. Initial creation and refreshes run on serverless LakeFlow pipelines and incur compute charges. See LakeFlow Pipelines preços.
Pondere esses custos em relação à economia de evitar varreduras de fontes e junções repetidas. Escolha uma programação de refresh que equilibre a atualização de dados com os custos de compute.
When to use materialization
A materialização nem sempre é a alavanca certa para o desempenho. O benefício vem da substituição da recomputação completa e repetida de um dataset (varredura e junção) por leituras em uma tabela pré-computada. Materialize um dataset quando uma ou mais das seguintes situações se aplicarem:
- Dashboards altamente interativos. O dashboard possui muitos filtros, filtragem cruzada ou detalhamentos. Sem a materialização, cada interação executa novamente a query do dataset, portanto, pré-computar esses datasets vale a pena repetidamente em uma sessão.
- Expensive datasets. The dataset is built on multi-table joins, heavy views or common table expressions (CTEs), window functions, or unions across many tables.
- Filtros seletivos em tabelas grandes. O dataset seleciona um subconjunto pequeno, como uma região ou os últimos 7 dias de bilhões de linhas. A materialização armazena apenas o pequeno subconjunto.
- Tolerance for scheduled freshness. The data only needs to be as fresh as the dashboard's refresh schedule, such as hourly or daily, rather than tempo real.
For small datasets or dashboards that are rarely loaded, the live query is often fast enough, and materialization might not be worth the cost. Because materialization is opt-in per publish and per dataset, you can apply it only where it pays off.
Requisitos
- Acesso a um AI/BI dashboard.
- O dashboard é publicado com a opção Compartilhar permissões de dados . A materialização não é compatível com dashboards publicados com permissões de dados individuais. Veja O que são permissões de dados compartilhados?.
- Compute serverless habilitado no workspace. A criação inicial e o refresh são executados em Serverless LakeFlow Pipelines. Consulte Configurar SQL warehouses serverless.
- Permissão CAN USE em um SQL Warehouse executando o Databricks Runtime 17.3 e acima.
Ativar a materialização de datasets
Os datasets são selecionados para materialização por default, mas a materialização fica desativada para o dashboard até que você ative a opção Materialize datasets ao publicar.
Escolha quais datasets materializar
Na aba Data , clique no ícone de materialização ao lado de um dataset para incluí-lo ou excluí-lo.
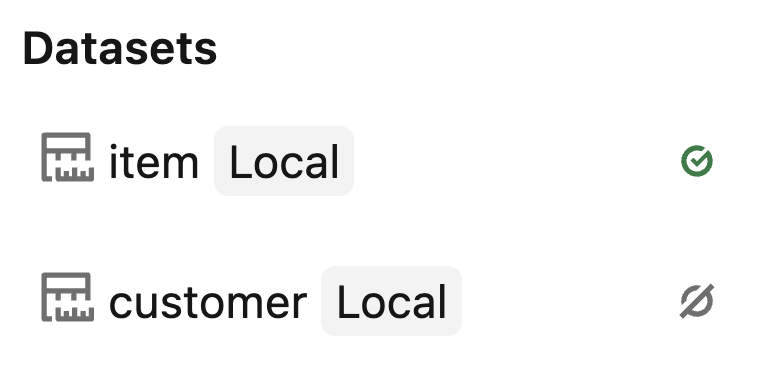
When you exclude a dataset from materialization, queries against that dataset return live results, while queries against materialized datasets reflect the latest materialization execução. When all datasets use the same materialization schedule, widgets have consistent data freshness.
Publicar com materialização
- Clique em Publicar no dashboard de rascunho.
- Selecione Share data permissions na caixa de diálogo de publicação.
- Ative a opção Materialize datasets para materializar os datasets selecionados na tab Data.
- Clique em Publicar .
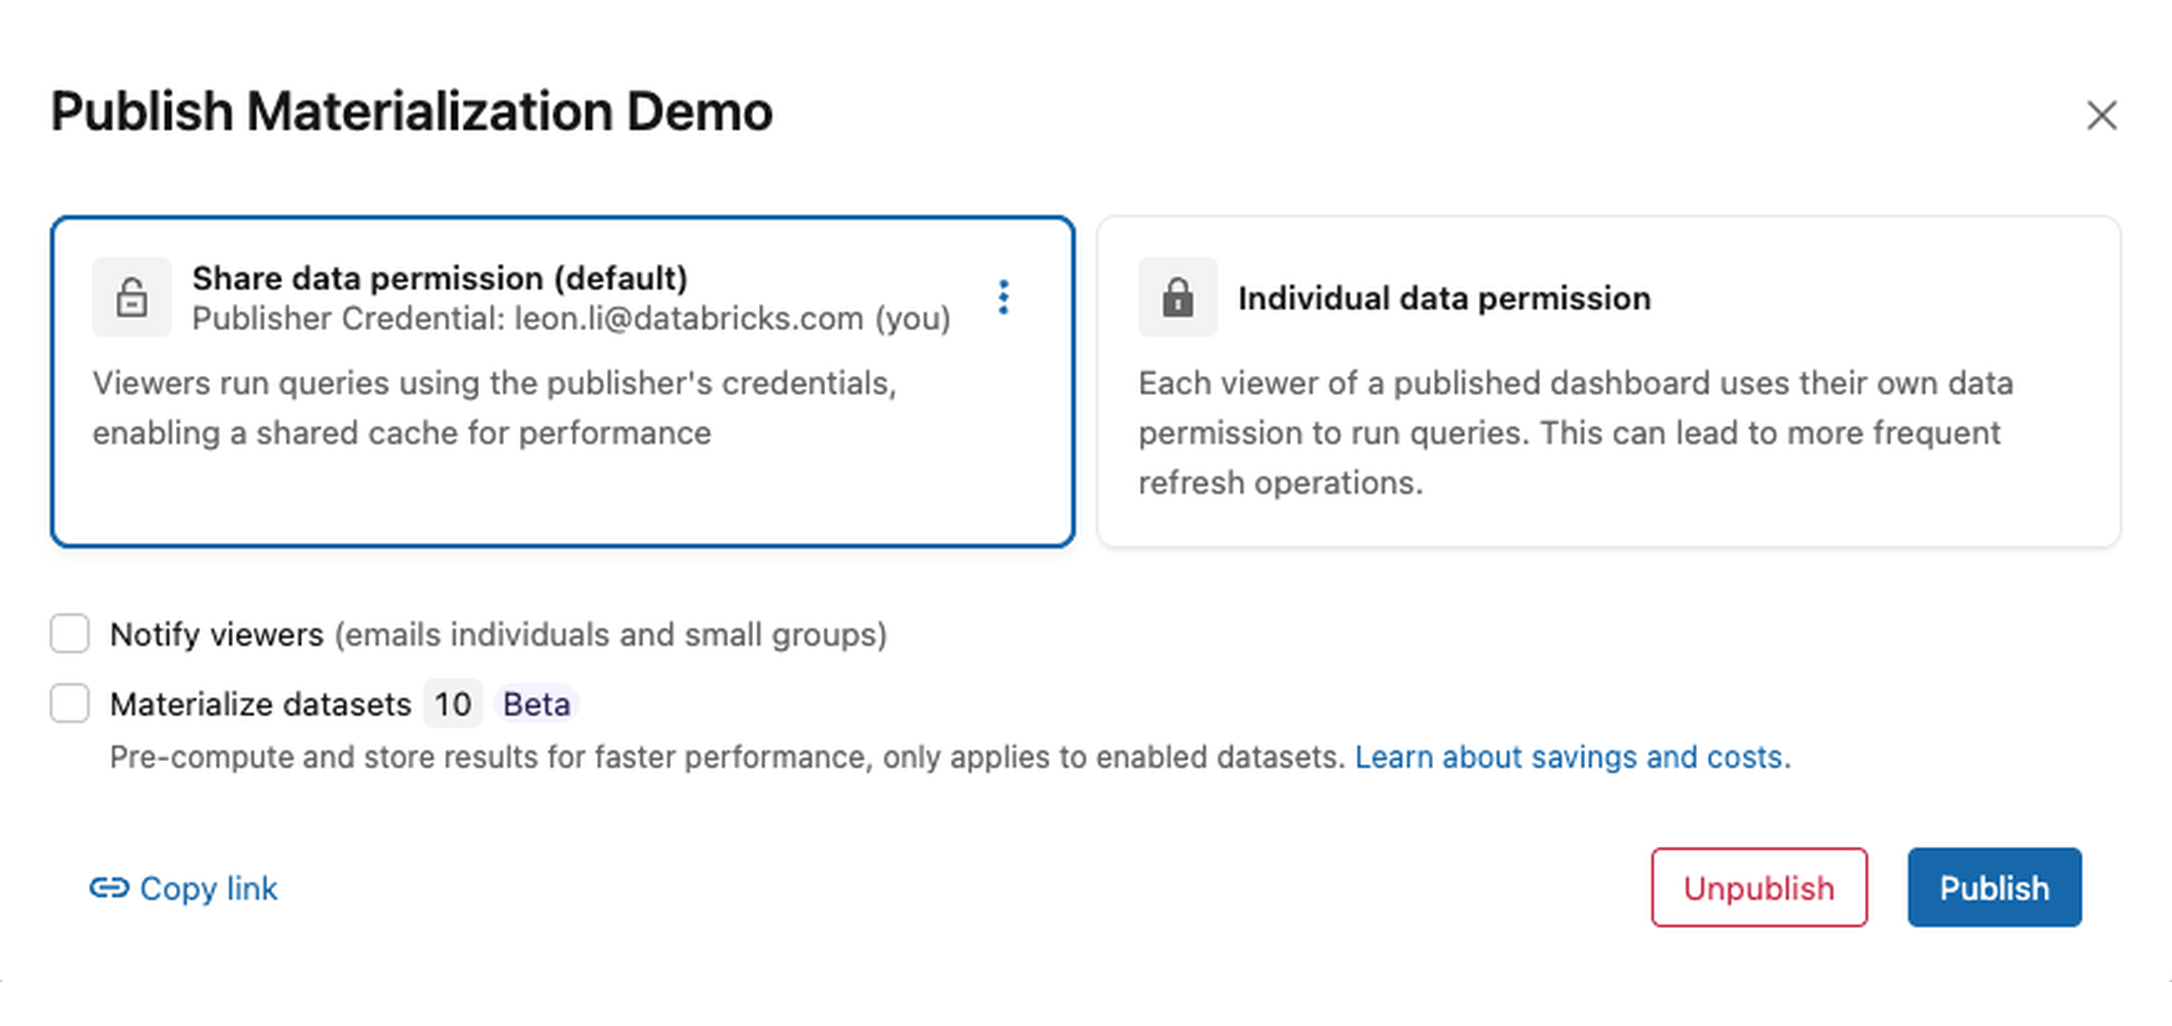
Ative a opção Materialize datasets em cada publicação.
Programar um refresh
Os dados materializados são atualizados de acordo com a programação de refresh do dashboard. Use o agendamento do dashboard para ajustar a frequência de refresh.
Se o painel não tiver nenhuma programação, a publicação com a materialização ativada adiciona uma programação de refresh diária. As programações existentes são preservadas. Sem um programar ativo, os dados materializados não fazem refresh automaticamente após a criação.
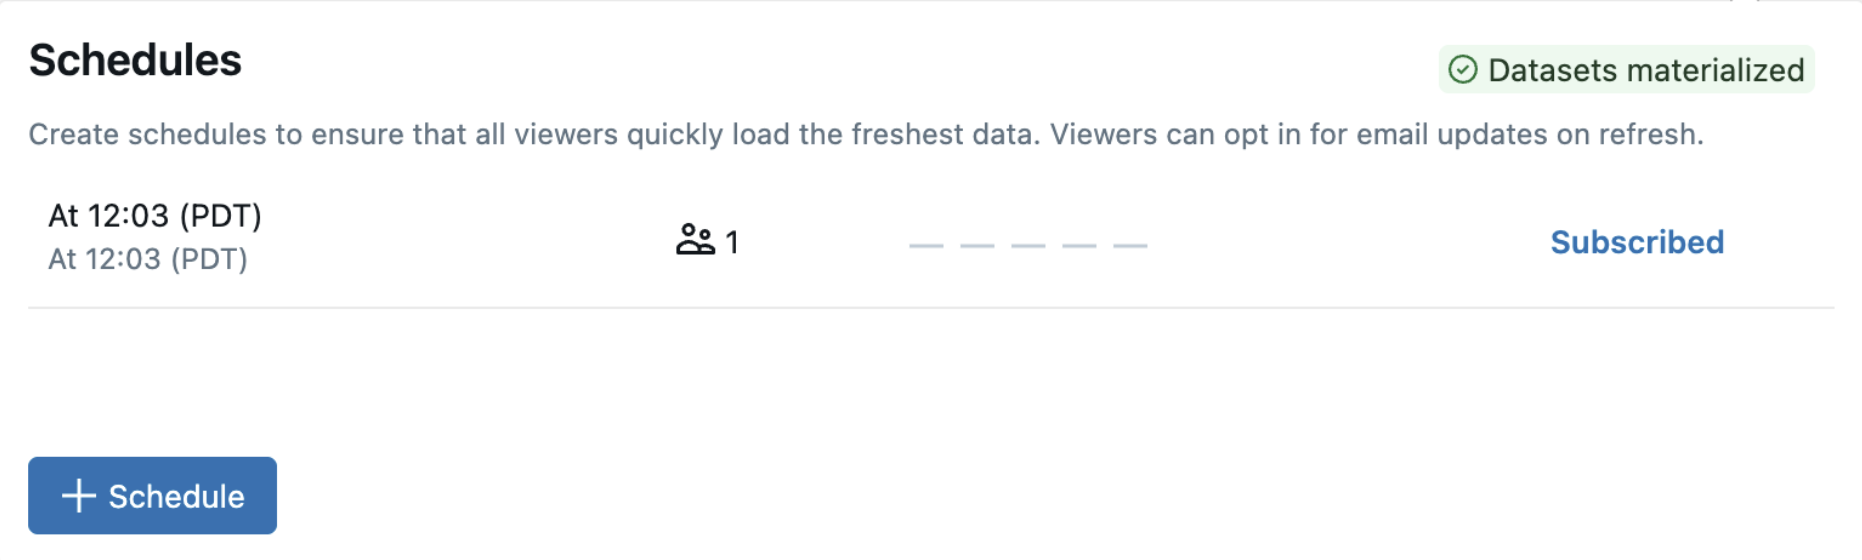
Status de materialização da view
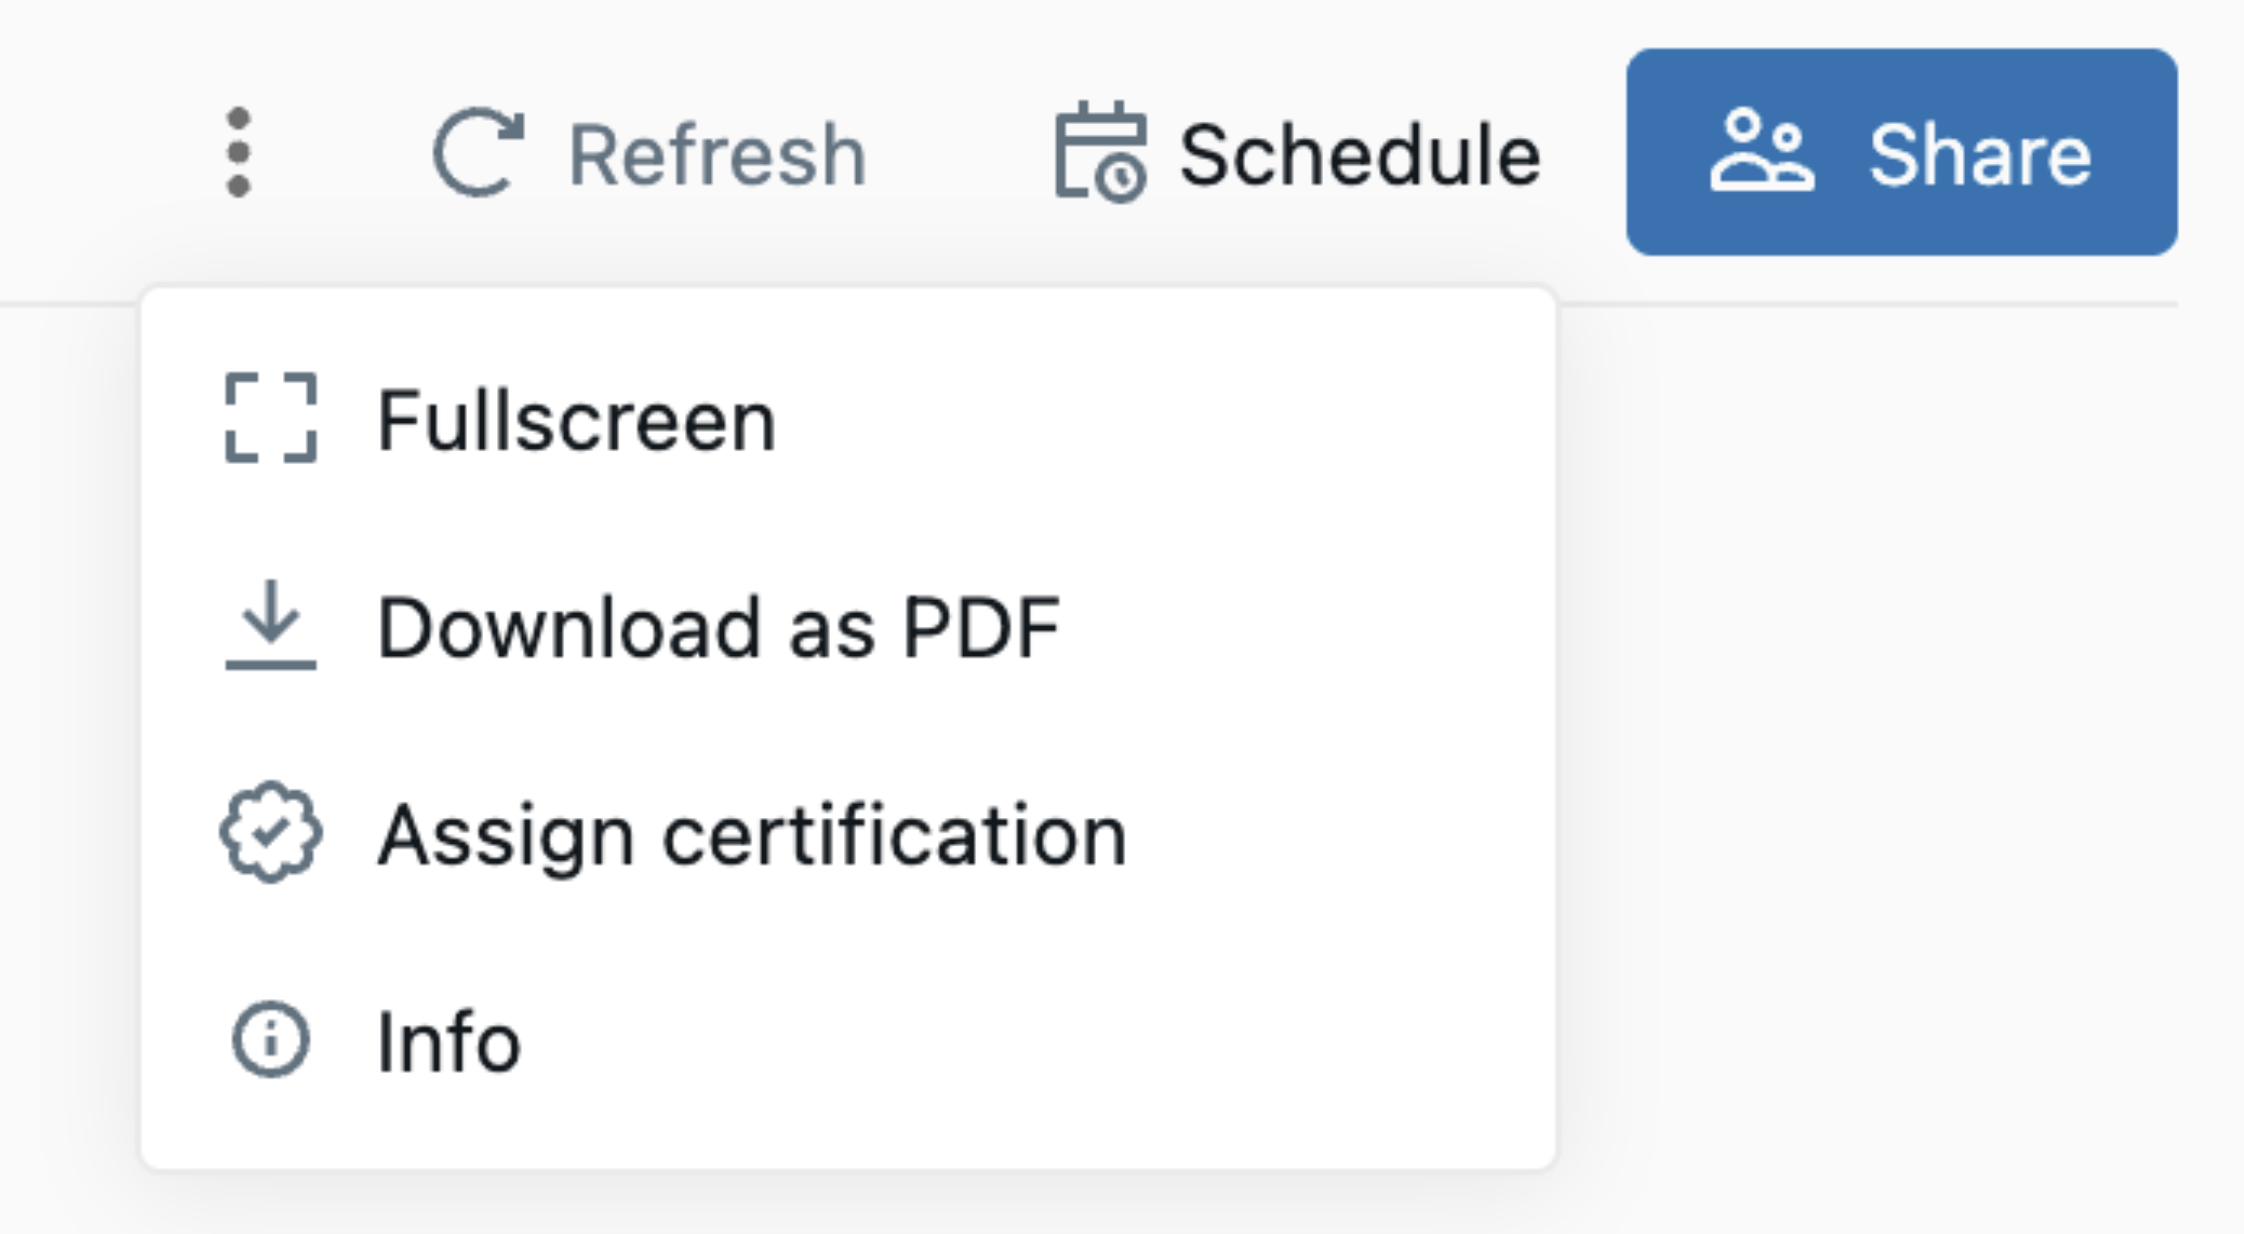
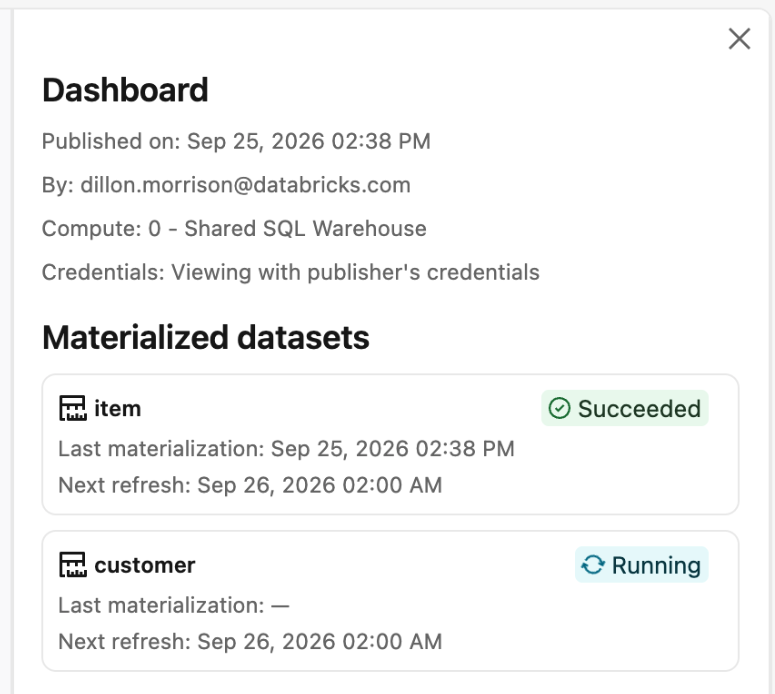
No dashboard publicado, abra o menu  e selecione Info . A barra lateral mostra o status e as informações de refresh de cada dataset materializado.
Reutilização e limpeza
O Databricks gerencia o ciclo de vida dos seus dados materializados:
- Reuse across revisions. If a dashboard is republished by the same user and a dataset is unchanged, the existing materialization will be reused, avoiding wasted compute.
- Limpeza automática. O Databricks descarta materializações que um dashboard publicado não referencia mais, como após uma alteração de definição ou um cancelamento de publicação.
Republishing does not necessarily refresh materialized data.
Limitations
A materialização de datasets tem as seguintes limitações:
- Apenas dashboards publicados. A materialização se aplica a dashboards publicados. Os rascunhos continuam a query dados ativos.
- Nenhum dataset parametrizado. Datasets que definem parâmetros não podem ser materializados. Se você optar por ativar a materialização em um dataset parametrizado, o Databricks relatará falha em vez de materializá-lo.
- O refresh segue apenas o agendamento do dashboard. Não há um agendamento de refresh separado por dataset. As materializações fazem refresh de acordo com a frequência de refresh agendada do seu dashboard.
- Serverless obrigatório. A criação inicial e os refresh são executados em LakeFlow Pipelines Serverless, portanto, o Workspace deve ter o compute Serverless habilitado.
- Dados protegidos não são fornecidos a partir de materializações. A materialização não pode ser criada para dados de origem protegidos por segurança em nível de linha, máscaras de coluna ou políticas de controle de acesso baseado em atributos (ABAC). Se a segurança em nível de linha for adicionada a uma tabela de origem após a criação da materialização, as queries subsequentes na view de métricas ignoram a materialização e são executadas nos dados de origem.
- Permissões de dados compartilhados necessárias. Você pode ativar a materialização somente ao publicar com permissões de dados compartilhados. Você não pode ativá-lo quando publica com permissões de dados individuais.
Perguntas frequentes
The following questions cover dataset materialization behavior, refreshes, and permissions.
A materialização altera minhas métricas ou resultados?
Materialization preserves the dataset's query logic, but its data reflects the latest successful refresh. For local métrica views, measures are computed at query time against the materialized data. See What gets materialized.
O que acontece se uma materialização não estiver pronta ou não estiver disponível?
Se uma materialização não estiver pronta ou não estiver disponível no momento da query, a query retornará um erro em vez de consultar dados dinâmicos. Aguarde a conclusão da materialização e execute novamente a query.
Where is the materialized data stored?
Databricks stores the materialized data in managed, internal storage scoped to your published dashboard. There is nothing for you to publish to Unity Catalog, and no schema or storage to gerenciar. Access continues to follow your dashboard and underlying data permissions.
Com que frequência os dados materializados refresh?
Os dados materializados fazem refresh de acordo com a agenda de atualização do dashboard. Consulte Definir uma agenda de refresh.
Qual compute a materialização usa?
A criação inicial e as atualizações são executadas em pipelines do Lakeflow Serverless gerenciados pelo Databricks. É por isso que o compute serverless deve estar habilitado no workspace.
A materialização afeta as permissões?
Não. A materialização não concede acesso adicional aos dados. O acesso ainda segue a configuração de compartilhamento do dashboard e as permissões usadas para publicá-lo.
O que acontece quando republico?
As materializações existentes podem ser reutilizadas quando o mesmo usuário republicar um dataset inalterado. Consulte Reutilização e limpeza. Ative a opção Materializar datasets a cada publicação.