Interaja programaticamente com os arquivos workspace
O senhor pode interagir com os arquivos workspace armazenados em Databricks de forma programática. Isso permite tarefas como:
- Armazenamento de pequenos arquivos de dados junto com o Notebook e o código.
- Gravação de arquivos log em diretórios sincronizados com Git.
- Importação de módulos usando caminhos relativos.
- Criação ou modificação de um arquivo de especificação de ambiente.
- Saída de gravação do Notebook.
- Escrever a saída da execução da biblioteca, como TensorBoard.
O senhor pode criar, editar, renomear e excluir arquivos workspace de forma programática em Databricks Runtime 11.3 LTS e acima. Essa funcionalidade é compatível com o Notebook em Databricks Runtime 16.2 e acima, e serverless environment 2 e acima.
Para desativar a gravação em arquivos workspace, defina a variável de ambiente WSFS_ENABLE_WRITE_SUPPORT=false de clustering. Para obter mais informações, consulte variável de ambiente.
No Databricks Runtime 14.0 e acima, o diretório de trabalho atual (CWD) default para o código executado localmente é o diretório que contém o Notebook ou script em execução. This is a change in behavior from Databricks Runtime 13.3 LTS and abaixo. See What is the default current working directory?.
On serverless compute, the working directory is not guaranteed, so use absolute paths to reference files. See Serverless compute limitations.
Leia a localização dos arquivos
Use shell comando para ler os locais dos arquivos, por exemplo, em um repositório ou no sistema de arquivos local.
Para determinar a localização dos arquivos, digite o seguinte:
%sh ls
- Os arquivos não estão em um repositório: O comando retorna o sistema de arquivos
/databricks/driver. - Os arquivos estão em um repositório: O comando retorna um repositório virtualizado, como
/Workspace/Repos/name@domain.com/public_repo_2/repos_file_system.
Ler dados workspace files
O senhor pode ler programaticamente pequenos arquivos de dados, como os arquivos .csv ou .json, a partir do código no Notebook. O exemplo a seguir usa o Pandas para consultar arquivos armazenados em um diretório /data relativo à raiz do repositório do projeto:
import pandas as pd
df = pd.read_csv("./data/winequality-red.csv")
df
O senhor pode usar o Spark para ler arquivos de dados. O senhor deve fornecer ao Spark o caminho totalmente qualificado.
- Os arquivos do espaço de trabalho nas pastas Git usam o caminho
file:/Workspace/Repos/<user-folder>/<repo-name>/path/to/file. - Os arquivos do espaço de trabalho em seu diretório pessoal usam o caminho:
file:/Workspace/Users/<user-folder>/path/to/file.
O senhor pode copiar o caminho absoluto ou relativo de um arquivo no menu dropdown ao lado do arquivo:
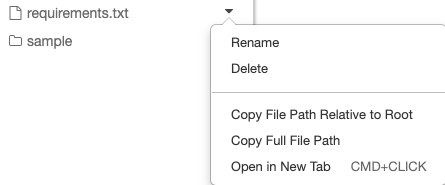
O exemplo abaixo mostra o uso de {os.getcwd()} para obter o caminho completo.
import os
spark.read.format("csv").load(f"file:{os.getcwd()}/my_data.csv")
Em um espaço de trabalho onde DBFS root e as montagens estão desativadas, você também pode usar dbfs:/Workspace para acessar arquivos workspace com utilitários Databricks . Isso requer Databricks Runtime 13.3 LTS ou superior. Consulte Desativar o acesso à DBFS root no seu workspace Databricks existente.
Para saber mais sobre arquivos no Databricks, consulte Trabalhar com arquivos no Databricks.
Crie, atualize e exclua arquivos e diretórios de forma programática
O senhor pode manipular programaticamente os arquivos workspace em Databricks, da mesma forma que trabalha com arquivos em qualquer sistema de arquivos padrão.
Em Databricks Runtime 16.2 e acima, e serverless environment 2 e acima, todas as interações programáticas com arquivos também estão disponíveis para o Notebook. Para obter informações sobre a conversão de um arquivo em um Notebook, consulte Converter um arquivo em um Notebook.
O diretório pai de um arquivo já deve existir antes de você gravar nele. O Databricks faz o buffer das gravações de arquivos e as descarrega no workspace de forma assíncrona; portanto, gravar em um caminho cujo diretório pai está ausente falha com AsyncFlushFailedException após a chamada de gravação, e não no momento em que você a faz. Crie o diretório pai primeiro, conforme mostrado no exemplo a seguir.
Os exemplos a seguir usam pacotes e funcionalidades Python padrão para criar e manipular arquivos e diretórios.
import os

# Create a new directory

os.mkdir('dir1')

# Create a new file and write to it

with open('dir1/new_file.txt', "w") as f:
    f.write("new content")

# Append to a file

with open('dir1/new_file.txt', "a") as f:
    f.write(" continued")

# Delete a file

os.remove('dir1/new_file.txt')

# Delete a directory

os.rmdir('dir1')
import shutil

# Copy a dashboard

shutil.copy("my-dashboard.lvdash.json", "my-dashboard-copy.lvdash.json")

# Move a query to a shared folder

shutil.move("test-query.dbquery","shared-queries/")
Resolver nomes de ativos duplicados
Em alguns casos, uma pasta do workspace já pode conter ativos com o mesmo nome. Por exemplo, duas queries SQL podem ter o mesmo nome My query. Isso pode ocorrer quando os ativos foram criados antes que a exclusividade de nome fosse totalmente aplicada.
Quando uma pasta contém nomes de ativos duplicados, o acesso baseado em arquivo à pasta falha, embora os ativos em si permaneçam inalterados. Você poderá ver erros como:
Name not unique on network(OSError: [Errno 76]) — por exemplo, quando você faz a execução delsou outros comandos no terminal web, ou lista a pasta a partir de Notebooks.File name conflictouRESOURCE_CONFLICT: Duplicate entities detected in the directory— por exemplo, durante operações em pastas Git.
Nomes duplicados não afetam os próprios ativos. Você ainda pode abrir e usar cada ativo a partir do navegador do workspace. Apenas os comandos que alcançam a pasta por meio do sistema de arquivos — como o terminal web, o WSFS ou operações de pastas do Git — são afetados.
Para encontrar ativos com nomes duplicados, execute o seguinte notebook. Ele examina uma pasta e suas subpastas e lista os ativos que compartilham o mesmo nome. O notebook é somente leitura e não renomeia nem exclui nenhum ativo.
Encontrar ativos de workspace duplicados
Para resolver nomes duplicados usando a IU do workspace:
- No navegador do workspace, abra cada pasta identificada pelo notebook.
- Renomeie ou exclua ativos duplicados até que cada ativo na pasta tenha um nome exclusivo.
Depois que todos os nomes de ativos na pasta forem exclusivos, o acesso baseado em arquivos voltará a funcionar.