Tipos de mensagem
Ao ingerir dados com os SDKs do Zerobus Ingest via gRPC, você escolhe como os registros são codificados em uma determinada transmissão. O Zerobus Ingest é compatível com quatro formatos de mensagem para que você possa equilibrar simplicidade, segurança de tipo e throughput para sua carga de trabalho: JSON, Protocol Buffers (protobuf), Apache Arrow e Avro (Beta). Cada formato é validado em relação ao esquema da sua tabela Delta antes que os dados sejam tornados duráveis. Consulte Gerenciamento de esquema.
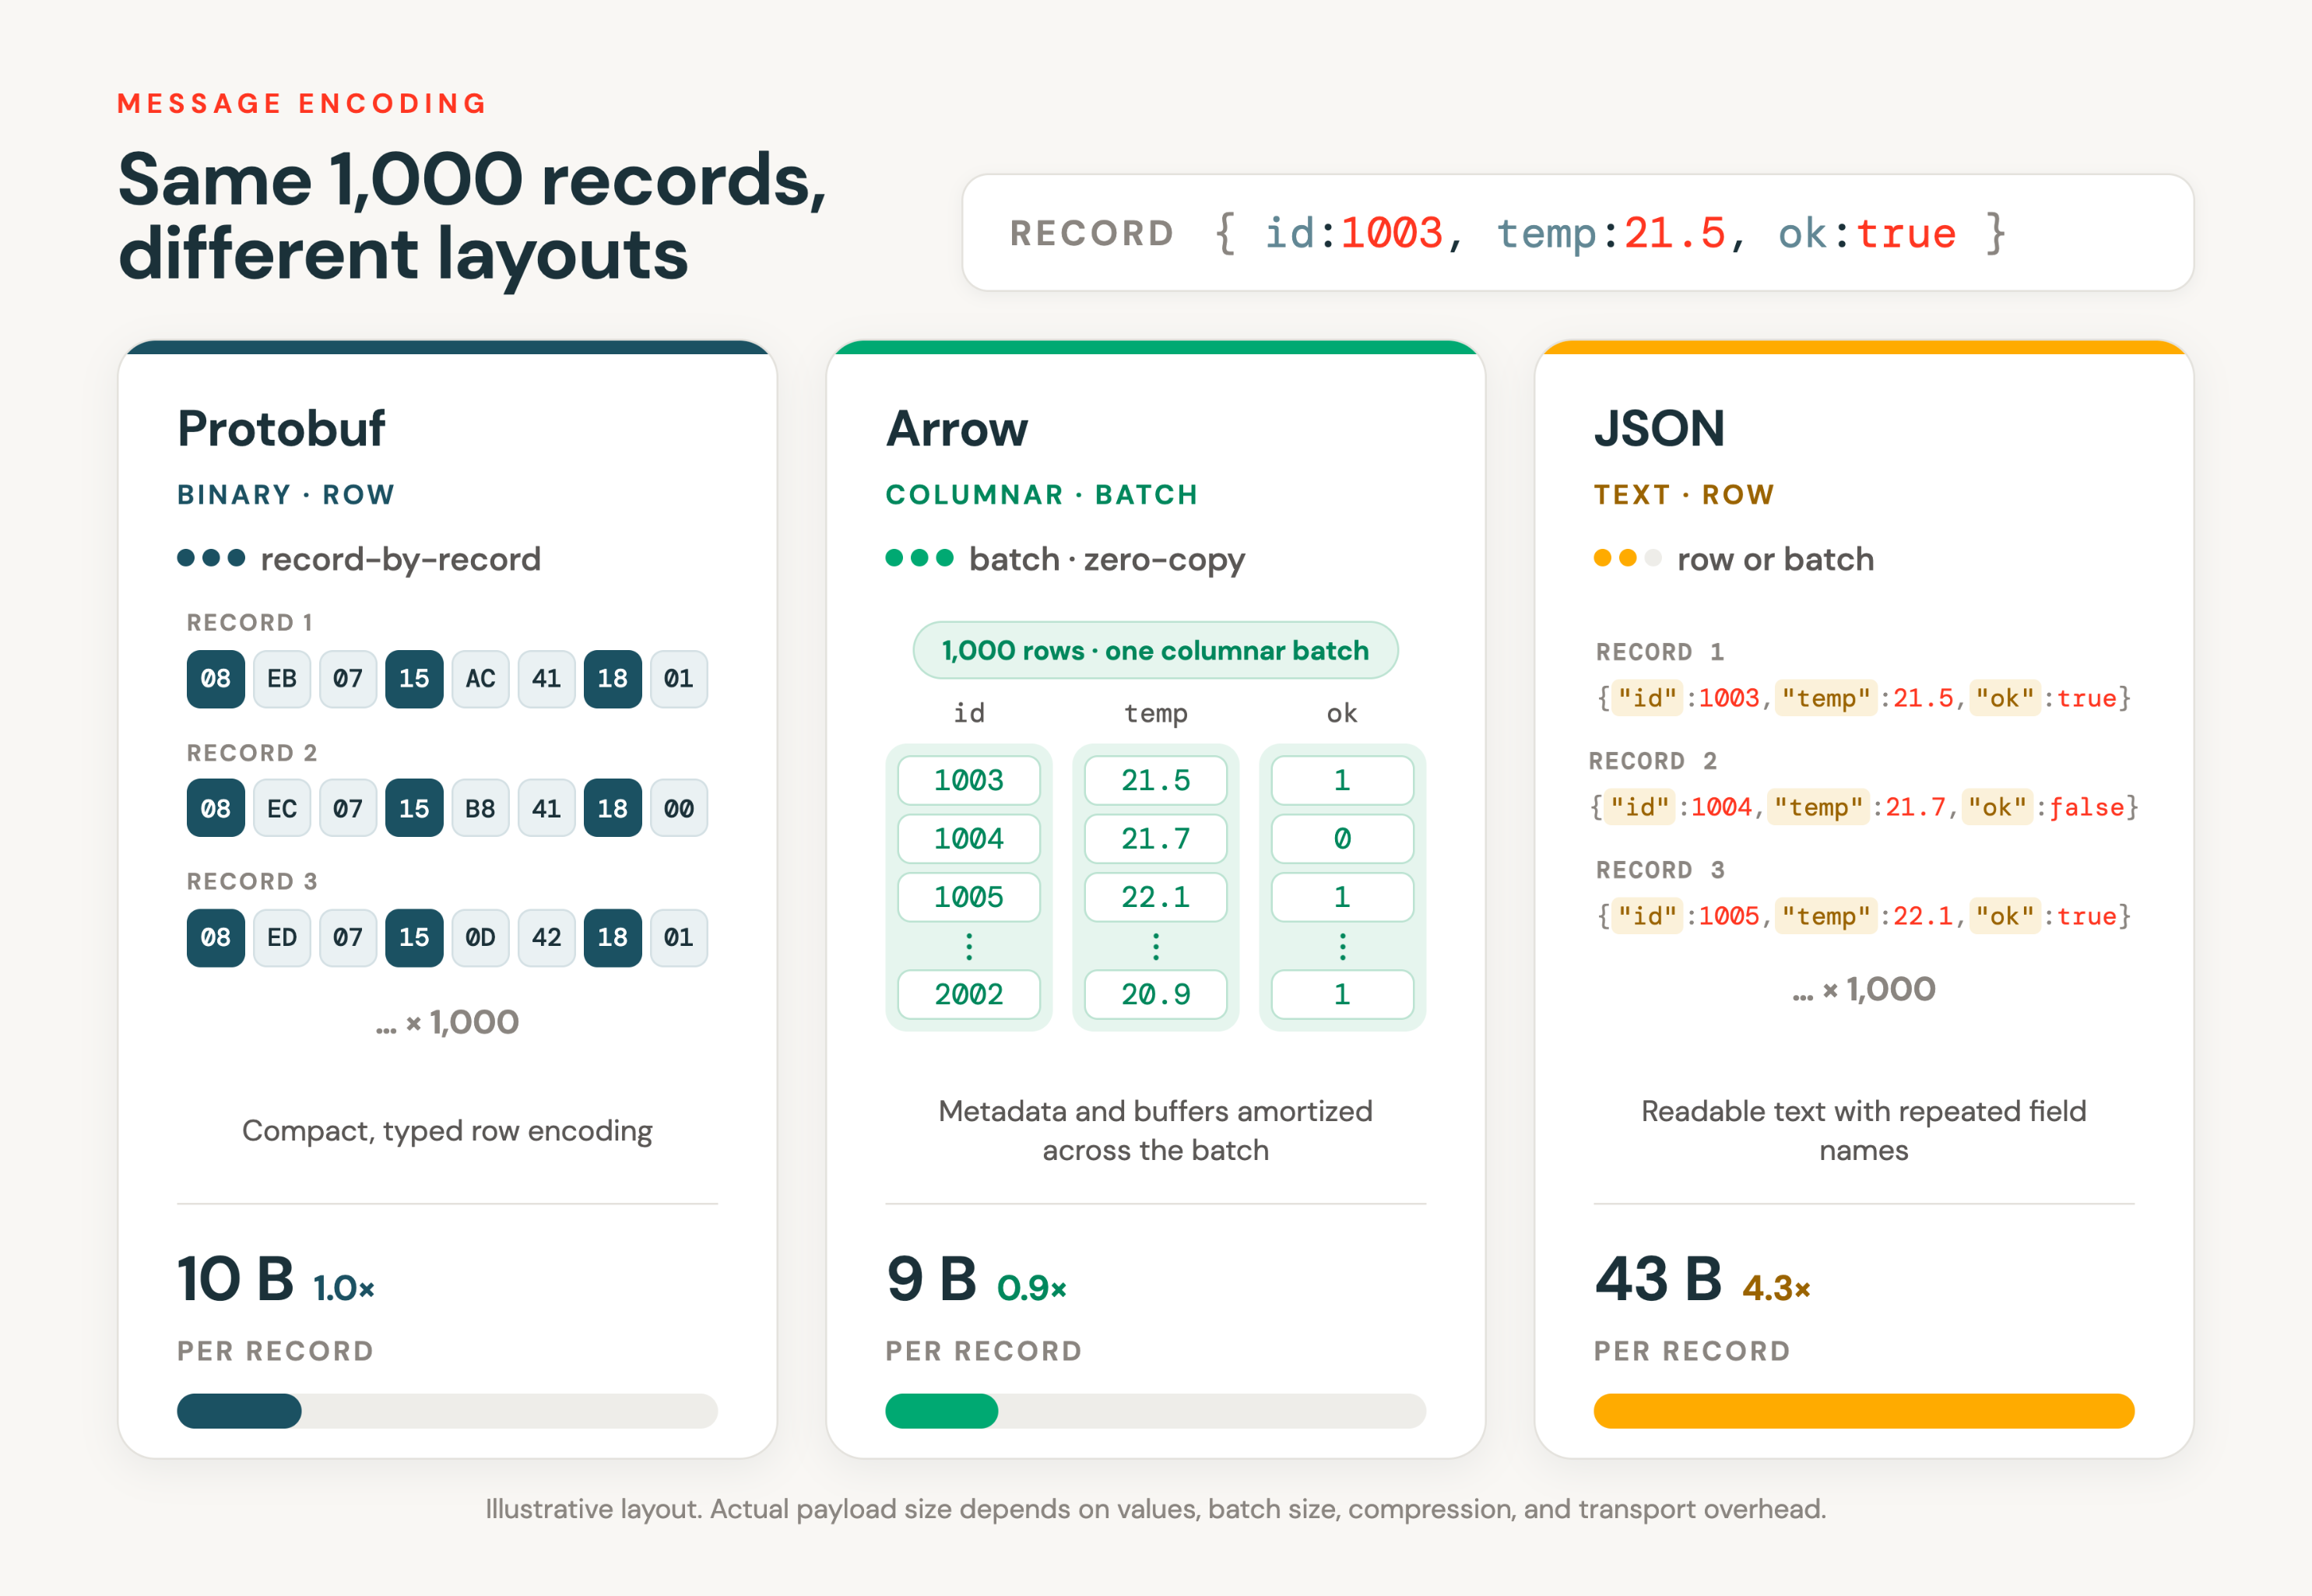
O diagrama mostra JSON, protobuf e Apache Arrow. Isso não inclui Avro, que utiliza uma codificação compacta orientada a linhas semelhante ao protobuf.
Qual formato você deve usar?
Formato | Melhor para | Notas |
|---|---|---|
JSON | Introdução e produtores simples. | A opção mais simples, sem definição de esquema para compilar. Conveniente, mas mais lento do que os formatos binários para cargas de trabalho de alto volume. |
Buffers de protocolo | Transmissões de produção, orientadas a linhas e de alto volume. | Codificação binária compacta e type-safe. Recomendado para a maioria das cargas de trabalho de produção. Requer um esquema compilado. |
Apache Arrow | Cargas de trabalho colunares ou orientadas a lotes. | Envia lotes de registros do Apache Arrow diretamente, evitando a serialização linha a linha. Ideal quando seus dados já são colunares ou quando você realiza a ingestão em lotes. Consulte Usar o Arrow Flight com o Zerobus Ingest. |
Avro (Beta) | Produtores orientados a linhas que já funcionam com Avro. | Codificação binária compacta orientada a linhas descrita por um esquema JSON, uma alternativa ao protobuf. |
Os snippets abaixo mostram o formato de cada estrutura no SDK do Python. Eles pressupõem que você já tenha criado o cliente do SDK e conheça sua tabela de destino. Para a configuração completa (endpoint, tabela, service principal) e exemplos em todos os idiomas, consulte Use Zerobus Ingest.
JSON
JSON é a maneira mais simples de começar: você envia registros como objetos JSON sem definição de esquema para compilar. É ideal para começar a operar, prototipar e para produtores onde a conveniência importa mais do que o throughput bruto. Para cargas de trabalho de produção de alto volume, um formato binário (protobuf ou Arrow) é mais eficiente.
Crie uma transmissão para registros JSON passando um nome de tabela para TableProperties sem descritor:
table_properties = TableProperties(TABLE_NAME)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

stream.ingest_record_offset({"device_name": "sensor-1", "temp": 22, "humidity": 55})
Para o passo a passo completo do JSON, consulte Escrever um cliente.
Buffers de protocolo
O Protobuf fornece uma codificação binária compacta e segura quanto ao tipo, sendo o formato recomendado para a maioria das cargas de trabalho de produção orientadas a linhas. Você define um esquema Protobuf que se ajusta à sua tabela Delta de destino (consulte Esquema Protobuf), compila-o e o SDK ingere registros, um por um, via gRPC.
Usar protobuf requer três passos: gerar um esquema .proto que corresponda à sua tabela, compilá-lo para um módulo de linguagem e, em seguida, ingerir registros passando o descritor para TableProperties. O exemplo a seguir usa o SDK do Python.
1. Gere um esquema .proto a partir da sua tabela. O SDK Python inclui uma ferramenta generate_proto que lê sua tabela Delta e grava um esquema correspondente:
python -m zerobus.tools.generate_proto \
    --uc-endpoint "https://<workspace-id>.cloud.databricks.com" \
    --client-id "<client-id>" \
    --client-secret "<client-secret>" \
    --table "main.default.air_quality" \
    --output "record.proto" \
    --proto-msg "AirQuality"
O esquema gerado usa a sintaxe proto2, com um campo opcional para cada coluna Delta:
syntax = "proto2";
message AirQuality {
    optional string device_name = 1;
    optional int32 temp = 2;
    optional int64 humidity = 3;
}
2. Compile o esquema para um módulo Python com o compilador protobuf:
pip install "grpcio-tools>=1.60.0,<2.0"
python -m grpc_tools.protoc --python_out=. --proto_path=. record.proto
Isso gera record_pb2.py.
3. Ingerir registros passando o descritor compilado para TableProperties (o default para protobuf). O SDK usa o descritor para serializar cada registro:
import record_pb2

descriptor_bytes = record_pb2.AirQuality.DESCRIPTOR.file.serialized_pb
table_properties = TableProperties(TABLE_NAME, descriptor_bytes)
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

record = record_pb2.AirQuality(device_name="sensor-1", temp=22, humidity=55)
stream.ingest_record_offset(record)
O exemplo acima usa o SDK do Python. As ferramentas variam de acordo com a linguagem: alguns SDKs fornecem uma utilidade generate_proto que gera um .proto a partir da sua tabela, enquanto outros (como Go e TypeScript) compilam um .proto existente. Para os passos por linguagem, consulte as notas de protobuf em cada tab de SDK de Escrever um cliente. Para fontes de ferramentas e exemplos completos, consulte o repository do Zerobus SDK.
Apache Arrow
A ingestão do Apache Arrow envia dados Arrow RecordBatch diretamente pela mesma conexão gRPC, em vez de converter cada linha para JSON ou protobuf primeiro. É a melhor escolha quando sua aplicação já produz dados Arrow ou quando você ingere linhas em lotes, especialmente para esquemas amplos, com muitos dados numéricos ou orientados a análises, onde a serialização linha a linha adiciona sobrecarga.
O Arrow também é uma boa opção para lotes muito grandes. Ao contrário dos métodos de lote JSON e protobuf, que são tudo ou nada e limitados pelo tamanho máximo por mensagem, o caminho do Arrow Flight divide um lote grande em mensagens de transporte menores que são enviadas e confirmadas individualmente. Consulte Os lotes do Arrow Flight são a exceção e Usar o Arrow Flight com o Zerobus Ingest.
Abra uma transmissão Arrow com um pyarrow.Schema e ingira dados RecordBatch:
stream = sdk.create_arrow_stream(TABLE_NAME, schema, CLIENT_ID, CLIENT_SECRET)

stream.ingest_batch(batch)
Para o passo a passo completo do Arrow Flight, incluindo definição de esquema, processamento em lote e compressão, consulte Usar o Arrow Flight com o Zerobus Ingest.
Avro
Beta
Esse recurso está em Beta. Para usá-lo, um administrador de workspace deve habilitar Suporte a Avro no Zerobus Ingest na página Pré-visualizações . Consulte Gerenciar prévias do Databricks.
O Apache Avro é um formato orientado a linhas, compacto, binário e baseado em esquema. Assim como o protobuf, cada registro é codificado em relação a um esquema em vez de carregar seus nomes de campo em linha, o que mantém os registros pequenos. A diferença é que o protobuf usa um descritor .proto compilado, enquanto o Avro descreve seus registros com um esquema escrito em JSON. A execução da ingestão de Avro ocorre via gRPC através dos SDKs Zerobus. Para saber quais SDKs suportam Avro, consulte o repository de SDKs Zerobus.
Avro é uma boa opção quando seu produtor já trabalha com Avro, por exemplo, quando lê dados de Avro de um sistema upstream ou já mantém um esquema de escritor de Avro.
Tratamento de esquema
O Zerobus Ingest não usa um registro de esquema, e os registros na transmissão não carregam um ID de esquema ou impressão digital. Em vez disso, você fornece o esquema de gravação do Avro como JSON ao criar a transmissão, e cada registro nessa transmissão é decodificado em relação a esse esquema. O esquema é validado em relação à tabela Delta de destino com antecedência, de modo que um esquema incompatível é rejeitado antes que qualquer dado seja fluxo.
O esquema do gravador é fixo durante o ciclo de vida da transmissão. Para ingerir com um esquema diferente, crie uma nova transmissão.
Os campos Avro são emparelhados com as colunas Delta por nome em todos os níveis, portanto, a ordem dos campos no esquema de escrita não importa. Para saber como os tipos Avro são mapeados para colunas Delta e quais colunas não podem ser direcionadas, consulte Tipos Avro. Para saber como os registros são validados em relação à tabela, consulte Gerenciamento de esquema.
Um esquema de escritor Avro deve declarar cada tipo em linha. Não há suporte para referências de tipo nomeado, que reutilizam um tipo record, enum ou fixed nomeado em outro lugar no esquema referindo-se ao seu nome.
Como fornecer dados
Esteja você usando um SDK ou não, você pode ingerir um valor de cada vez ou em lotes. O que difere é quem codifica os dados para Avro:
-
Com um SDK, você pode:
- Permita que o SDK codifique seus dados : forneça ao SDK seus registros Avro e ele os codifica em relação ao esquema do gravador.
- Enviar bytes Avro pré-codificados : se você já possui dados codificados em Avro, por exemplo, de um sistema upstream, o SDK os envia como estão.
-
Sem um SDK, ao chamar a API gRPC diretamente, você enviará apenas bytes Avro pré-codificados. Crie a transmissão com o esquema do gravador, em seguida, envie a codificação binária Avro bruta de seus dados, sem cabeçalho de arquivo de contêiner, prefixo de ID de registro de esquema ou impressão digital.
Escrever um cliente
Os exemplos abaixo usam os SDKs de Python e Rust. Eles criam uma transmissão, enviam registros que o SDK codifica em relação ao esquema do gravador e liberam. Eles pressupõem que você já configurou o Zerobus Ingest (endpoint, tabela de destino e service principal). Consulte Usar o Zerobus Ingest. Para saber quais SDKs oferecem suporte ao Avro, consulte o repository Zerobus SDK.
- Python SDK
- Rust SDK
Instale o SDK com o extra avro, que extrai o codificador fastavro:
pip install "databricks-zerobus-ingest-sdk[avro]"
Passe o esquema do gravador como uma strings JSON para TableProperties com a palavra-chave avro_schema, depois ingira os registros como dicionários:
import json

from zerobus.sdk.sync import ZerobusSdk
from zerobus.sdk.shared import TableProperties

SERVER_ENDPOINT = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com"
DATABRICKS_WORKSPACE_URL = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com"
TABLE_NAME = "main.default.air_quality"
CLIENT_ID = "your-client-id"
CLIENT_SECRET = "your-client-secret"

SCHEMA = {
    "type": "record",
    "name": "AirQuality",
    "fields": [
        {"name": "device_name", "type": "string"},
        {"name": "temp", "type": "int"},
        {"name": "humidity", "type": "long"},
    ],
}

sdk = ZerobusSdk(SERVER_ENDPOINT, DATABRICKS_WORKSPACE_URL)
table_properties = TableProperties(TABLE_NAME, avro_schema=json.dumps(SCHEMA))
stream = sdk.create_stream(CLIENT_ID, CLIENT_SECRET, table_properties)

try:
    for i in range(1000):
        stream.ingest_record_offset(
            {"device_name": f"sensor-{i}", "temp": 20 + (i % 5), "humidity": 55 + (i % 10)}
        )
    stream.flush()
finally:
    stream.close()
Para enviar dados que você já codificou, passe o bytes bruto para ingest_record_offset diretamente, sem nenhum tipo de wrapper. O SDK os envia sem alterações. Os bytes devem ser um datum Avro sem esquema codificado em relação ao mesmo esquema de escrita. Eles são mostrados aqui como um literal, mas na prática eles vêm de um sistema upstream:
# A schemaless Avro datum for {"device_name": "sensor-0", "temp": 21, "humidity": 55},
# encoded against the writer schema above: a length-prefixed "sensor-0", then temp
# and humidity as Avro varints.
payload = b"\x10sensor-0\x2a\x6e"
stream.ingest_record_offset(payload)
Adicione o crate com o recurso avro, que requer Rust 1.88 ou posterior:
cargo add databricks-zerobus-ingest-sdk --features avro
cargo add tokio --features macros,rt-multi-thread
Selecione o formato Avro com .avro(schema_json) no gerador de transmissão e ingira os valores AvroRecord que o SDK codifica no esquema do gravador:
use databricks_zerobus_ingest_sdk::{AvroRecord, AvroValue, ZerobusSdk};

const SERVER_ENDPOINT: &str = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com";
const DATABRICKS_WORKSPACE_URL: &str = "https://dbc-a1b2c3d4-e5f6.cloud.databricks.com";
const TABLE_NAME: &str = "main.default.air_quality";
const CLIENT_ID: &str = "your-client-id";
const CLIENT_SECRET: &str = "your-client-secret";

const AVRO_SCHEMA: &str = r#"{
  "type": "record",
  "name": "AirQuality",
  "fields": [
    {"name": "device_name", "type": "string"},
    {"name": "temp", "type": "int"},
    {"name": "humidity", "type": "long"}
  ]
}"#;

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let sdk = ZerobusSdk::builder()
        .endpoint(SERVER_ENDPOINT)
        .unity_catalog_url(DATABRICKS_WORKSPACE_URL)
        .build()?;

    let mut stream = sdk
        .stream_builder()
        .table(TABLE_NAME)
        .oauth(CLIENT_ID, CLIENT_SECRET)
        .avro(AVRO_SCHEMA)
        .build()
        .await?;

    for i in 0..1000 {
        let record = AvroValue::Record(vec![
            ("device_name".to_string(), AvroValue::String(format!("sensor-{i}"))),
            ("temp".to_string(), AvroValue::Int(20 + i % 5)),
            ("humidity".to_string(), AvroValue::Long((55 + i % 10) as i64)),
        ]);
        stream.ingest_record_offset(AvroRecord(record)).await?;
    }
    stream.flush().await?;
    stream.close().await?;

    Ok(())
}
Para enviar um dado que você já codificou, passe AvroBytes(bytes) para ingest_record_offset em vez de AvroRecord.
Relacionado
- Protocolos de API: Os protocolos de API pelos quais esses formatos trafegam.
- Gerenciamento de esquema: Como os registros são validados em relação à sua tabela.
- Tipos de dados compatíveis: tipos de dados Delta, Protobuf e Avro compatíveis.