Configure variáveis de ambiente para jobs serverless
Variáveis de ambiente provide deployment-specific configuration to application code in serverless Lakeflow Jobs tarefas. Define named variável de ambiente entries on a Job, then select an entry for each tarefa that needs it.
Beta
Esse recurso está em Beta. Para usá-lo, um administrador do workspace deve ativar variáveis de ambiente em Lakeflow Jobs na página Pré-visualizações . Consulte Gerenciar prévias do Databricks.
Essas variáveis de ambiente se aplicam somente a jobs serverless. O compute serverless não é compatível com init scripts. Se a sua carga de trabalho for executada em compute clássico, consulte Definir e usar variáveis de ambiente com init scripts.
Como as variáveis de ambiente funcionam
As entradas de variável de ambiente são definidas no nível do job. Cada entrada tem uma key exclusiva e contém variáveis embutidas, caminhos para arquivos .env ou ambos. Uma entrada funciona com todos os tipos de tarefas serverless. Uma key de entrada pode conter apenas letras, números, hifens e underscores. Each inline variable name must start with a letter or underscore and can contain only letters, numbers, and underscores.
Cada tarefa seleciona uma única entrada de variável de ambiente com environment_variables_key e recebe apenas as variáveis dessa entrada. As entradas nunca são combinadas, e uma entrada não pode herdar de outra. Uma tarefa que omite environment_variables_key não recebe nenhuma variável de ambiente.
As variáveis de ambiente estão disponíveis apenas para o código do aplicativo que é executado no processo da tarefa. Elas não estão disponíveis para a lógica de execução do Spark.
Requisitos
- Um administrador do workspace ativou Variáveis de ambiente no Lakeflow Jobs na página Pré-visualizações . Consulte Gerenciar prévias do Databricks.
- Tarefas com execução na versão 5 e acima do ambiente Serverless.
- Para arquivos
.env, a identidade Run as do job deve ter acesso de leitura a cada arquivo. - Para referências a segredos, a identidade Run as do Job deve ter pelo menos a permissão
READem cada Secret Scope referenciado. Consulte ACLs de segredos.
Limitações
Funções definidas pelo usuário (UDFs) não podem ler variáveis de ambiente, pois as UDFs são executadas na lógica de execução do Spark em vez de no processo da tarefa.
Só há suporte para segredos do Databricks no nível do workspace. O suporte a segredos do Unity Catalog estará disponível em breve.
Aplicam-se os seguintes limites:
Configuração | Limite |
|---|---|
Entradas de variáveis de ambiente por job | 10 |
Chave de entrada | 1–100 caracteres; deve corresponder |
Variáveis embutidas por entrada | 20 |
Nome da variável em linha | 1–256 caracteres; deve corresponder |
Valor da variável embutida | 512 caracteres |
| 5 |
Caminho do arquivo | 1.024 caracteres |
Tamanho do Arquivo | 32 KiB (32.768 bytes) |
Tamanho da linha em um arquivo | 1 KiB (1.024 bytes), medidos em bytes UTF-8 |
Use arquivos .env
Você pode carregar variáveis de ambiente de arquivos de workspace (/Workspace/...) ou de arquivos em volumes do Unity Catalog (/Volumes/...). Adicione os caminhos de arquivo à lista Files de uma entrada na interface do usuário ou à matriz spec.files na Jobs API. Os arquivos são lidos quando uma tarefa inicia, em vez de quando você cria ou atualiza o job.
Para jobs serverless, o Databricks usa seu próprio formato de arquivo .env. As seguintes regras se aplicam:
- Define one variable per line as
KEY=VALUE, with no leading whitespace or spaces before the=. - Os nomes de variáveis devem começar com uma letra ASCII ou underscore. Os caracteres restantes podem ser letras ASCII, dígitos ou underscores.
- Tudo após o primeiro
=é o valor, incluindo espaços e caracteres=adicionais. Valores vazios são permitidos. Os valores podem conter texto Unicode. Salve o arquivo usando a codificação UTF-8. - Linhas em branco e apenas com espaços em branco são ignoradas. Para adicionar um comentário, coloque
#como o primeiro caractere da linha.
Por exemplo, um arquivo execution.env pode conter:
# Application configuration
APP_ENV=production
REGION=us-west-2
GREETING=こんにちは
OPTIONAL_VALUE=
Este formato não interpreta aspas, sequências de escape, comentários em linha ou referências de variáveis, como ${OTHER_VARIABLE}. Esses caracteres continuam a fazer parte do valor. Por exemplo, APP_ENV="production" inclui as aspas no valor. Um prefixo export é inválido.
As referências de segredo utilizam uma sintaxe separada e são resolvidas após as variáveis de arquivo e inline serem combinadas. Veja Usar segredos.
Se uma variável tiver várias definições:
- Dentro de um arquivo, a última definição tem precedência.
- Entre os arquivos, um arquivo listado posteriormente substitui os valores dos arquivos listados anteriormente.
- As variáveis embutidas substituem os valores dos arquivos.
Por exemplo, se um arquivo definir LOG_LEVEL=DEBUG e a entrada também definir a variável embutida LOG_LEVEL=INFO, a tarefa receberá LOG_LEVEL=INFO.
Se um arquivo contiver uma linha inválida ou exceder um limite de tamanho de arquivo ou linha, a tarefa falhará.
Usar segredos
As variáveis de ambiente para jobs serverless oferecem compatibilidade com os segredos do Databricks no nível do workspace, que são organizados em secret scopes. Use uma referência de segredo para passar credenciais ou tokens para o código da aplicação sem armazenar o valor secreto na configuração do job ou em um arquivo .env. Para criar um Secret Scope e adicionar um segredo, consulte Gerenciamento de segredos.
Defina o valor de uma variável de ambiente como uma referência de segredo no seguinte formato:
{{secrets/<scope-name>/<secret-name>}}
Substitua <scope-name> pelo nome do Secret Scope e <secret-name> pela key do segredo nesse escopo. A referência deve ser o valor inteiro. As referências incorporadas em uma strings maior, como Bearer {{secrets/production/service-token}}, permanecem como texto literal.
Na interface do usuário, insira a referência como o valor em Variáveis . Na API de jobs, use-o como um valor em spec.variables:
{
  "SERVICE_TOKEN": "{{secrets/production/service-token}}"
}
Para fazer referência ao mesmo segredo em um arquivo .env, adicione a seguinte linha sem aspas ou espaços ao redor da referência:
SERVICE_TOKEN={{secrets/production/service-token}}
O Databricks resolve referências de segredos quando a tarefa começar, usando a identidade execução como do Job. A tarefa recebe o valor secreto resolvido em seu ambiente de processo. O código do aplicativo o lê com os.environ["SERVICE_TOKEN"] em Python ou sys.env("SERVICE_TOKEN") em Scala.
O Databricks tenta redigir valores secretos na saída do notebook, mas a redação é feita da melhor forma possível. Os segredos que seu aplicativo imprime ou grava nos logs podem aparecer em texto simples nos logs do compute, mesmo quando a saída do notebook exibe [REDACTED]. Evite imprimir valores secretos ou gravá-los em logs. Consulte Redação secreta.
As mesmas regras de precedência se aplicam a referências secretas. Somente os valores resultantes são resolvidos. As configurações do Job retêm as referências secretas, não os valores secretos resolvidos.
Se um segredo referenciado não existir ou se a identidade execução as não tiver permissão para lê-lo, a tarefa falhará antes que o código do aplicativo seja executado. Verifique o nome do escopo, a chave secreta e as permissões do Secret Scope.
Configurar variáveis de ambiente na UI
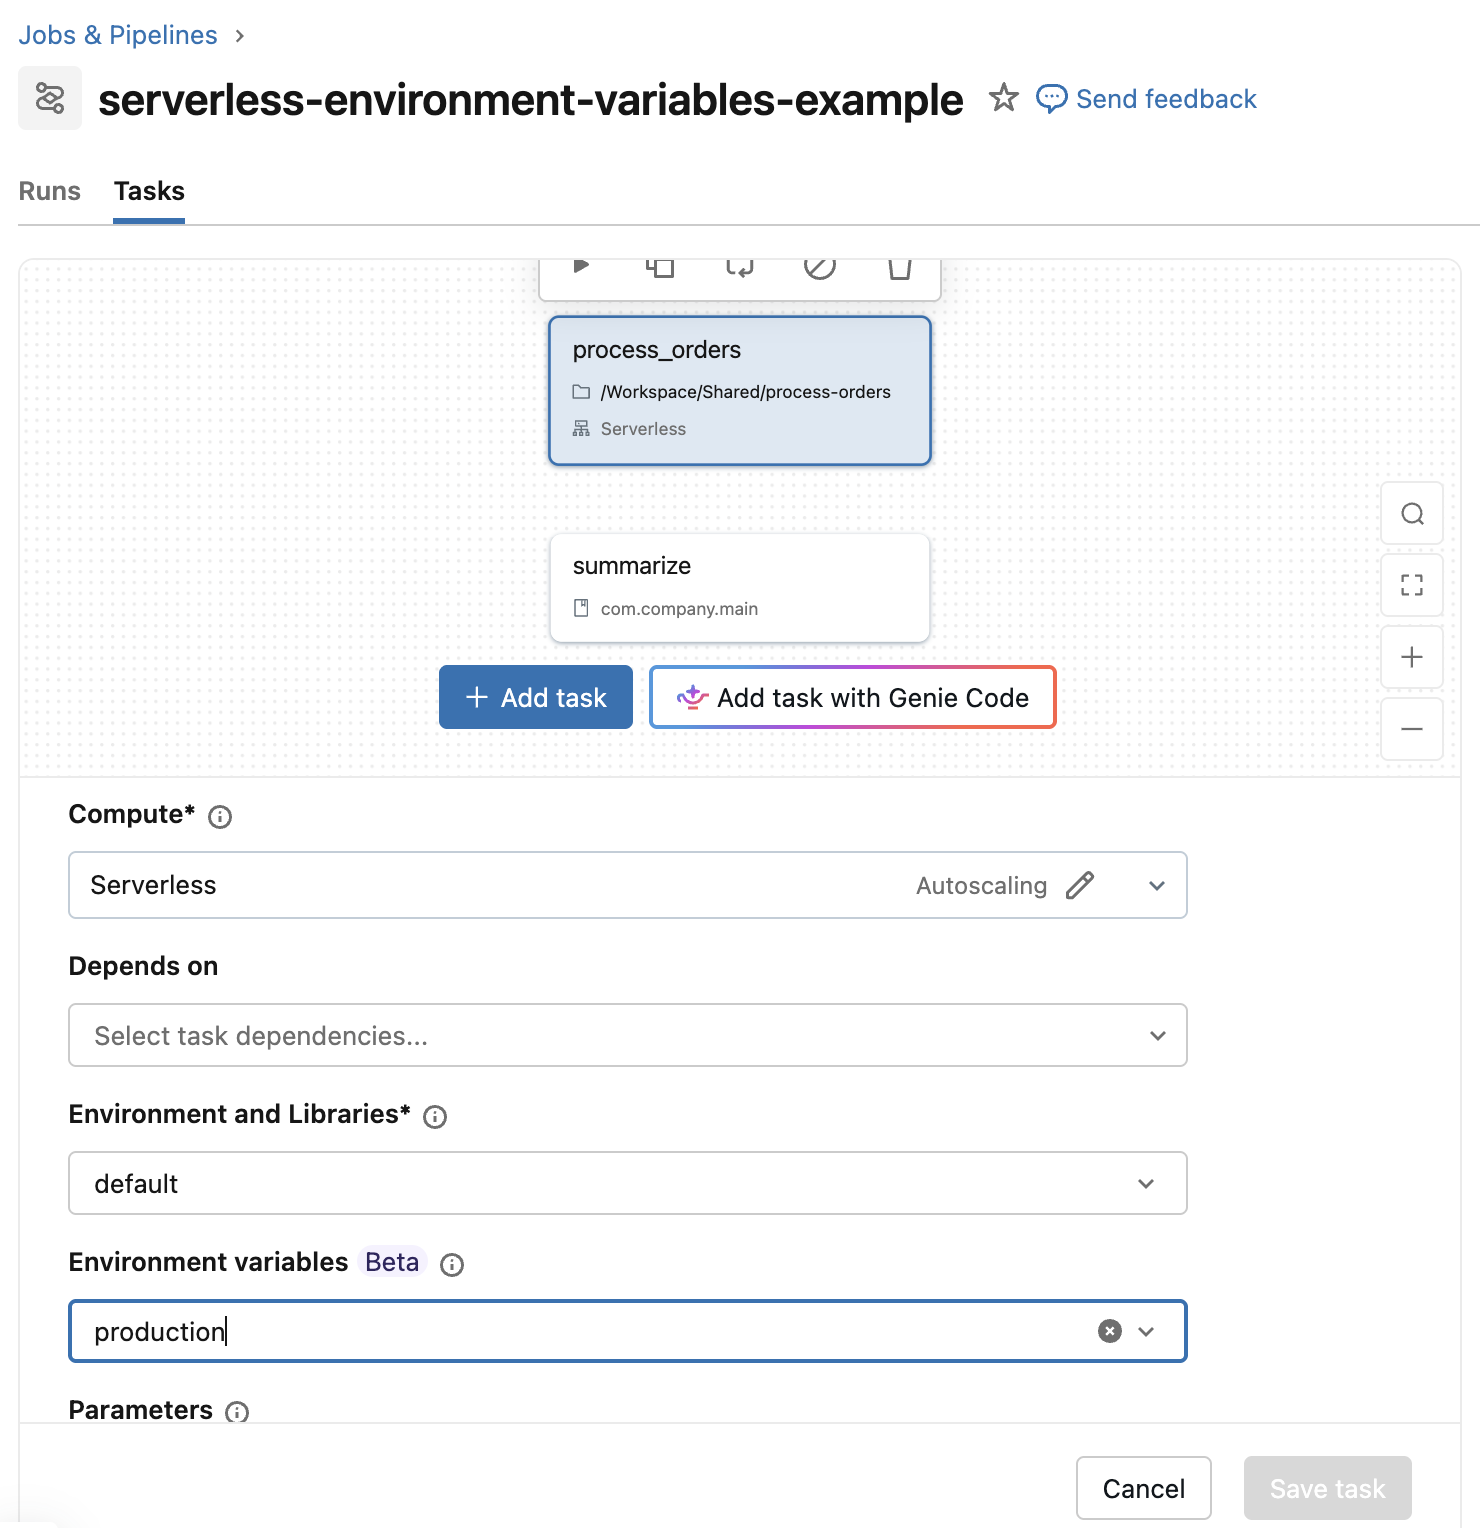
Na tab Tarefas do job, selecione uma tarefa. Use Variáveis de ambiente para selecionar ou criar uma entrada de variável de ambiente, como production.
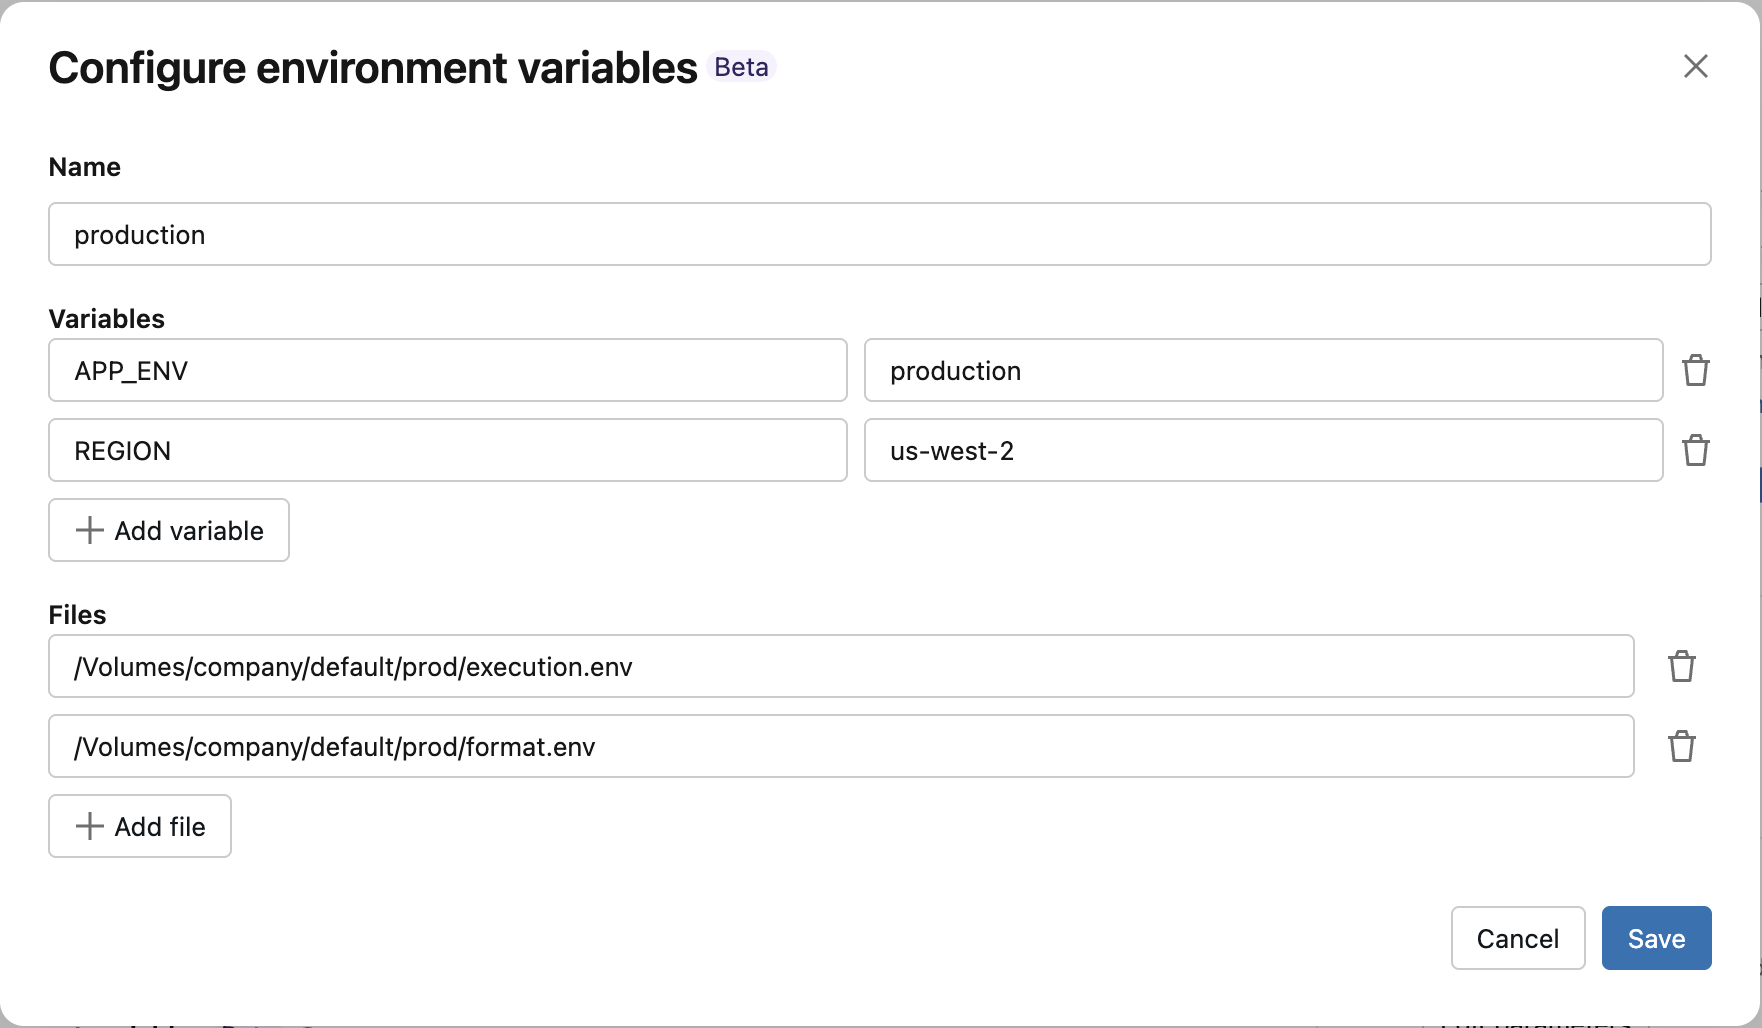
Em Configure variáveis de ambiente , insira um nome. Opcionalmente, adicione pares key-value em Variables , caminhos para arquivos .env em Files ou ambos. Você também pode deixar ambas as seções vazias. Clique em Salvar .
Configure variáveis de ambiente com a API de Tarefas.
Use o campo environment_variables em uma solicitação POST /api/2.2/jobs/create para definir entradas de variável de ambiente. Defina environment_variables_key em cada tarefa que usa uma entrada.
Antes da execução do exemplo a seguir, crie o segredo service-token no escopo production e conceda a ele acesso à identidade de execução as do Job. Consulte Usar segredos. O exemplo define entradas de variáveis de ambiente separadas para uma tarefa de notebook e uma tarefa de JAR. Cada entrada usa spec.variables para valores em linha e spec.files para caminhos de arquivos. Cada tarefa seleciona sua entrada com environment_variables_key:
{
  "name": "serverless-environment-variables-example",
  "tasks": [
    {
      "task_key": "process_orders",
      "notebook_task": {
        "notebook_path": "/Workspace/Shared/process-orders"
      },
      "environment_key": "default",
      "environment_variables_key": "production"
    },
    {
      "task_key": "summarize",
      "spark_jar_task": {
        "main_class_name": "com.company.main"
      },
      "environment_key": "summary_env",
      "environment_variables_key": "summary_vars"
    }
  ],
  "environments": [
    {
      "environment_key": "default",
      "spec": {
        "environment_version": "5",
        "dependencies": []
      }
    },
    {
      "environment_key": "summary_env",
      "spec": {
        "environment_version": "5",
        "java_dependencies": ["/Volumes/company/default/prod/summarize.jar"]
      }
    }
  ],
  "environment_variables": [
    {
      "environment_variables_key": "production",
      "spec": {
        "variables": {
          "APP_ENV": "production",
          "REGION": "us-west-2",
          "SERVICE_TOKEN": "{{secrets/production/service-token}}"
        },
        "files": ["/Volumes/company/default/prod/execution.env", "/Volumes/company/default/prod/format.env"]
      }
    },
    {
      "environment_variables_key": "summary_vars",
      "spec": {
        "variables": {
          "APP_ENV": "production",
          "LOG_LEVEL": "INFO",
          "LOG_FILE": "service.log"
        },
        "files": ["/Volumes/company/default/prod/format.env"]
      }
    }
  ]
}
Você também pode configurar entradas de variável de ambiente com as operações Atualizar um job, Substituir todas as configurações de um job e Enviar uma execução única.
Ler variáveis de ambiente no código do aplicativo
O código da aplicação lê as variáveis configuradas do ambiente do processo.
- Python
- Scala
import os

app_environment = os.environ["APP_ENV"]
region = os.environ["REGION"]
val appEnvironment = sys.env("APP_ENV")
val region = sys.env("REGION")