Visão geral e glossário da Feature Store do Databricks
O Databricks Feature Store centraliza os recursos usados no machine learning para que os mesmos cálculos de recursos sejam executados durante o treinamento e a inferência do modelo. Você cria recursos como views de recursos, que o Databricks compute e gerencia, ou como tabelas de recursos que você mesmo popula. As seções abaixo abordam o fluxo de trabalho típico e definem os termos key.
O que o Databricks Feature Store oferece?
A Feature Store oferece duas formas de criar recursos. Ambos produzem recursos governados pelo Unity Catalog que você pode usar para inferência em lotes ou então publicar na Online Feature Store para servir com baixa latência:
- As views de recursos definem recursos de forma declarativa, e o Databricks compute e gerencia os pipelines de recursos para você. O Databricks recomenda o uso de views de recursos para novos casos de uso.
- As tabelas de recursos são tabelas Delta que você preenche sozinho ao gravar valores de recursos.
Para saber como escolher entre eles, consulte Escolha uma estratégia de autoria.
Como funciona o Databricks Feature Store?
O típico fluxo de trabalho de aprendizado de máquina usando recurso engenharia em Databricks segue esse caminho:
-
Prototipe views de recursos em um Notebook, usando o SDK de Engenharia de Recursos para gerar data histórica e conjuntos de treinamento. Itere nas definições de seu recurso, seus dados e seu modelo em paralelo até ficar satisfeito.
-
Produzir:
- Registre seus recursos no Unity Catalog, tornando-os ativos governáveis e reutilizáveis.
- Ensine e faça log do seu modelo no MLflow, capturando a linhagem dos recursos usados no treinamento.
- Materialize seus recursos em armazenamentos online ou offline.
-
Inferência:
- Para lotes, use
score_batch. - Para online, configure um endpoint de serviço online para modelos ou recursos.
- Para lotes, use

GlossárioFeature Store
loja de recursos
Um repository de recursos é um repository centralizado que permite aos cientistas de dados encontrar e compartilhar recursos. O uso de um Feature Store também ajuda a garantir que o código usado para compute os valores dos recursos seja o mesmo durante o treinamento do modelo e quando o modelo é usado para inferência. Você pode criar recursos como views de recursos, que o Databricks compute e gerencia para você, ou como tabelas de recursos. Em Workspace habilitados para o Unity Catalog, qualquer tabela Delta no Unity Catalog que inclui uma restrição de key primária pode ser usada como uma tabela de recursos.
O machine learning usa dados existentes para construir um modelo para prever resultados futuros. Em quase todos os casos, os dados brutos exigem pré-processamento e transformação antes de serem usados para construir um modelo. Esse processo é chamado de engenharia de recursos, e as saídas desse processo são chamadas de recursos, os blocos de construção do modelo. Com Recursos Views, você faz a engenharia de recursos com definições simples em Python, e o Databricks gerencia os pipelines para você.
O desenvolvimento de recursos é complexo e demorado. Uma complicação adicional é que, no aprendizado de máquina, os cálculos de recurso precisam ser feitos para o treinamento do modelo e, em seguida, novamente quando o modelo é usado para fazer previsões. Essas implementações podem não ser feitas pela mesma equipe ou usando o mesmo ambiente de código, o que pode levar a atrasos e erros. Além disso, equipes diferentes em uma organização geralmente têm necessidades de recursos semelhantes, mas podem não estar cientes do trabalho que outras equipes realizaram. Um recurso store foi projetado para resolver esses problemas.
view de recursos
As Recurso views são uma abstração para definir o que é um recurso. Você define uma recurso view, e o Databricks a compute. Durante o treinamento, o SDK de Engenharia de Recursos gera dados históricos de recursos corretos e conjuntos de treinamento. Para inferência, materialize o recurso no armazenamento online ou armazenamento offline apropriado, e o Databricks orquestra o compute para garantir que os dados do recurso estejam prontos para o serviço.
As visualizações de recursos são compatíveis com recursos em lote e de transmissão, com frescor que varia de frações de segundo a um cron programado.
tabelas de recursos
Tabelas de recursos são tabelas Delta com uma key primária. Você pode sincronizar tabelas de recursos com um armazenamento online com publish_table. Os metadados da tabela de recursos rastreiam as fontes de dados das quais uma tabela foi gerada e os notebooks e jobs que criaram ou escreveram na tabela.
Com Databricks Runtime 13.3 LTS e superior, se seu workspace estiver habilitado para Unity Catalog, você pode usar qualquer tabela Delta no Unity Catalog com uma primary key como uma tabela de recursos. Consulte Tabelas de recursos no Unity Catalog.
em uma tabela de recursos são normalmente computados e atualizados usando uma função de computação comum.
O senhor pode publicar uma tabela de recursos em um armazenamento on-line para a inferência de modelos de tempo real.
FeatureLookup
Muitos modelos diferentes podem usar recursos de uma determinada tabela de recursos, e nem todos os modelos precisarão de todos os recursos. Para treinar um modelo usando recurso, o senhor cria um FeatureLookup para cada tabela de recurso. O FeatureLookup especifica qual recurso usar da tabela e também define a chave a ser usada para join a tabela de recursos para os dados do rótulo passados para create_training_set.
O diagrama ilustra como funciona um FeatureLookup. Neste exemplo, o senhor deseja treinar um modelo usando recurso de duas tabelas de recurso, customer_features e product_features. O senhor cria um FeatureLookup para cada tabela de recurso, especificando o nome da tabela, o recurso (colunas) a ser selecionado na tabela e a pesquisa key a ser usada quando o recurso de união criar um treinamento dataset.
Em seguida, você chama create_training_set, também mostrado no diagrama. Essa chamada de API especifica o DataFrame que contém os dados de treinamento brutos (label_df), o FeatureLookups a ser usado e label, uma coluna que contém a verdade fundamental. Os dados de treinamento devem conter coluna(s) correspondente(s) a cada uma das chaves primárias das tabelas de recurso. Os dados nas tabelas de recurso são unidos à entrada DataFrame de acordo com essa chave. O resultado é mostrado no diagrama como o "treinamento dataset".
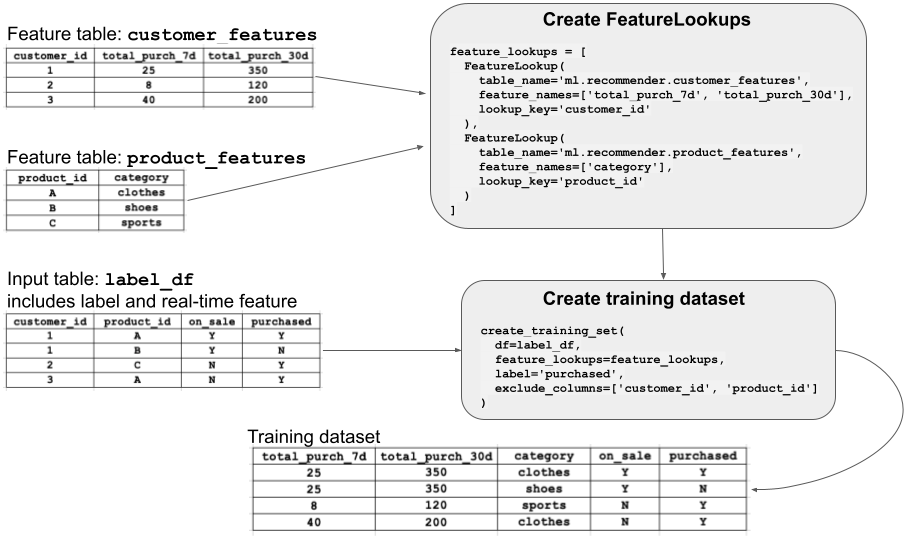
Conjunto de treinamento
Um conjunto de treinamento consiste em uma lista de recursos e um DataFrame que contém dados brutos de treinamento, rótulo e chave primária para procurar o recurso. O senhor cria o conjunto de treinamento especificando o recurso a ser extraído do recurso Store e fornece o conjunto de treinamento como entrada durante o treinamento do modelo.
Consulte Criar um treinamento dataset para ver um exemplo de como criar e usar um conjunto de treinamento.
Quando o senhor treina e log um modelo usando recurso engenharia em Unity Catalog, pode view a linhagem do modelo no Catalog Explorer. Tabelas e funções que foram usadas para criar o modelo são automaticamente rastreadas e exibidas. Ver recurso governança e linhagem.
FeatureSpec
Um FeatureSpec é uma entidade Unity Catalog que define um conjunto reutilizável de recursos e funções. FeatureSpecs combinam FeatureLookups de tabelas de recursos e FeatureFunctions em uma única unidade lógica que pode ser usada no treinamento de modelos.
FeatureSpecs são armazenados e gerenciados pelo site Unity Catalog, com acompanhamento de linhagem completa para suas funções e tabelas de recursos off-line constituintes. Isso permite governança, descoberta e reutilização em diferentes modelos e aplicativos.
Para usar um FeatureSpec no treinamento do modelo, faça referência ao FeatureSpec em create_training_set.
Tabelas de recurso de séries temporais (pesquisas pontuais)
Os dados usados para treinar um modelo geralmente têm dependências de tempo incorporadas. Ao criar o modelo, o senhor deve considerar apenas os valores do recurso até o momento do valor-alvo observado. Se o senhor treinar com recurso baseado em dados medidos após o registro de data e hora do valor-alvo, o desempenho do modelo poderá ser prejudicado.
As tabelas de recurso de séries temporais incluem uma coluna de registro de data e hora que garante que cada linha do treinamento dataset represente os valores de recurso mais recentes conhecidos a partir do registro de data e hora da linha. O senhor deve usar tabelas de recurso de série temporal sempre que os valores de recurso mudarem ao longo do tempo, por exemplo, com dados de série temporal, dados baseados em eventos ou dados agregados no tempo.
Ao criar uma tabela de recurso de série temporal, o senhor especifica as colunas relacionadas ao tempo na chave primária para serem colunas de série temporal usando o argumento timeseries_columns (para recurso engenharia em Unity Catalog) ou o argumento timestamp_keys (para espaço de trabalho Feature Store). Isso permite pesquisas pontuais quando você usa create_training_set ou score_batch. O sistema executa um carimbo de data/hora "as-of" join, usando o timestamp_lookup_key que o senhor especificar.
Se o senhor não usar o argumento timeseries_columns ou o argumento timestamp_keys e designar apenas uma coluna de série temporal como coluna primária key, o site Feature Store não aplicará a lógica point-in-time à coluna de série temporal durante a união. Em vez disso, ele corresponde apenas às linhas com uma correspondência de hora exata, em vez de corresponder a todas as linhas antes do carimbo de data/hora.
armazenamento offline
O armazenamento de recursos off-line é usado para descoberta de recursos, treinamento de modelos e inferência de lotes. Ele contém tabelas de recurso materializadas como tabelasDelta.
Loja de recursos on-line
O Databricks Online Feature Store é uma solução escalável e de alto desempenho para fornecer dados de recursos a aplicativos on-line e um modelo de tempo real do machine learning.
Desenvolvido pelo Databricks Lakebase, ele fornece acesso de baixa latência a dados de recursos em grande escala, mantendo a governança, a linhagem e a consistência com seus dados de recursos.
Você pode provisionar lojas online na plataforma Lakebase serverless. As APIs permitem gerenciar instâncias e read-replicas e escala instâncias conforme necessário. Você pode usar APIs convenientes para publicar tabelas do Unity Catalog em lojas online. Essas tabelas também são entidades do Unity Catalog que rastreiam nativamente a linhagem das tabelas de origem.
A Online Feature Store está em Beta, disponível nas regiões us-central1, us-east4 e europe-west3 (Frankfurt). Lojas online de terceiros não são suportadas.
transmissão
Além de muitas gravações, o Databricks recurso Store oferece suporte à transmissão. O senhor pode gravar valores de recurso em uma tabela de recurso a partir de uma fonte de transmissão, e o código de computação de recurso pode utilizar a transmissão estruturada para transformar dados brutos em recurso.
Embalagem modelo
Quando o senhor treina um modelo de aprendizado de máquina usando recurso engenharia em Unity Catalog ou no espaço de trabalho Recurso Store e log ele usa o método log_model() do cliente, o modelo retém referências a esses recursos. No momento da inferência, o modelo pode, opcionalmente, recuperar valores de recurso automaticamente. O chamador só precisa fornecer o endereço primário key do recurso usado no modelo (por exemplo, user_id), e o modelo recupera todos os valores de recurso necessários.
Na inferência de lotes, os valores de recurso são recuperados do armazenamento off-line e unidos a novos dados antes da pontuação. Na inferência de tempo real, os valores de recurso são recuperados do armazenamento on-line.
Para empacotar um modelo com metadados de recurso, use FeatureEngineeringClient.log_model (para recurso de engenharia em Unity Catalog) ou FeatureStoreClient.log_model (para recurso de espaço de trabalho Store).