Coletar feedback e criar datasets
Início rápido do agente de codificação
Usando um agente de programação? Cole este prompt:
Read the documentation at https://docs.databricks.com/aws/en/mlflow3/genai/human-feedback and set up human feedback collection and evaluation datasets for my agent.
Opcionalmente, instale mlflow/skills para uma integração mais profunda com o MLflow.
O julgamento humano — classificações, comentários e expectativas de verdade fundamental de desenvolvedores, usuários e especialistas em domínio — é o que mantém a avaliação alinhada com o que "bom" realmente significa para seu aplicativo. No MLflow, você registra esse julgamento diretamente em um rastreio, e um rastreio que carrega uma expectativa de verdade fundamental se torna um caso de teste pronto para uso em avaliação automatizada.
Visão geral rápida: transformar um rastreamento em um caso de teste
- Na tab Traces , clique em um rastreamento para abri-lo.
- Clique em Avaliar e, em seguida, em Adicionar expectativa para registrar a resposta correta (verdade comprovada). A expectativa é armazenada no rastreamento, juntamente com suas entradas, saídas e qualquer outro feedback.
- Clique em Add to dataset para adicionar o rastreamento — com sua expectativa — a um conjunto de dados de avaliação.
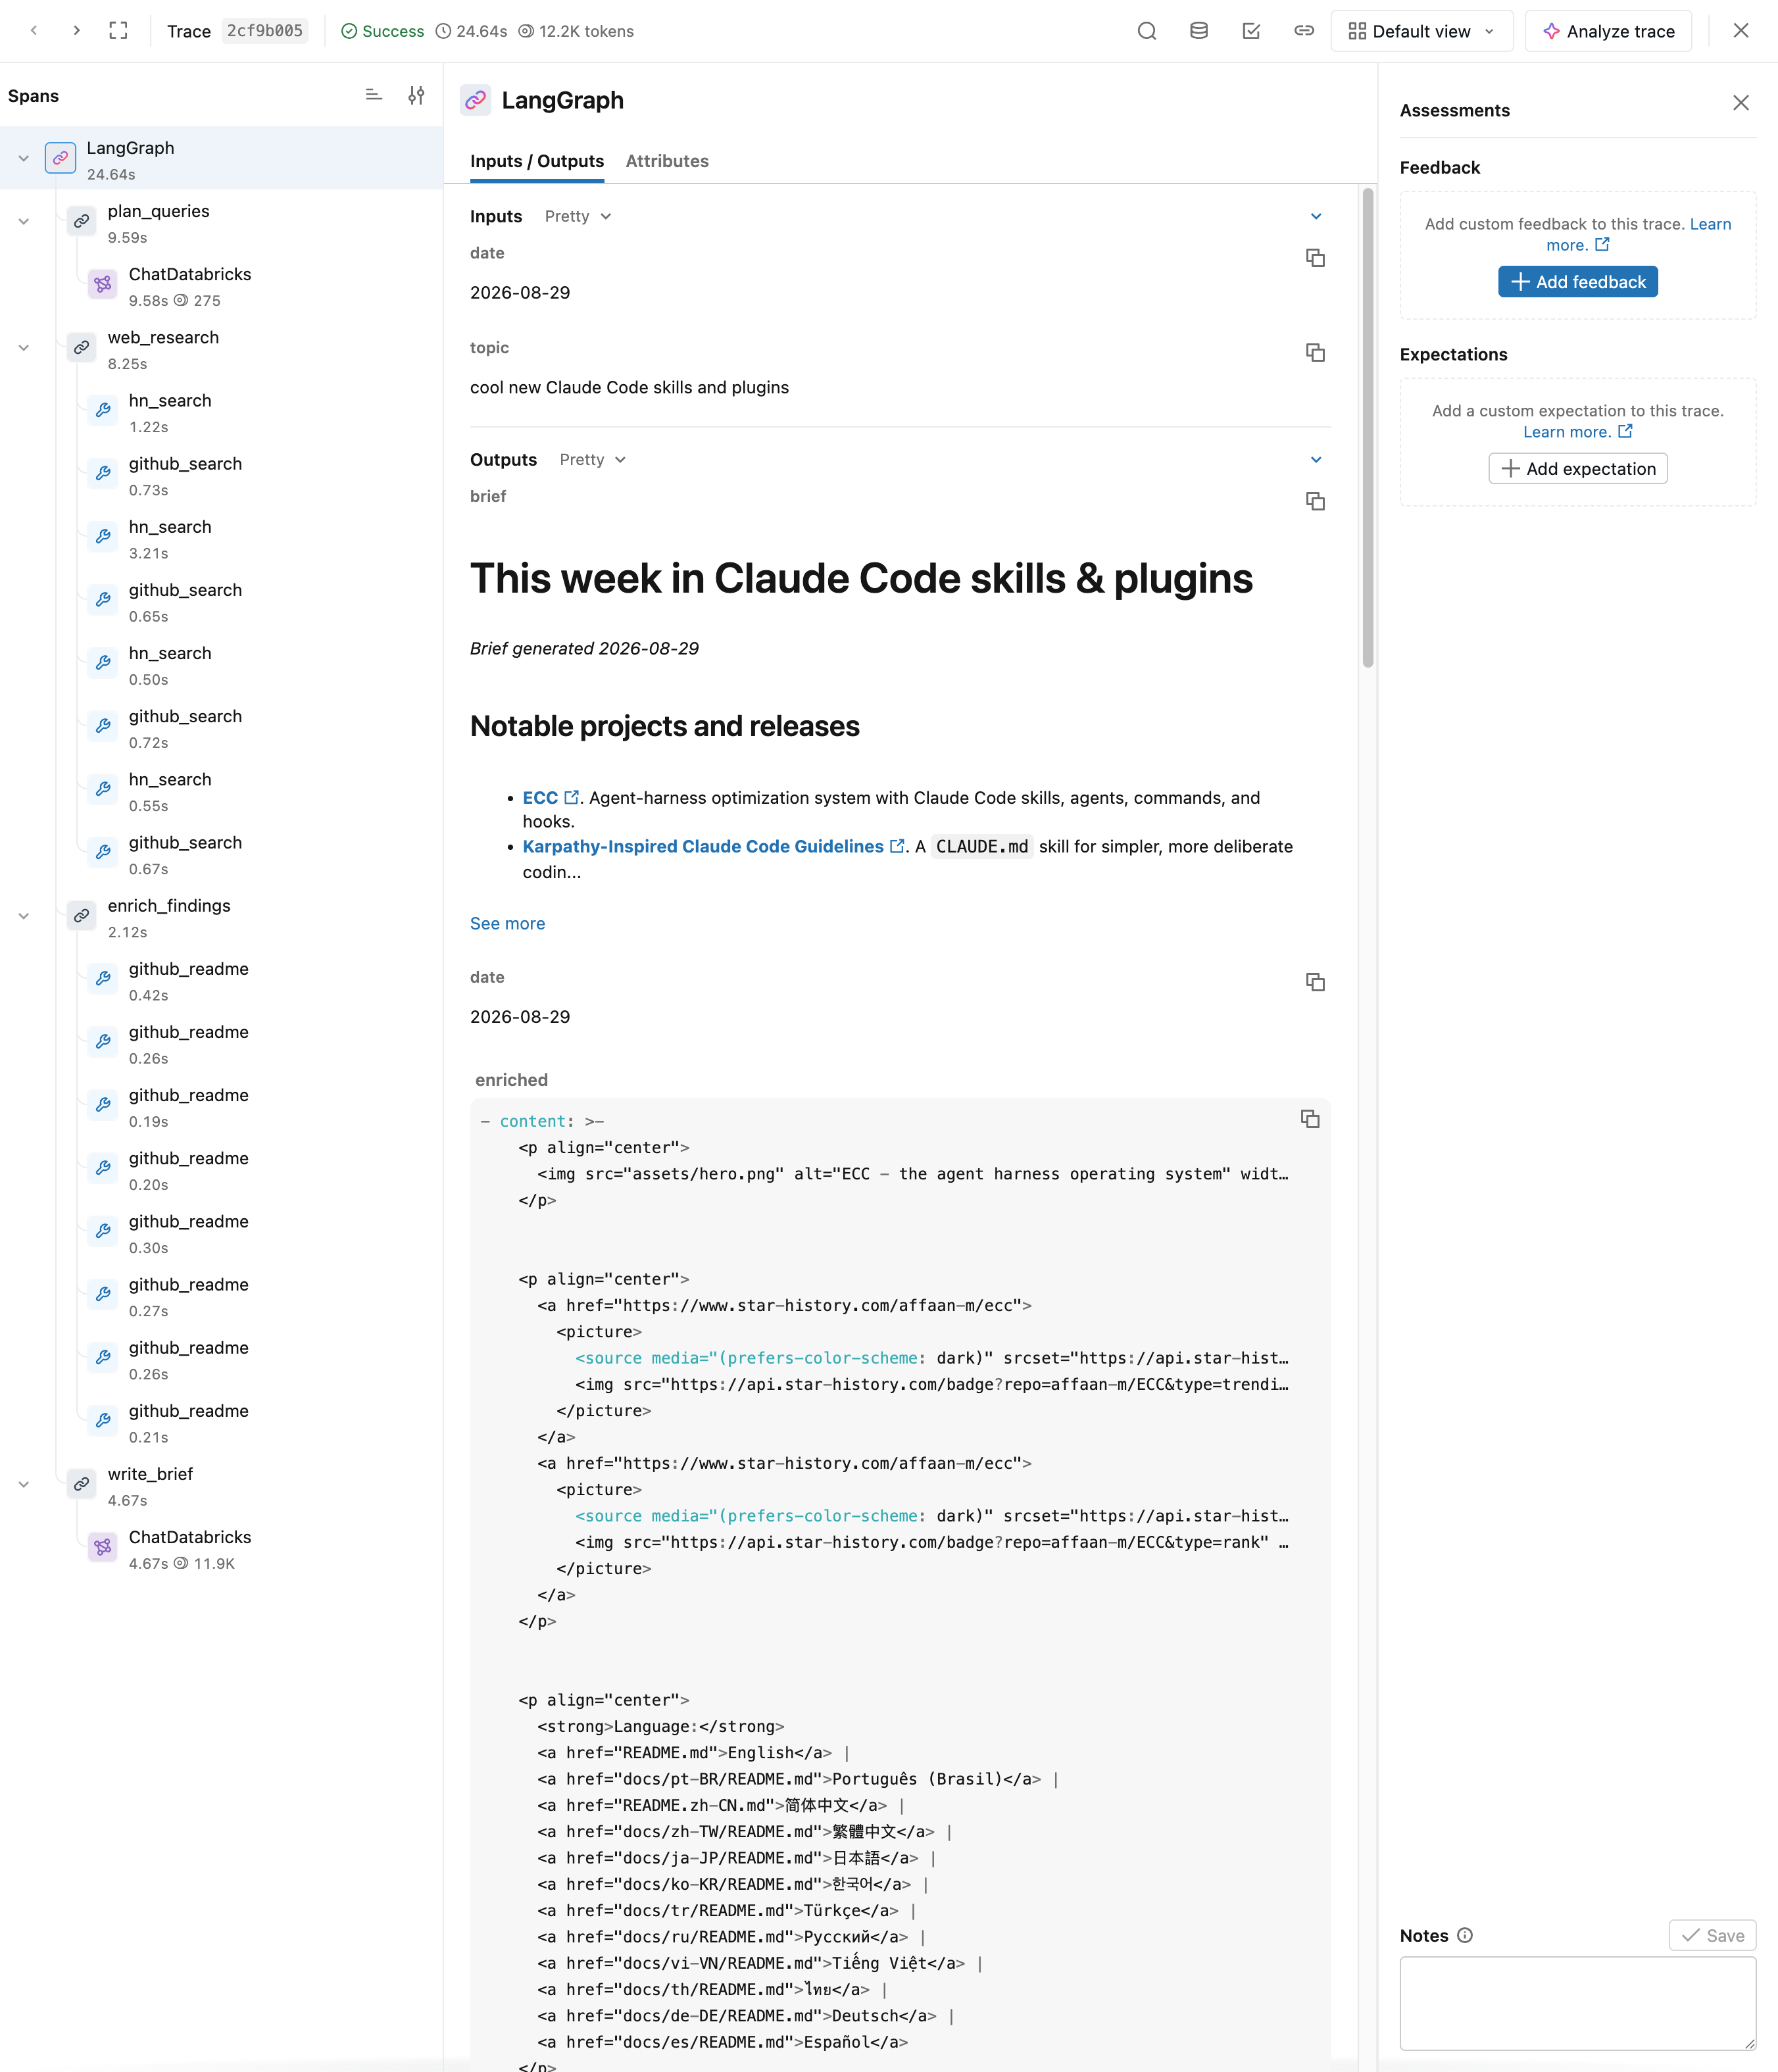
Esse rastreamento agora é um caso de teste: você capturou a resposta esperada em uma interação real e a promoveu para um dataset em relação ao qual é possível avaliar versões futuras. Como o feedback fica no rastreamento, qualquer pessoa que analise os rastreamentos — não apenas o desenvolvedor — pode fazer isso sem sair da IU de rastreamento.
Quem deixa comentários
O feedback ocorre de duas formas — o feedback avalia a saída real do aplicativo (a resposta foi boa?) e uma expectativa define a saída correta e de verdade fundamental. Cada fonte de julgamento tem seu próprio mecanismo.
Desenvolvedores
Anote os rastreamentos à medida que você os cria para acompanhar as notas de qualidade e marcar exemplos para teste de regressão. Consulte Rótulo rastreamentos como um desenvolvedor.
Especialistas de domínio
Envolva especialistas no assunto por meio do Review App para definir a aparência de uma resposta de alta qualidade e alinhar os avaliadores LLM aos seus requisitos de negócios. Há duas abordagens: Testar um agente com a interface de chat ou Permitir que especialistas e colaboradores marquem rastreamentos com tags.
Para novos fluxos de trabalho de revisão humana, a Databricks recomenda filas de revisão (Beta), que encaminham rastreamentos e registros de dataset para revisores um item de cada vez.
Usuários finais
Capture o feedback dos usuários do seu aplicativo implantado para identificar queries problemáticas e preservar interações bem-sucedidas. Consulte Enriquecer rastreamentos: tags, contexto e feedback.
Passos seguintes
- Permitir que especialistas e colaboradores rotulem rastreamentos - Traga especialistas em domínio e colaboradores para rotular rastreamentos.
- Criando datasets de avaliação do MLflow — Empacote rastreamentos rotulados e expectativas em um dataset.
- Avalie e melhore - Avalie e melhore o seu aplicativo em relação aos datasets que você cria.