Govern and redact traces in Unity Catalog
O armazenamento de rastreamentos no Unity Catalog serve também como uma camada de compliance. As traces são gravadas como tabelas Delta governadas, portanto, elas herdam o mesmo RBAC, mascaramento de coluna, filtros de linha, políticas de retenção e log de auditoria que você aplica a qualquer outro ativo de dados do Unity Catalog — sem ferramentas adicionais. Duas abordagens permitem lidar com PII especificamente:
- Redigir antes da exportação (lado do cliente) : filtre as entradas e saídas de extensões no seu agente antes que o MLflow as envie para o back-end. Dados de PII brutos nunca deixam o seu ambiente.
- Redigir rastreamentos armazenados (no lado do servidor) : aplique
ai_maskpor meio de um LakeFlow Pipelines aos spans do OTel já armazenados no Unity Catalog e, em seguida, restrincoe o acesso às tabelas brutas. Nenhuma alteração no código do agente necessária.
Use a edição (redaction) no lado do cliente quando precisar garantir que valores confidenciais nunca sejam transmitidos ou persistidos. Use a abordagem de pipeline no lado do servidor quando os rastreamentos já estiverem armazenados no Unity Catalog e você preferir não modificar seu agente.
A ocultação do MLflow afeta apenas o que é gravado no rastreamento — o próprio agente ainda recebe e retorna o conteúdo original sem ocultação. To block PII from reaching a Unity Catalog-registered AI serviço or to enforce a central policy across your organization, use service policies.
Ocultar PII antes da exportação
Span processors implement client-side redaction. Each processor receives a span, mutates it in place, and returns nothing. Registre um ou mais processadores com mlflow.tracing.configure, e o MLflow os aplica a cada span antes de exportar.
from mlflow.entities.span import Span

def filter_function(span: Span) -> None:
    # Read span.inputs / span.outputs, redact, then write back.
    span.set_inputs(...)
    span.set_outputs(...)

mlflow.tracing.configure(span_processors=[filter_function])
Comportamento-chave:
- A filtragem ocorre no lado do cliente — o backend de rastreamento nunca recebe dados sem tarjas.
- Multiple processors run in the order you register them, each receiving the span after the previous processor mutated it.
- Os processadores aplicam-se a todos os intervalos em um rastreamento, incluindo aqueles criados por integrações de frameworks, como LangChain e LangGraph.
- Use
span.span_typepara aplicar lógica diferente a diferentes tipos de extensão:LLM,TOOLouAGENT.
Pré-requisitos
-
MLflow Tracing configured for your agent. See Tracing overview.
-
Se você armazenar rastreamentos no Unity Catalog, crie primeiro o experimento com um local de rastreamento do Unity Catalog. Consulte Configuração: Criar um experimento com um local de rastreamento do Unity Catalog.
-
Instale os pacotes necessários:
Bashpip install --upgrade "mlflow-skinny[databricks]>=3.14" databricks-sdk "databricks-langchain>=0.19.0" "langgraph>=1.1.0"Para rastreamento de produção leve,
mlflow-tracingé a instalação recomendada. Estes exemplos usammlflow-skinny[databricks]porque eles também exercitam o Unity Catalog SDK e as integrações do LangChain e do LangGraph.Para o exemplo do Microsoft Presidio, instale também:
Bashpip install presidio_analyzer presidio_anonymizer
python -m spacy download en_core_web_lg
Redigir com uma regex
O exemplo a seguir corresponde a endereços de email em entradas de span com uma expressão regular e os substitui por [REDACTED].
import re
import mlflow
from mlflow.entities.span import Span

# mlflow.set_experiment(experiment_id=experiment_id)

@mlflow.trace
def predict(text: str):
    return "Answer"

EMAIL_PATTERN = r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}"

def redact_email(span: Span) -> None:
    raw_input = span.inputs.get("text")
    redacted_input = re.sub(EMAIL_PATTERN, "[REDACTED]", raw_input)
    span.set_inputs({"text": redacted_input})

mlflow.tracing.configure(span_processors=[redact_email])

predict("My e-mail address is test@example.com")
Filtrar por tipo de intervalo
Use span.span_type para aplicar diferentes lógicas de redatoria a diferentes tipos de spans — LLM, TOOL, AGENT e assim por diante. Isso permite que você tenha como alvo o span onde um valor sensível se origina, em vez de escanear cada formato de payload que uma estrutura possa produzir.
O exemplo a seguir oculta números de contas bancárias de um agente do LangGraph. O número da account vem de uma ferramenta, portanto, o processador substitui inteiramente as saídas de intervalo de TOOL e aplica uma expressão regular às entradas e saídas de todos os outros intervalos como medida de segurança.
Configure o agente:
import mlflow
from langchain_core.tools import tool
from databricks_langchain import ChatDatabricks
from langchain.agents import create_agent

# autolog() registers a LangChain callback so MLflow automatically captures spans
# for every LLM call, tool invocation, and agent step.
mlflow.langchain.autolog()

@tool
def get_bank_account_number(user_name: str):
    """Return the bank account number for the given user name."""
    return "1234567890"

llm = ChatDatabricks(model="databricks-llama-4-maverick", use_ai_gateway=True)
graph = create_agent(llm, [get_bank_account_number])
Defina o processador de intervalo:
import re
from mlflow.entities.span import Span, SpanType

ACCOUNT_NUMBER_PATTERN = re.compile(r"\d{10}")

def filter_bank_account_number(span: Span) -> None:
    # The tool returns the account number directly — redact its output entirely.
    if span.span_type == SpanType.TOOL:
        span.set_outputs("[REDACTED]")
        return

    # For all other spans, mask any account-number pattern in the inputs and outputs.
    if span.inputs is not None:
        span.set_inputs(ACCOUNT_NUMBER_PATTERN.sub("[REDACTED]", str(span.inputs)))
    if span.outputs is not None:
        span.set_outputs(ACCOUNT_NUMBER_PATTERN.sub("[REDACTED]", str(span.outputs)))
Register the processor and invoke the agent:
mlflow.tracing.configure(span_processors=[filter_bank_account_number])

result = graph.invoke(
    {"messages": [{"role": "user", "content": "What is the bank account number for John Doe?"}]}
)
Redigir com o Microsoft Presidio
Para obter uma detecção de PII mais precisa além da regex, use o Microsoft Presidio. Um AnalyzerEngine detecta entidades como nomes, cartões de crédito e endereços de e-mail, e um AnonymizerEngine as reescreve.
import mlflow
from mlflow.entities.span import Span, SpanType

@mlflow.trace(span_type=SpanType.AGENT)
def customer_support_agent(request: str):
    return "Yes"
Inicialize o Presidio e defina o processador de span:
from presidio_analyzer import AnalyzerEngine
from presidio_anonymizer import AnonymizerEngine

analyzer = AnalyzerEngine()
anonymizer = AnonymizerEngine()

def filter_pii(span: Span) -> None:
    text = span.inputs.get("request")
    results = analyzer.analyze(
        text=text,
        entities=["PERSON", "CREDIT_CARD", "EMAIL_ADDRESS", "LOCATION", "DATE_TIME"],
        language="en",
    )
    anonymized_text = anonymizer.anonymize(text=text, analyzer_results=results)
    span.set_inputs({"request": anonymized_text.text})
Registre o processador e execute o agente:
mlflow.tracing.configure(span_processors=[filter_pii])

customer_support_agent(
    "Please cancel my credit card effective September 19th. My name is John Doe and my credit "
    "card number is 4095-2609-9393-4932. My email is john.doe@example.com and I live in Amsterdam."
)
Reset os processadores de intervalo
Para parar de ocultar intervalos, passe uma lista vazia para limpar todos os processadores registrados:
mlflow.tracing.configure(span_processors=[])
Ou use reset para limpar toda a configuração de rastreamento:
mlflow.tracing.reset()
Ocultar PII de rastreamentos OTel armazenados
Esta abordagem remove informações de identificação pessoal (PII) em spans de rastreamento OTel já armazenados no Unity Catalog, sem modificar seu agente. Um Lakeflow pipeline lê novos spans OTel de forma incremental, aplica ai_mask para mascarar PII e grava os resultados em um esquema separado com acesso mais amplo. Um job agendado lida com a limpeza opcional de retenção nas tabelas brutas.
Essa abordagem funciona com qualquer rastreamento OTel no Unity Catalog, incluindo rastreamentos gravados pelo MLflow. Consulte Armazenar rastreamentos OpenTelemetry no Unity Catalog.

Pré-requisitos
- Um workspace habilitado para o Unity Catalog.
- AI Functions disponíveis por meio de um SQL Warehouse serverless ou pipeline serverless.
- A CLI do Databricks foi autenticada no seu workspace.
- Dados de rastreamento do OTel nas tabelas do Unity Catalog. Consulte Store OpenTelemetry traces in Unity Catalog.
Download dos ativos
Faça download destes arquivos e importe-os para o seu workspace:
Arquivo | Descrição |
|---|---|
Notebook de implantação guiada — alternativa interativa ao | |
Script de implantação da CLI. | |
O pipeline — tabelas de transmissão com | |
Unified trace view joining spans and anotações. | |
Criação de esquemas e concessões de controle de acesso. | |
Configuração de exemplo do pipeline (referência). | |
Utilitário de teste que envia dados de teste de PII como intervalos OTel. | |
50 linhas de dados de teste de PII sintéticos. |
Implantar a solução
- Guided notebook (recommended)
- CLI
- Manual
Para uma implantação passo a passo diretamente no seu workspace:
- Importe deploy_notebook.py para o seu Workspace junto com os outros ativos download. Consulte as pastas Git do Databricks.
- Abrir
deploy_notebook.pyno seu workspace. - Preencha os parâmetros do widget na parte superior: catálogo, esquema de origem, esquema de destino e prefixo da tabela.
- Clique em Executar tudo . Cada etapa é validada antes de prosseguir.
This approach uses the Databricks Python SDK (no CLI required), is safe to re-run, and provides interactive feedback at each step.
Execute o script de implantação com os detalhes do seu workspace:
./deploy.sh <WORKSPACE_HOST> <CATALOG> <SOURCE_SCHEMA> <TARGET_SCHEMA> <TABLE_PREFIX>
Por exemplo:
./deploy.sh https://my-workspace.cloud.databricks.com my_catalog traces_raw traces_redacted my_app
O script faz o upload do SQL do pipeline, cria o esquema de destino, cria e aciona o pipeline e configura o TTL automático nas tabelas brutas se retention_days estiver definido. Após a conclusão do pipeline, execute unified_view.sql para criar a view de trace unificada.
- Criar o esquema de destino. Executar as instruções em
setup_schema_and_grants.sql. - Upload the pipeline SQL. Import
pii_redaction_pipeline.sqlinto your workspace. - Crie o pipeline. Use
pipeline_config.jsoncomo um padrão e substitua os valores de<PLACEHOLDER>. - Trigger a execução de um pipeline. Use a interface do usuário ou execute
databricks pipelines start-update <PIPELINE_ID>. - Criar a view unificada. Execute
unified_view.sqlapós a primeira execução do pipeline. - Configure a retenção. Ative o auto time-to-live nas tabelas brutas.
Parâmetros de implantação
Passe cada parâmetro como um valor de widget em deploy_notebook.py ou como um argumento para deploy.sh.
Parâmetro | Descrição | Padrão |
|---|---|---|
| Catálogo do Unity Catalog para as tabelas brutas e redigidas. | (obrigatório) |
| Esquema que contém as tabelas OTel brutas. | (obrigatório) |
| Esquema para as tabelas de saída redigidas. | (obrigatório) |
| Prefixo para os nomes de tabela OTel. | (obrigatório) |
| Tipos de PII para ocultar, separados por vírgula e entre aspas simples. |
|
| Nome para o pipeline. |
|
| Dias para reter os dados brutos antes da exclusão. Um valor em branco, |
|
| Modo de execução do pipeline: |
|
| Com que frequência o pipeline é executado (somente no modo Trigger): |
|
As tabelas de origem seguem o padrão de nomenclatura {catalog}.{source_schema}.{table_prefix}_otel_spans, {catalog}.{source_schema}.{table_prefix}_otel_logs e {catalog}.{source_schema}.{table_prefix}_otel_annotations.
Modos de pipeline:
- triggered : Cria um Job agendado que executa o pipeline na frequência configurada. O pipeline processa novos dados em cada execução e, em seguida, para.
- continuous : O pipeline é executado continuamente, processando novos dados à medida que chegam. Custo de compute mais alto do que no modo Trigger porque o pipeline está sempre ativo.
Parâmetros de ocultação de PII
Estes parâmetros controlam qual PII é ocultada e como. Passe pii_categories como um parâmetro de implantação; edite pii_redaction_pipeline.sql diretamente para substituir os outros.
Parâmetro | Descrição | Exemplo |
|---|---|---|
| Lista de tipos de PII a serem detectados e ocultados. Valores compatíveis: |
|
| Como mascarar PII: |
|
| Caractere usado quando |
|
| Campos do OTel aos quais aplicar a ocultação. |
|
| Chaves de atributo para ignorar a ocultação — por exemplo, metadados técnicos que não carregam PII. |
|
| Padrões Regex para PII específica de domínio não cobertos por |
|
Para padrões personalizados como IDs de funcionários (EMP-XXXXXX), aplique regexp_replace antes de ai_mask no SQL do pipeline.
O que é redigido
O pipeline aplica ai_mask aos seguintes campos:
Tabela | Campos redigidos |
|---|---|
Intervalos |
|
Registros |
|
anotação | Passagem — nenhum PII esperado |
Os campos que não contêm PII são preservados sem alterações: IDs de trace, IDs de span, Timestamp, nomes de serviço e códigos de status.
ai_mask tem suporte de LLM e lida com vários formatos de PII sem exigir um padrão separado por variação — por exemplo, números de telefone em (555) 123-4567, 555.123.4567 ou +1 555-123-4567 são todos reconhecidos.
Retenção e controle de acesso
Retenção de dados brutos : a implantação configura o tempo de vida automático nas tabelas OTel brutas para excluir dados de rastreio com mais de um número configurável de dias (default: 90). Isso oferece suporte ao GDPR e a regulamentos de proteção de dados semelhantes. Defina retention_days como 0 ou none para gerenciar a retenção separadamente.
A precisão da temporização da exclusão de auto-TTL não é garantida. Pode haver um buffer de até 6 dias entre a expiração da linha e a exclusão permanente, além da duração de retenção de dados (default de 7 dias). Se os seus requisitos de compliance exigirem cronogramas rígidos de exclusão, use um job agendado com DELETE e VACUUM manuais em vez disso.
Access control : the raw OTel tables contain unredacted PII and should have restricted access. Grant access to the raw source schema only to the pipeline service principal and administrators who need it for depuração or incident response. All routine analytics and observability fluxos de trabalho should query the redacted tables. The setup_schema_and_grants.sql file includes example grants. For Unity Catalog privilege details, see Gerenciar privileges in Unity Catalog.
Testar a redação
Gere extensões de teste com PII conhecida para validar a saída:
pip install opentelemetry-exporter-otlp-proto-http

python send_pii_traces.py <WORKSPACE_HOST> <CATALOG.SCHEMA.PREFIX_otel_spans>
Isso envia 50 rastreamentos de teste com e-mails, telefones, SSNs, cartões de crédito, nomes e endereços.
Após executar o pipeline, compare os intervalos brutos e redigidos:
SELECT
  s.span_id,
  CAST(s.attributes AS STRING) AS raw,
  CAST(r.attributes AS STRING) AS redacted
FROM <source_catalog>.<source_schema>.<prefix>_otel_spans s
JOIN <target_catalog>.<target_schema>.redacted_spans r
  ON s.trace_id = r.trace_id AND s.span_id = r.span_id
WHERE s.name = 'pii-test-interaction'
LIMIT 5;
Arquitetura de referência
Dois fluxos estão disponíveis. Use o Flow 1 (pipeline em lote) para a maioria das implantações de produção — ele pré-materializa tabelas ocultas para consultas rápidas e oferece suporte à retenção auto-TTL. Use o Flow 2 (baseado em view) como uma opção leve quando o custo de armazenamento for a principal preocupação e as queries forem pouco frequentes.
Dimensão | Fluxo 1: pipeline em lotes | Flow 2: view-based |
|---|---|---|
Custo de armazenamento | 2x (com janela de tempo; ~1x se o TTL automático for aplicado) | 1x — sem duplicação |
Custo de compute | Uma vez por registro | Por consulta |
Desempenho da query | Rápido (pré-materializado) | Lento (recomputa em cada query) |
Latência até a disponibilidade | Minutos (intervalo do pipeline) | Imediatamente |
Implantação de alteração de regra | Refresh do pipeline | Instantâneo |
compliance com GDPR | Auto-TTL ou limpeza programada em tabelas brutas | Auto-TTL ou limpeza programada em tabelas brutas |
Melhor para | Uso principal na produção | Uso com baixo volume de query ou provisório |
Fluxo 1: Pipeline em lotes (recomendado)
Um Lakeflow pipeline materializa tabelas de transmissão redigidas a partir das tabelas OTel brutas. Os spans do OTel são apenas de anexação, o que os torna ideais para ingestão de transmissão incremental.
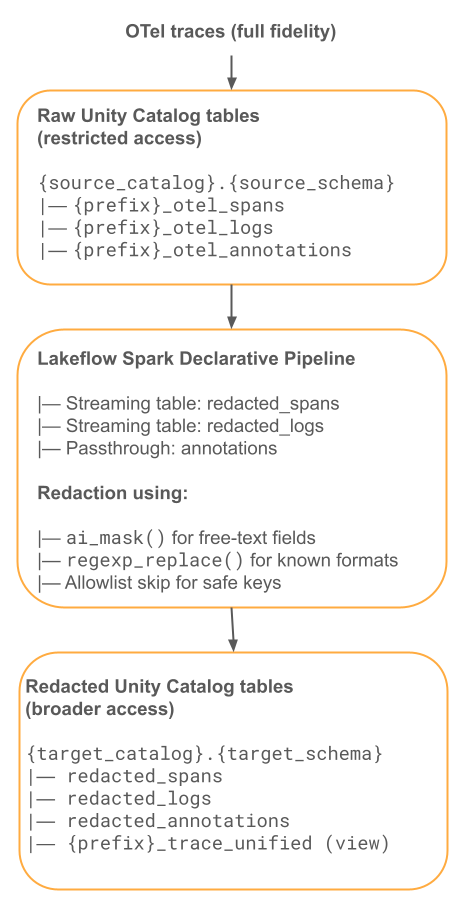
O SQL a seguir define as tabelas de transmissão redigidas (pii_redaction_pipeline.sql):
-- Streaming Table: Redacted Spans
CREATE OR REFRESH STREAMING TABLE redacted_spans
COMMENT 'PII-redacted OTel spans'
TBLPROPERTIES (
  'quality' = 'gold',
  'pipelines.autoOptimize.zOrderCols' = 'trace_id,date'
)
AS
SELECT
  trace_id, span_id, parent_span_id, name, kind, start_time, end_time,
  status, date, record_id, service_name, time, instrumentation_scope,

  -- Redact span attributes
  CASE
    WHEN attributes IS NOT NULL THEN
      ai_mask(CAST(attributes AS STRING), array(${pii_categories}))
    ELSE attributes
  END AS attributes,

  -- Redact resource attributes
  CASE
    WHEN resource:attributes IS NOT NULL THEN
      named_struct(
        'attributes',
        ai_mask(CAST(resource:attributes AS STRING), array(${pii_categories})),
        'dropped_attributes_count', resource:dropped_attributes_count
      )
    ELSE resource
  END AS resource,

  -- Redact events (may contain exception messages with PII)
  CASE
    WHEN events IS NOT NULL THEN
      ai_mask(CAST(events AS STRING), array(${pii_categories}))
    ELSE events
  END AS events,

  -- Pass through links unchanged (typically just trace/span IDs)
  links

FROM STREAM(${source_catalog}.${source_schema}.${table_prefix}_otel_spans);


-- Streaming Table: Redacted Logs
CREATE OR REFRESH STREAMING TABLE redacted_logs
COMMENT 'PII-redacted OTel logs'
AS
SELECT
  trace_id, span_id, severity_number, severity_text, date, record_id,
  service_name, time, instrumentation_scope,

  CASE
    WHEN body IS NOT NULL THEN
      ai_mask(CAST(body AS STRING), array(${pii_categories}))
    ELSE body
  END AS body,

  CASE
    WHEN attributes IS NOT NULL THEN
      ai_mask(CAST(attributes AS STRING), array(${pii_categories}))
    ELSE attributes
  END AS attributes,

  CASE
    WHEN resource:attributes IS NOT NULL THEN
      named_struct(
        'attributes',
        ai_mask(CAST(resource:attributes AS STRING), array(${pii_categories})),
        'dropped_attributes_count', resource:dropped_attributes_count
      )
    ELSE resource
  END AS resource

FROM STREAM(${source_catalog}.${source_schema}.${table_prefix}_otel_logs);


-- Streaming Table: Annotations (passthrough — no PII expected)
CREATE OR REFRESH STREAMING TABLE redacted_annotations
COMMENT 'OTel annotations (passthrough, no PII redaction applied)'
AS SELECT * FROM STREAM(${source_catalog}.${source_schema}.${table_prefix}_otel_annotations);
Restrinja o acesso às tabelas brutas e conceda acesso às tabelas redigidas:
-- Lock down raw tables: grant only to the pipeline service principal
GRANT USE CATALOG ON CATALOG ${source_catalog} TO `pii_pipeline_sp`;
GRANT USE SCHEMA ON SCHEMA ${source_catalog}.${source_schema} TO `pii_pipeline_sp`;
GRANT SELECT ON TABLE ${source_catalog}.${source_schema}.${table_prefix}_otel_spans TO `pii_pipeline_sp`;
GRANT SELECT ON TABLE ${source_catalog}.${source_schema}.${table_prefix}_otel_logs TO `pii_pipeline_sp`;
REVOKE SELECT ON TABLE ${source_catalog}.${source_schema}.${table_prefix}_otel_spans FROM `data_team`;

-- Broad access to redacted tables only
GRANT USE CATALOG ON CATALOG ${target_catalog} TO `data_team`;
GRANT USE SCHEMA ON SCHEMA ${target_catalog}.${target_schema} TO `data_team`;
GRANT SELECT ON SCHEMA ${target_catalog}.${target_schema} TO `data_team`;
Configure a retenção de auto-TTL nas tabelas brutas para a compliance com o GDPR:
ALTER TABLE ${source_catalog}.${source_schema}.${table_prefix}_otel_spans
  DELETE ROWS ${retention_days} DAYS AFTER time;

ALTER TABLE ${source_catalog}.${source_schema}.${table_prefix}_otel_logs
  DELETE ROWS ${retention_days} DAYS AFTER time;
Create the unified trace view pointing at the redacted tables:
CREATE OR REPLACE VIEW ${target_catalog}.${target_schema}.${table_prefix}_trace_unified AS
SELECT
  s.trace_id,
  s.date,
  min(s.start_time) AS request_time,
  max(s.end_time) - min(s.start_time) AS execution_duration,
  collect_list(
    named_struct(
      'span_id', s.span_id,
      'parent_span_id', s.parent_span_id,
      'name', s.name,
      'kind', s.kind,
      'start_time', s.start_time,
      'end_time', s.end_time,
      'status', s.status,
      'attributes', s.attributes,
      'events', s.events
    )
  ) AS spans,
  a.tags,
  a.assessments
FROM ${target_catalog}.${target_schema}.redacted_spans s
LEFT JOIN ${target_catalog}.${target_schema}.redacted_annotations a
  ON s.trace_id = a.target_id
GROUP BY s.trace_id, s.date, a.tags, a.assessments;
Padrão de configuração do pipeline (pipeline_config.json):
{
  "name": "otel-pii-redaction",
  "catalog": "${target_catalog}",
  "schema": "${target_schema}",
  "serverless": true,
  "continuous": false,
  "channel": "CURRENT",
  "configuration": {
    "source_catalog": "<value>",
    "source_schema": "<value>",
    "table_prefix": "<value>",
    "pii_categories": "'email','phone','ssn','credit_card','name','address'"
  },
  "libraries": [{ "file": { "path": "/Workspace/path/to/pii_redaction_pipeline.sql" } }]
}
Fluxo 2: redação baseada em view
This flow applies ai_mask in a Unity Catalog view so redaction happens at read time — no redacted copy is stored, and no pipeline job is required.
Quando usar:
- O custo de armazenamento é uma preocupação principal, e uma segunda cópia dos dados de trace não é aceitável.
- Os dados redigidos são consultados com pouca frequência, portanto, o custo de compute por query da execução de
ai_maské aceitável. - Você deseja que as regras de redação entrem em vigor instantaneamente sem um refresh do pipeline.
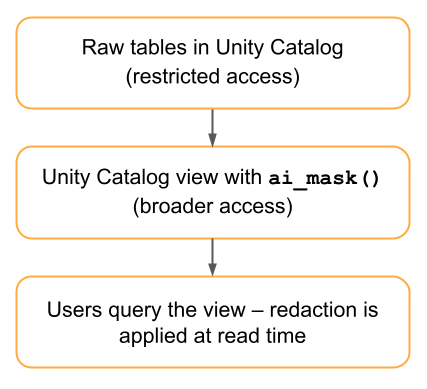
CREATE OR REPLACE VIEW ${target_catalog}.${target_schema}.${table_prefix}_otel_spans_redacted
AS
SELECT
  trace_id, span_id, parent_span_id, name, kind, start_time, end_time,
  status, date, service_name, time, instrumentation_scope, links,

  ai_mask(CAST(attributes AS STRING), array(${pii_categories})) AS attributes,
  ai_mask(CAST(events AS STRING), array(${pii_categories})) AS events,

  named_struct(
    'attributes',
    ai_mask(CAST(resource:attributes AS STRING), array(${pii_categories})),
    'dropped_attributes_count', resource:dropped_attributes_count
  ) AS resource

FROM ${source_catalog}.${source_schema}.${table_prefix}_otel_spans;
Trade-offs:
Aspecto | Vantagens | Desvantagens |
|---|---|---|
Armazenar | Nenhuma duplicação. | — |
Compute | — |
|
Latência | Reflete novos dados imediatamente. | Resposta de query mais lenta. |
Flexibilidade | As regras de ocultação são atualizadas instantaneamente sem um refresh do pipeline. | — |
Lista de verificação de implementação
Before deploying to production:
- Validar o comportamento de
ai_maskem colunas VARIANT com dados de span OTel de amostra. - Faça o benchmark do throughput de
ai_maskpara dimensionar o intervalo do programar do pipeline. - Defina as chaves de atributo incluídas na lista de permissões que devem ignorar a ocultação.
- Configure grupos de controle de acesso: acesso bruto vs. acesso redigido.
- Configure o TTL automático para retenção de tabela bruta ou um job de
DELETEeVACUUMagendado para cronogramas de exclusão estritos. - Crie um painel de monitoramento para a integridade do pipeline e a cobertura de redação.
Recursos adicionais
- Armazenar rastreamentos do OpenTelemetry no Unity Catalog
- Observar e encontrar problemas
- Transformar dados não estruturados usando AI Functions
- Políticas de serviço para itens protegíveis de IA
- MLflow — Ocultando dados sensíveis de rastreamentos
Próximo o passo: Exportar rastreamentos do MLflow para o OpenTelemetry