Pesquisa Lakebase
Beta
A partir de 15 de junho, o Lakebase estará disponível em Beta no GCP. Consulte Disponibilidade de região para ver as regiões compatíveis.
O Lakebase Search adiciona pesquisa vetorial e por palavra-chave híbrida aos projetos do Lakebase. Habilite-o nas configurações do seu projeto e instale as extensões necessárias: lakebase_vector para pesquisa vetorial, lakebase_text para pesquisa de palavras-chave BM25 e, opcionalmente, lakebase_tokenizer para tokenização configurável.
Pesquisa vetorial, por palavra-chave e híbrida
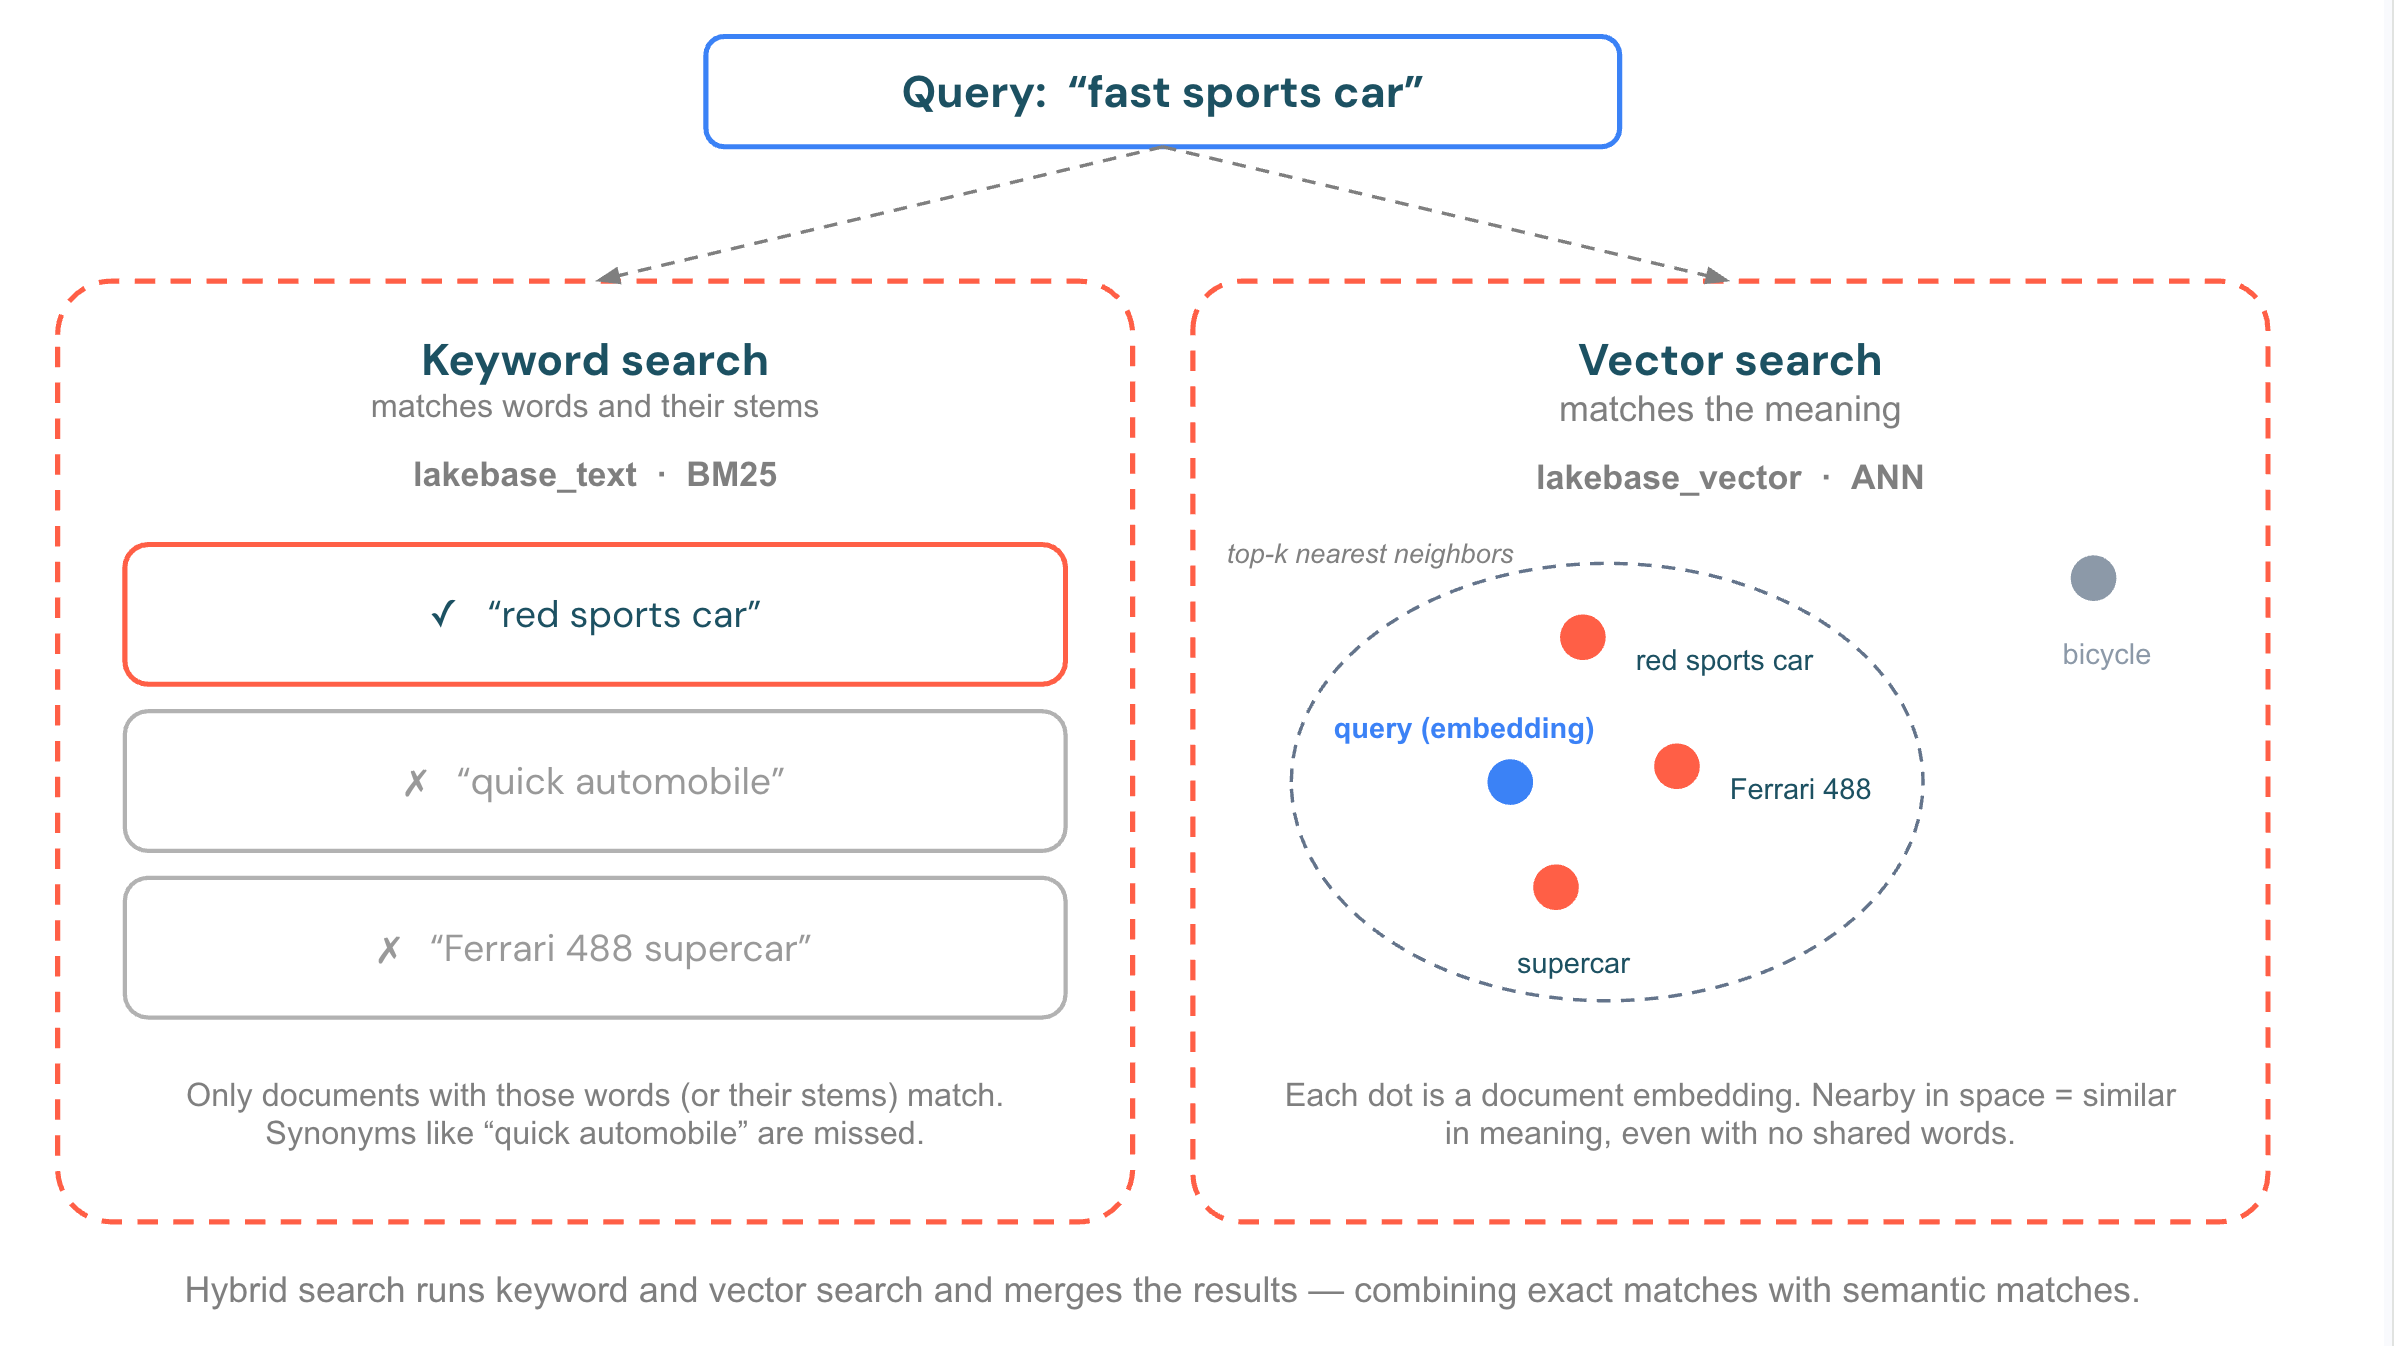
Lakebase Search fornece dois métodos de pesquisa complementares. Use-os individualmente ou combine-os para pesquisa híbrida:
- Pesquisa vetorial (semântica) encontra linhas cujo significado é o mais próximo da sua consulta, mesmo quando não compartilham nenhuma palavra. Você consulta com uma incorporação (um vetor numérico produzido por um modelo), e o índice retorna os vetores mais próximos por distância. Use-o para perguntas em linguagem natural, recomendações e geração aumentada de recuperação (RAG). Com tecnologia da
lakebase_vector. - A pesquisa por palavra-chave (texto completo) classifica as linhas pela correspondência com os termos exatos na sua consulta, usando a pontuação de relevância BM25. Use-o para nomes, códigos e pesquisas de termos exatos onde a redação importa. Com tecnologia da
lakebase_text. - A pesquisa híbrida executa ambas as pesquisas e combina os resultados em uma única lista classificada, para que você obtenha correspondências semanticamente semelhantes e de termos exatos juntas. Use-o quando as consultas misturam intenção com termos específicos, o caso mais comum na pesquisa do mundo real.
Como funciona
Nos bastidores, o Lakebase Search foi criado com base em três extensões do Postgres:
-
O lakebase_vector adiciona busca vetorial de vizinho mais próximo aproximada (ANN) via o tipo de índice
lakebase_ann. É um complemento imediato para pgvector: os mesmos tipos de vetor, operadores de distância e sintaxe de consulta funcionam sem modificação. Internamente, ele usa o particionamento IVF com quantização RaBitQ, que suporta índices de mais de 1 bilhão de vetores em um único índice e é construído até 50 a 100 vezes mais rápido que HNSW. Os índices são apoiados por armazenamento e sobrevivem à escala para zero sem pré-aquecimento. -
lakebase_text adiciona pesquisa de texto completo BM25 através do tipo de índice
lakebase_bm25. É compatível com os tipos padrãotsvectore operadores de consulta do PostgreSQL. A classificação BM25 considera simultaneamente a frequência de termos, o tamanho do documento e as estatísticas de todo o corpus. Top-K pushdown (Block-Max WAND) recupera apenas os K resultados mais relevantes do índice, em vez de pontuar cada correspondência. -
O lakebase_tokenizer adiciona tokenização de palavra inteira configurável por meio da interface de dicionário de busca de texto do PostgreSQL. Ele produz valores padrão
tsvectordo PostgreSQL que funcionam com índices GIN e índiceslakebase_bm25. Consulte lakebase_tokenizer para obter as opções e a configuração compatíveis.
Disponibilize dados lakehouse para pesquisa
Você pode disponibilizar a pesquisa sobre dados originados no lakehouse, não apenas dados gravados diretamente no Postgres. Use tabelas sincronizadas para sincronizar uma tabela do Unity Catalog com o Lakebase e mapeie suas colunas para tipos Postgres prontos para pesquisa durante a sincronização:
- Mapeie uma coluna de incorporação para uma coluna
vector(n)para pesquisa vetorial. - Gere uma coluna
tsvectora partir do texto de origem para pesquisa por palavra-chave.
Após a conclusão da sincronização, crie um índice lakebase_ann ou lakebase_bm25 na coluna sincronizada e disponibilize pesquisa de baixa latência para suas aplicações juntamente com seus dados operacionais. Para a configuração de mapeamento, consulte Mapeamento de tipo personalizado para o Lakebase Search.
Requisitos
- Postgres 16 ou posterior
- Habilitar a pesquisa Lakebase em um projeto é irreversível
Habilitar o Lakebase Search
Habilite o Lakebase Search nas configurações do seu projeto:
- No seu projeto Lakebase, clique em Configurações na navegação à esquerda.
- Em Lakebase Search , clique em Ativar Lakebase Search .
Habilitando o Lakebase Search:
- Reinicia todos os computes no seu projeto, descartando quaisquer conexões ativas
- Torna as extensões
lakebase_vector,lakebase_textelakebase_tokenizerdisponíveis para instalação - Não pode ser desativado uma vez habilitado
Instalar extensões
Após habilitar o Lakebase Search, instale as extensões em seu banco de dados:
-- Required: vector search (CASCADE installs pgvector as a dependency)
CREATE EXTENSION IF NOT EXISTS lakebase_vector CASCADE;

-- Required: BM25 full-text search
CREATE EXTENSION IF NOT EXISTS lakebase_text;

-- Optional: configurable tokenization
CREATE SCHEMA IF NOT EXISTS tokenizer_ext;
CREATE EXTENSION IF NOT EXISTS lakebase_tokenizer WITH SCHEMA tokenizer_ext;
Começar
O exemplo a seguir cria uma tabela documents com uma coluna vetorial e uma coluna de pesquisa de texto completo, e depois executa consultas vetoriais e de palavra-chave:
Estes exemplos usam pequenos vetores literais como '[0.1, 0.2, 0.3]' para ilustração. Em uma aplicação real, gere incorporações externamente com um modelo de incorporação e, em seguida, armazene o resultado na coluna VECTOR. No Databricks, você pode fazer uma query em um modelo de incorporação usando o Model Serving, por exemplo, com ai_query em um notebook ou no Databricks SQL, e inserir os vetores resultantes no Lakebase. A coluna e o índice VECTOR(n) devem usar a mesma dimensão n da saída do seu modelo (geralmente de 384 a 1536).
-- Create a table with a vector column and a tsvector column
CREATE TABLE documents (
  id        SERIAL PRIMARY KEY,
  title     TEXT NOT NULL,
  body      TEXT NOT NULL,
  embedding VECTOR(3),
  body_tsv  TSVECTOR
);

-- Create a vector search index
CREATE INDEX documents_embedding_idx ON documents
  USING lakebase_ann (embedding vector_cosine_ops);

-- Insert sample data and populate the tsvector column
INSERT INTO documents (title, body, embedding, body_tsv) VALUES
  ('Postgres overview', 'Postgres is an open-source relational database.', '[0.1, 0.2, 0.3]', to_tsvector('english', 'Postgres is an open-source relational database.')),
  ('Vector search guide', 'Vector search finds semantically similar results.', '[0.4, 0.5, 0.6]', to_tsvector('english', 'Vector search finds semantically similar results.')),
  ('Full-text search', 'BM25 ranking improves keyword search relevance.', '[0.7, 0.8, 0.9]', to_tsvector('english', 'BM25 ranking improves keyword search relevance.'));

-- Build the BM25 index after inserting data
-- BM25 computes corpus statistics at build time, not incrementally
CREATE INDEX documents_body_bm25 ON documents USING lakebase_bm25 (body_tsv);

-- Vector similarity search
SELECT id, title
FROM documents
ORDER BY embedding <=> '[0.1, 0.2, 0.3]'
LIMIT 5;

-- BM25 keyword search (lower score = more relevant)
SELECT id, title,
  body_tsv <@> to_bm25query(to_tsvector('english', 'database'), 'documents_body_bm25') AS score
FROM documents
ORDER BY score
LIMIT 5;
Combine os resultados com pesquisa híbrida
O seguinte exemplo de pesquisa híbrida reutiliza a tabela documents e os índices de Começar. Ele recupera os principais candidatos de cada pesquisa independentemente, depois os combina em uma única classificação usando a Reciprocal Rank Fusion (RRF): os resultados que se classificam bem em uma ou ambas as pesquisas pontuam mais alto.
WITH vector_ranked AS (
  SELECT id, RANK() OVER (ORDER BY dist) AS rank
  FROM (
    SELECT id, embedding <=> '[0.1, 0.2, 0.3]' AS dist
    FROM documents
    ORDER BY dist
    LIMIT 40
  ) v
),
keyword_ranked AS (
  SELECT id, RANK() OVER (ORDER BY score) AS rank
  FROM (
    SELECT id, body_tsv <@> to_bm25query(to_tsvector('english', 'database'), 'documents_body_bm25') AS score
    FROM documents
    ORDER BY score
    LIMIT 40
  ) k
)
SELECT d.id, d.title,
  COALESCE(1.0 / (60 + v.rank), 0) + COALESCE(1.0 / (60 + k.rank), 0) AS rrf_score
FROM documents d
LEFT JOIN vector_ranked v ON d.id = v.id
LEFT JOIN keyword_ranked k ON d.id = k.id
WHERE v.id IS NOT NULL OR k.id IS NOT NULL
ORDER BY rrf_score DESC, d.id
LIMIT 10;
Cada CTE obtém seus próprios 40 candidatos principais. RANK() atribui a mesma classificação a pontuações empatadas. A constante 60 diminui a influência de resultados de baixa classificação, e d.id desempata para uma paginação estável. Ajuste o LIMIT por lista e a constante RRF para seus dados. Outros métodos de fusão, como a pontuação ponderada, também são válidos.
Extensões
Extensão | Propósito | Tipo de índice |
|---|---|---|
Pesquisa vetorial rede neurais artificiais (ANN), compatível com pgvector |
| |
Pesquisa de texto completo BM25, compatível com FTS |
| |
Tokenização configurável | Não aplicável |