Estágio lento do Spark com pouca E/S
Se um estágio é executado lentamente, mas lê, grava e reorganiza poucos dados, a query em si geralmente é o gargalo.
Use esta página depois de descartar skew and spill e high I/O no estágio mais longo. Se o estágio tiver apenas uma tarefa, consulte Long Spark stage with one task.
Um estágio lento com pouca E/S pode ter estas causas:
- Lendo muitos arquivos pequenos
- Escrevendo muitos arquivos pequenos
- UDFs lentas
- Cartesiano join
- Explodindo join ou explode
Use o DAG SQL para identificar quase todos esses problemas.
Abra o SQL DAG
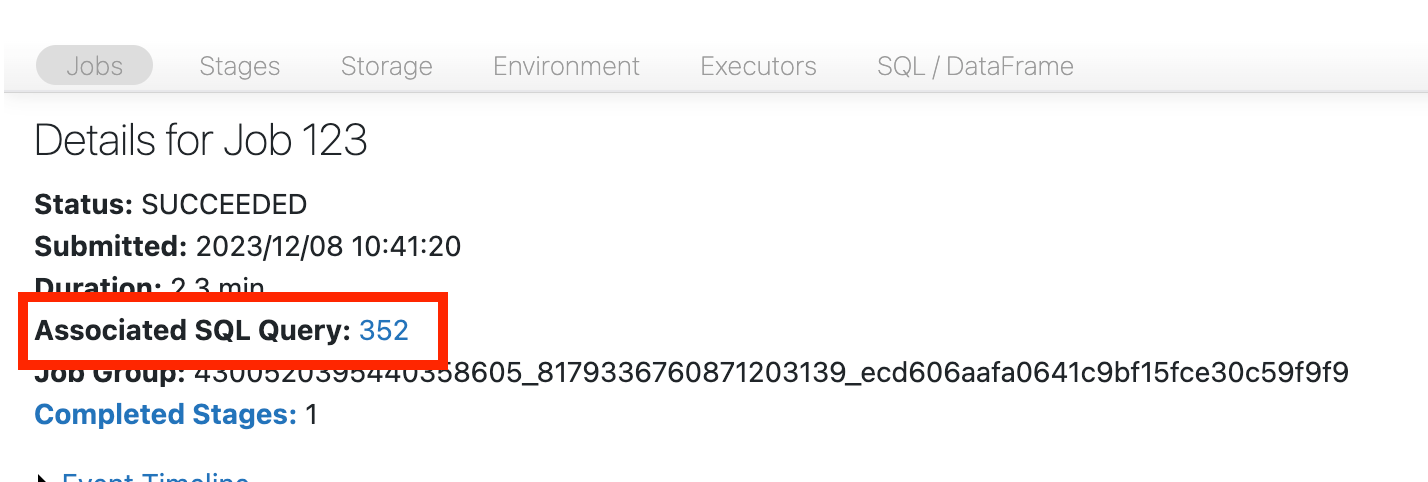
Para abrir o DAG SQL, role até o topo da página do job e clique em Query SQL Associada :
O DAG aparece. Se não aparecer, role para encontrá-lo:
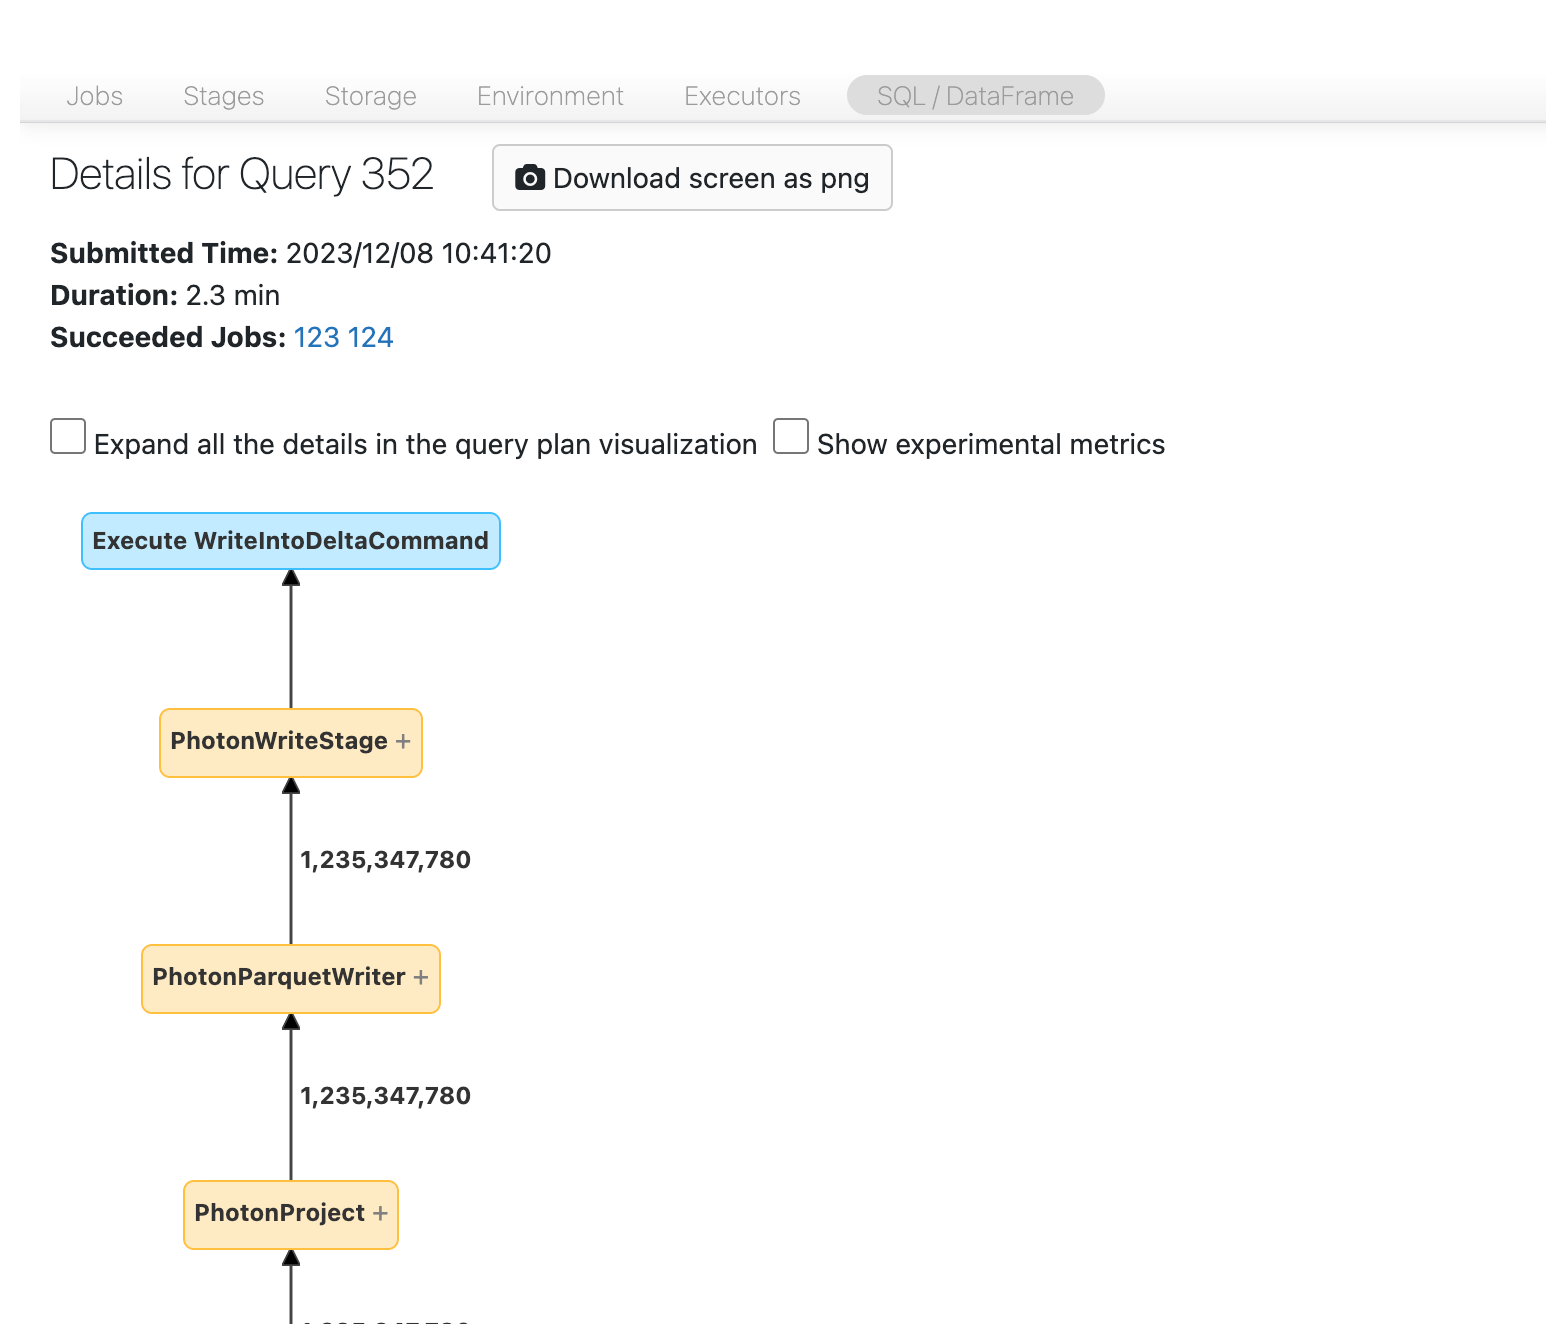
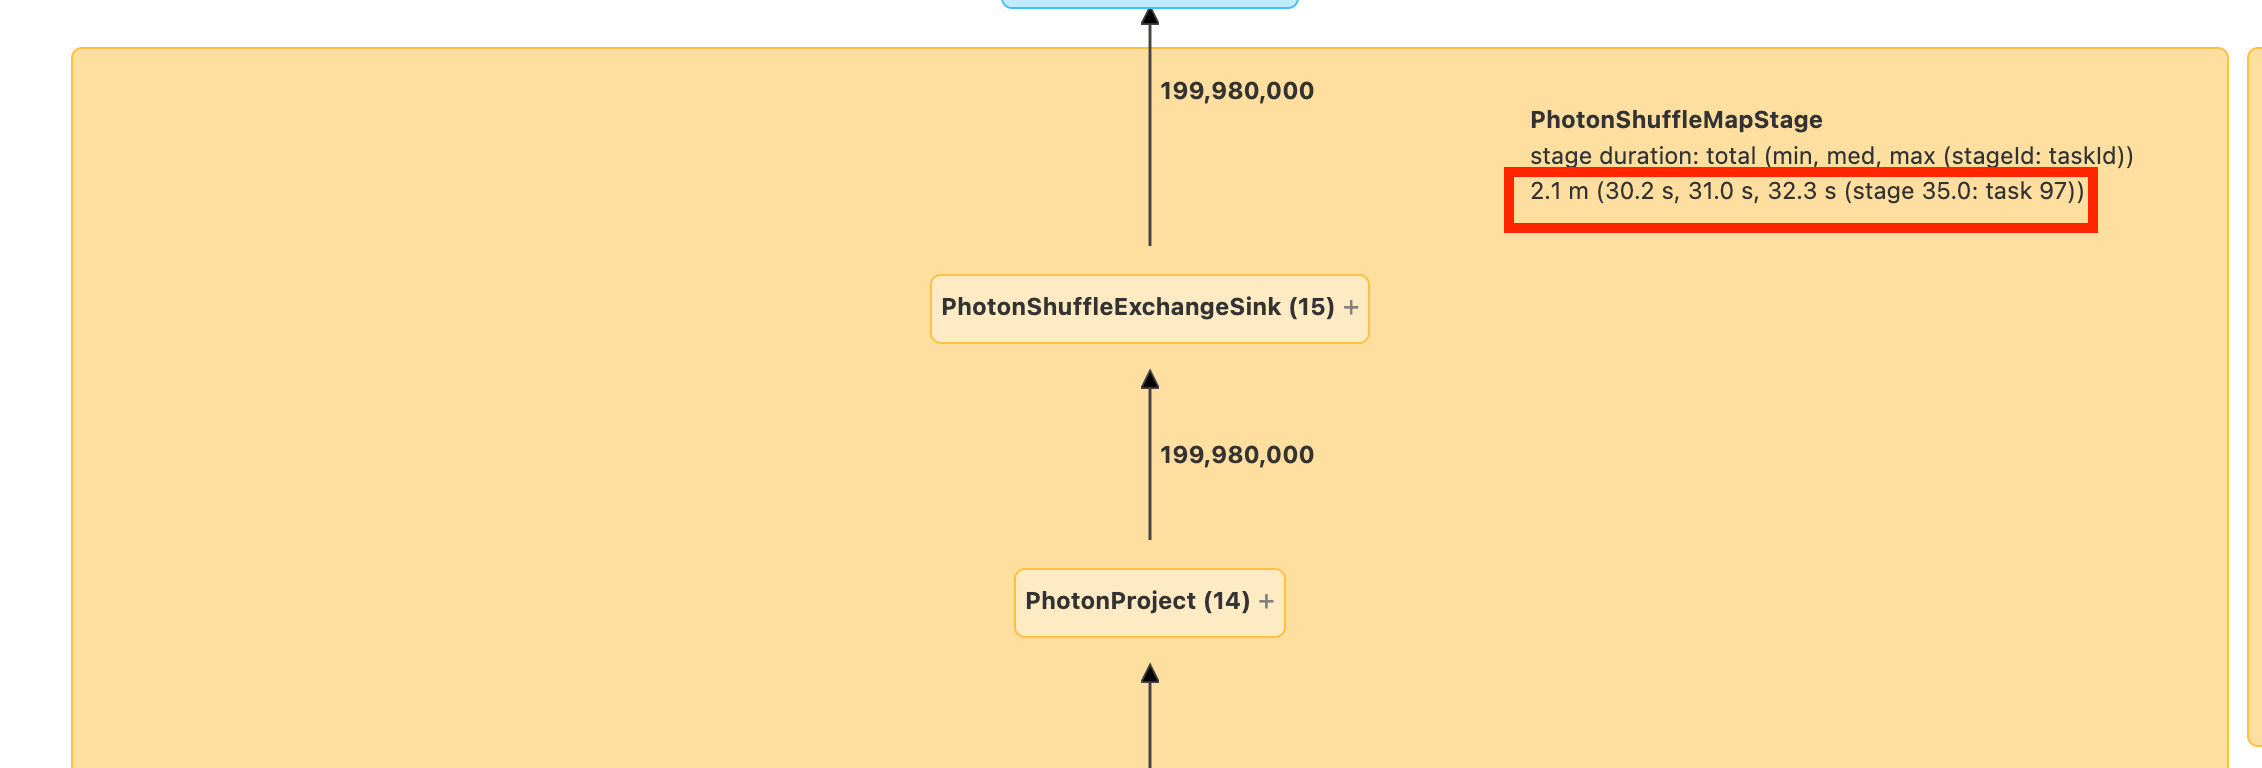
Estude o DAG para identificar onde o tempo está sendo gasto. Alguns nós mostram sua duração diretamente. Por exemplo, este nó mostra uma duração de 2,1 minutos e inclui o ID do estágio:
Os outros nós só mostram sua duração depois que você clica neles. Neste exemplo, a duração do nó de gravação é de 1,4 minutos:
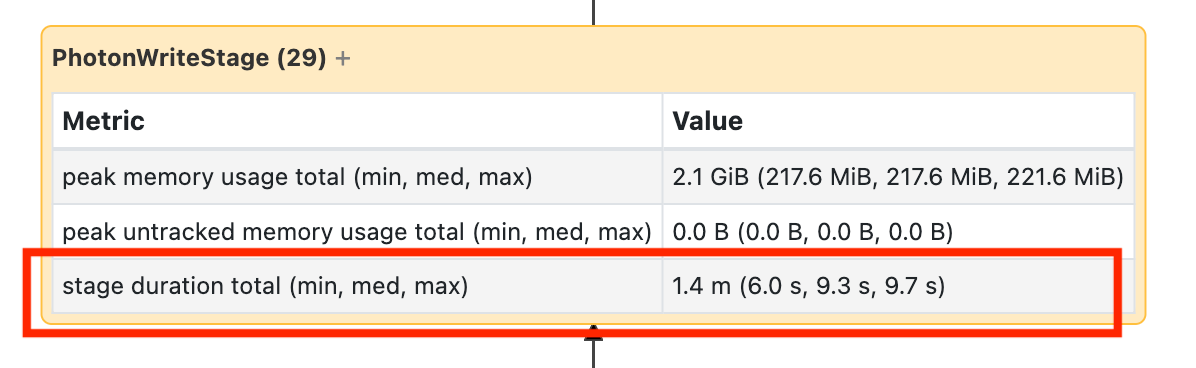
Esses tempos são cumulativos e representam a soma do tempo do executor em todas as tarefas, não o tempo real decorrido. Eles se correlacionam com o tempo decorrido e o custo.
Clique em um operador para ver métricas como linhas de saída, pico de memória e tamanho de spill. Para obter definições das métricas de operador que o Spark relata, consulte Métricas SQL na documentação da interface da Web do Apache Spark.
Lendo muitos arquivos pequenos
Se um operador de varredura consumir a maior parte do tempo, clique nele e confira o número de arquivos lidos:
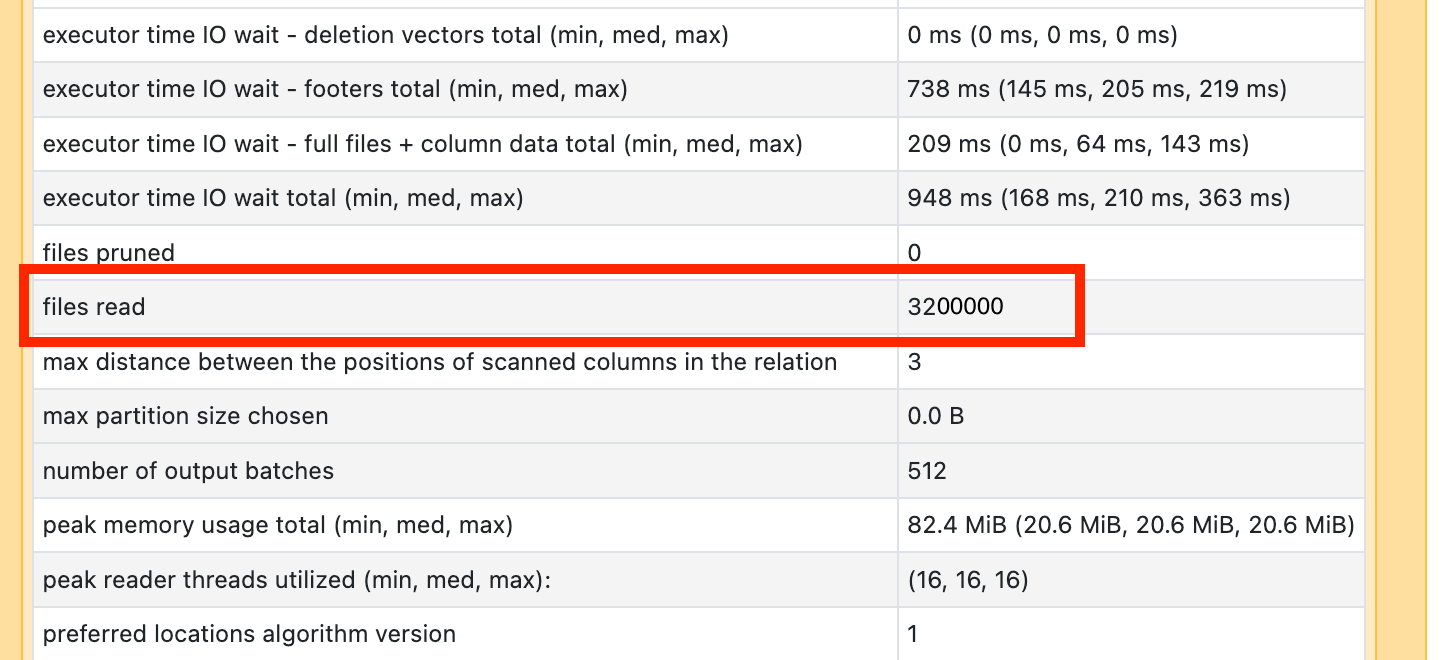
Se a query ler dezenas de milhares de arquivos ou mais, a tabela pode ter um problema de arquivos pequenos. Os arquivos devem ter pelo menos 8 MB. O particionamento em muitas colunas ou em uma coluna de alta cardinalidade é a causa mais comum de arquivos pequenos.
Executar OPTIMIZE pode ajudar. O Databricks também recomenda habilitar a otimização preditiva e reconsiderar a disposição do arquivo.
Escrevendo muitos arquivos pequenos
Se um operador de gravação consumir a maior parte do tempo, clique nele e verifique o número de arquivos e dados gravados:
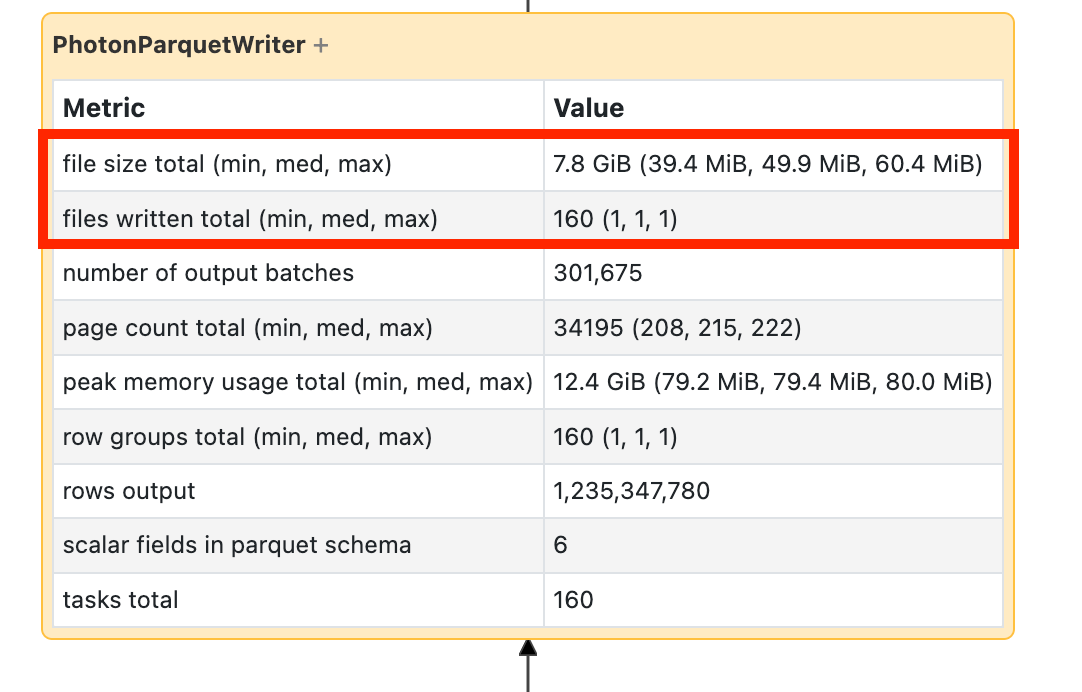
Se a query gravar dezenas de milhares de arquivos ou mais, a tabela poderá ter um problema com arquivos pequenos. Os arquivos devem ter pelo menos 8 MB. O particionamento em muitas colunas ou em uma coluna de alta cardinalidade geralmente causa arquivos pequenos. Habilite a otimização preditiva, considere a disposição do arquivo ou ative as gravações otimizadas.
UDFs lentos
Se a query contiver UDFs ou um nó DAG como este, UDFs podem ser o gargalo:

Para verificar, comente o UDF e observe a velocidade do pipeline. Se o UDF for o gargalo, reescreva-o usando funções nativas sempre que possível. Se você não puder reescrevê-lo, verifique o número de tarefas que executam a execução do UDF. Se o estágio tiver menos tarefas do que o cluster tem núcleos, repartition() o DataFrame antes de aplicar o UDF:
  (df
    .repartition(num_cores)
    .withColumn('new_col', udf(...))
  )
As UDFs também podem causar problemas de memória. Cada tarefa pode carregar todos os dados da sua partição na memória. Se esses dados forem muito grandes, a query pode ficar lenta ou instável. Repartitioning também ajuda aqui porque torna cada tarefa menor.
Cartesiano join
Joins cartesianos e joins de loop aninhados são muito caros. Se um deles aparecer no DAG, verifique se é intencional e considere alternativas. Se a condição de join for um ponto em um intervalo ou uma condição de sobreposição de intervalos, consulte Otimização da união de intervalos.
Exploding join ou explode
Se um nó de DAG exibir um pequeno número de linhas de entrada e muito mais linhas de saída, um join de expansão ou explode() pode ser a causa:
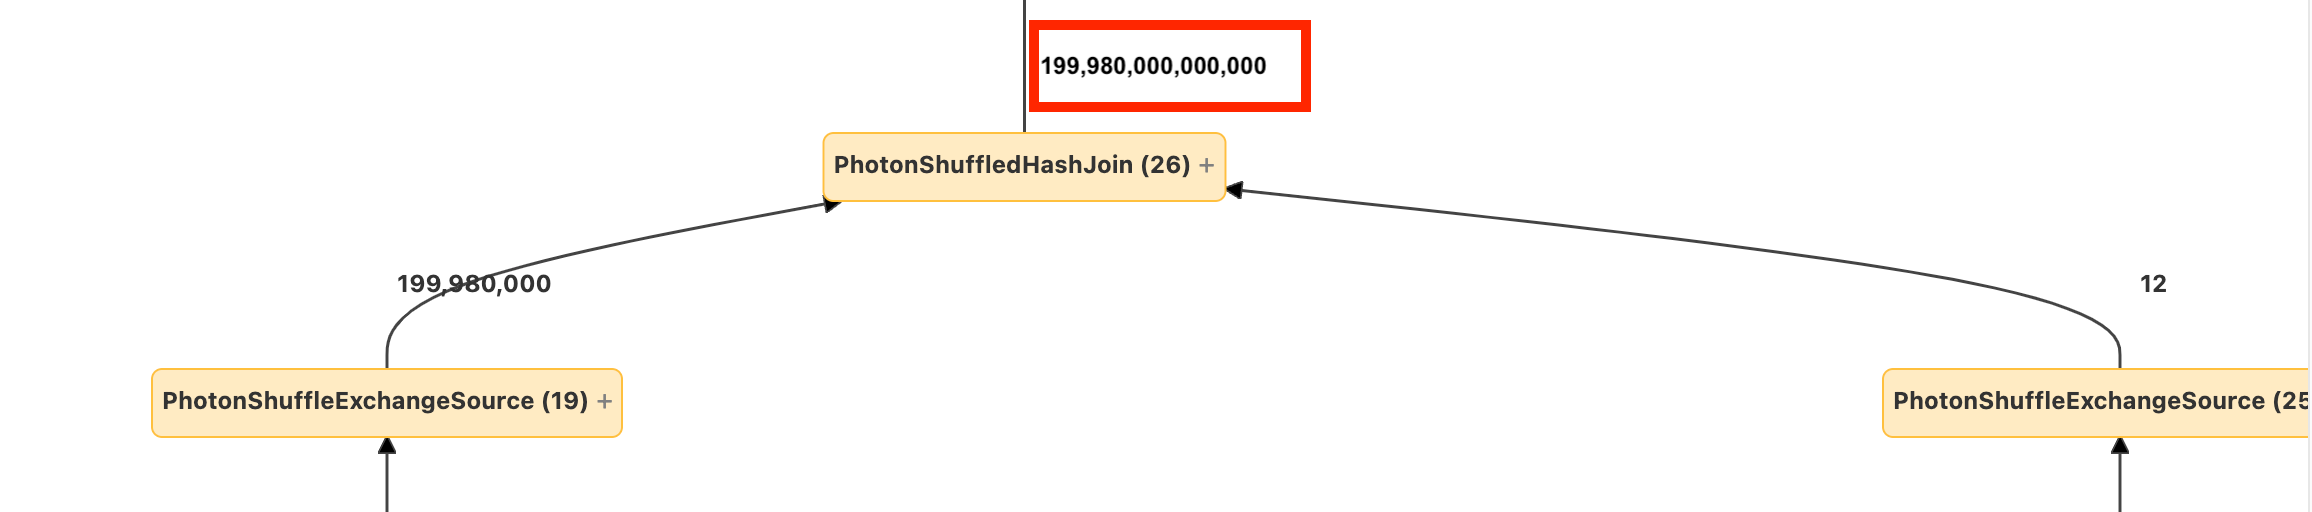
Para corrigir uma explode join, determine qual subconjunto de resultados você precisa e, em seguida, atualize a condição de join ou reduza o número de linhas de entrada de ambas as relações. Veja EXPLODING_JOIN.