Lacunas entre Spark Trabalho
Uma lacuna na linha do tempo de jobs é um período em que nenhum job do Spark está em execução. Durante um intervalo, os workers geralmente estão parados, mas você ainda paga pelo cluster. Se as lacunas representarem uma grande parte do Runtime de uma carga de trabalho, a carga de trabalho levará mais tempo e custará mais do que o trabalho do Spark exige sozinho.
Use esta página quando a linha do tempo dos jobs mostrar lacunas de um minuto ou mais no meio de um pipeline, por exemplo:
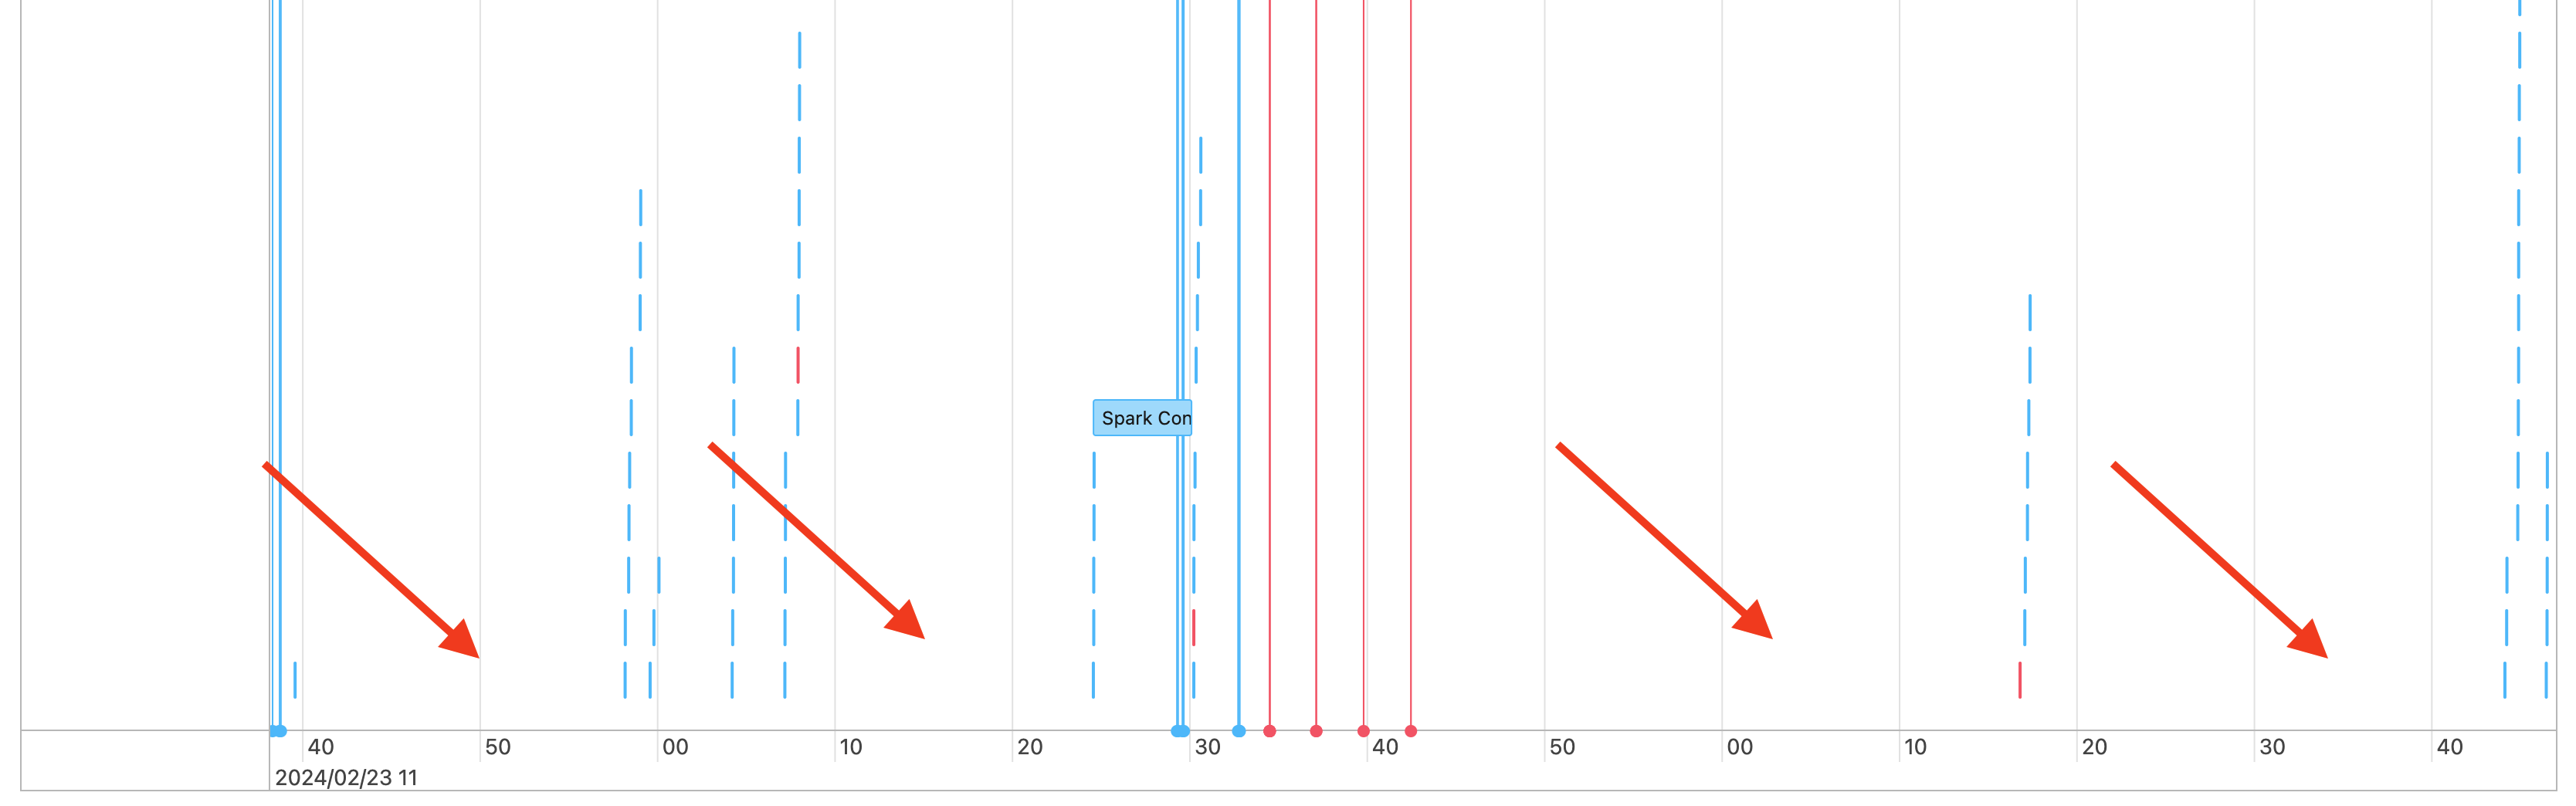
Pequenas lacunas são esperadas enquanto o driver coordena o trabalho. Se a linha do tempo mostrar um padrão diferente, como jobs longos, revise a linha do tempo de jobs para ver outros padrões e use as outras páginas deste guia para diagnosticar o problema. Consulte Diagnosticar problemas de custo e desempenho usando a Spark UI.
Para decidir se as lacunas são esperadas, descubra o que o cluster está fazendo durante elas. As causas mais comuns são:
- Sem trabalho
- Plano de execução complexo
- Execução de código não Spark
- O motorista está sobrecarregado
- o agrupamento não está funcionando corretamente
Sem trabalho
Em compute para todos os fins, as lacunas geralmente significam que o cluster não tem trabalho a fazer. Por exemplo, os usuários enviam query intermitentemente, de modo que o cluster fica parado entre elas. Para reduzir custos, a Databricks recomenda o uso de Serverless compute, onde você não paga pelo tempo parado.
Plano de execução complexo
Um driver pode levar muito tempo para compilar e processar um plano de execução complexo. Nenhuma execução de jobs do Spark ocorre durante esse período, por isso aparece como uma lacuna na linha do tempo dos jobs. Por exemplo, chamar withColumn() em um loop cria um plano muito caro. Para corrigir isso, simplifique o código. Use selectExpr() para combinar várias chamadas withColumn() em uma única expressão ou converta o código para SQL. Você pode incorporar o SQL no código Python e usar as funções de strings do Python para criar a query.
Execução de código não Spark
O código Spark usa SQL ou uma Spark API como PySpark. O código que não usa Spark aparece na linha do tempo como lacunas. Por exemplo, um loop Python que chama funções nativas do Python é executado fora do Spark. Se você não tiver certeza se seu código tem execução Spark, faça a execução interativamente em um Notebooks. Se o código usar Spark, você verá jobs do Spark abaixo da célula:
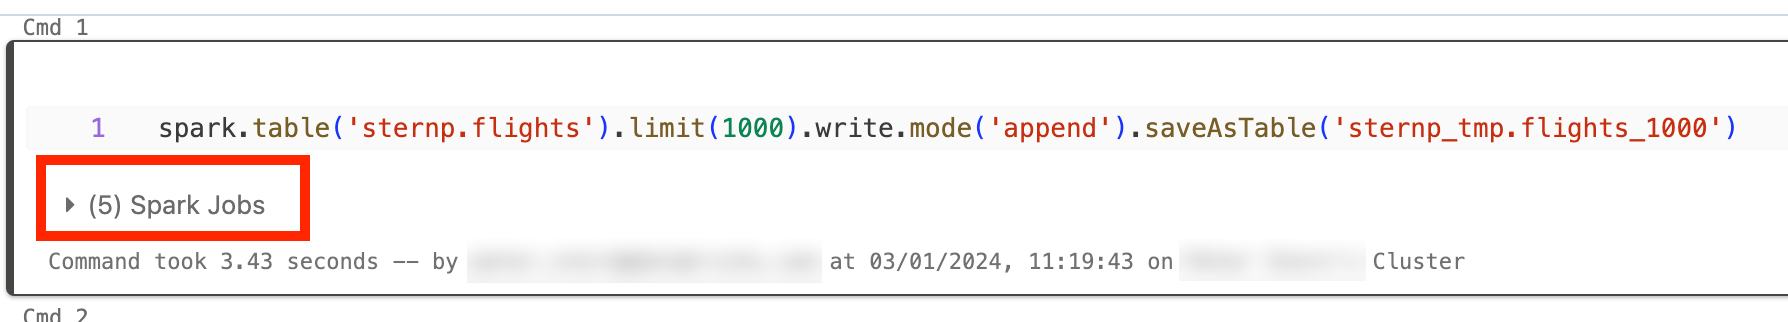
Para verificar se esses jobs ainda estão em execução, expanda o menu suspenso Jobs Spark abaixo da célula. Se o código não usar Spark, a célula não mostra Jobs Spark ou nenhum dos jobs está em execução. Se você não puder execução o código de forma interativa, adicione log ao código e corresponda as lacunas às seções do código por timestamp. Essa abordagem pode ser complicada.
Se a linha do tempo mostrar lacunas da execução de código que não seja do Spark, os worker ficarão parados durante essas lacunas, mas você ainda pagará por eles. Se isso não for intencional, reescreva o código para usar Spark e utilizar totalmente o cluster:
- Se você é novo no Spark, veja Tutorial: Carregar e realizar a transformação de dados usando o Apache Spark DataFrames.
- Se o código usar Python, consulte Noções básicas de PySpark.
- Se o código usar pandas, use a API do pandas no Spark.
Se o código não Spark for necessário, considere o Serverless compute, onde você não paga por tempo parado. Essa abordagem pode reduzir significativamente o custo.
O motorista está sobrecarregado
Para verificar se o driver está sobrecarregado, observe as métricas do cluster. No Databricks Runtime 13.0e acima, clique em Métricas , conforme destacado nesta captura de tela:

Na visualização de distribuição de carga do servidor , verifique se o driver está sobrecarregado. A visualização tem um bloco de cores para cada máquina no cluster. O vermelho indica carga pesada e o azul indica sem carga.
A captura de tela anterior mostra um cluster quase parado. Se o driver estiver sobrecarregado, a visualização será semelhante a esta:

Neste exemplo, um quadrado é vermelho, enquanto os outros são azuis. Passe o mouse sobre o quadrado vermelho para verificar se ele representa o driver.
Para corrigir um driver sobrecarregado, consulte Spark driver overloaded.
o agrupamento não está funcionando corretamente
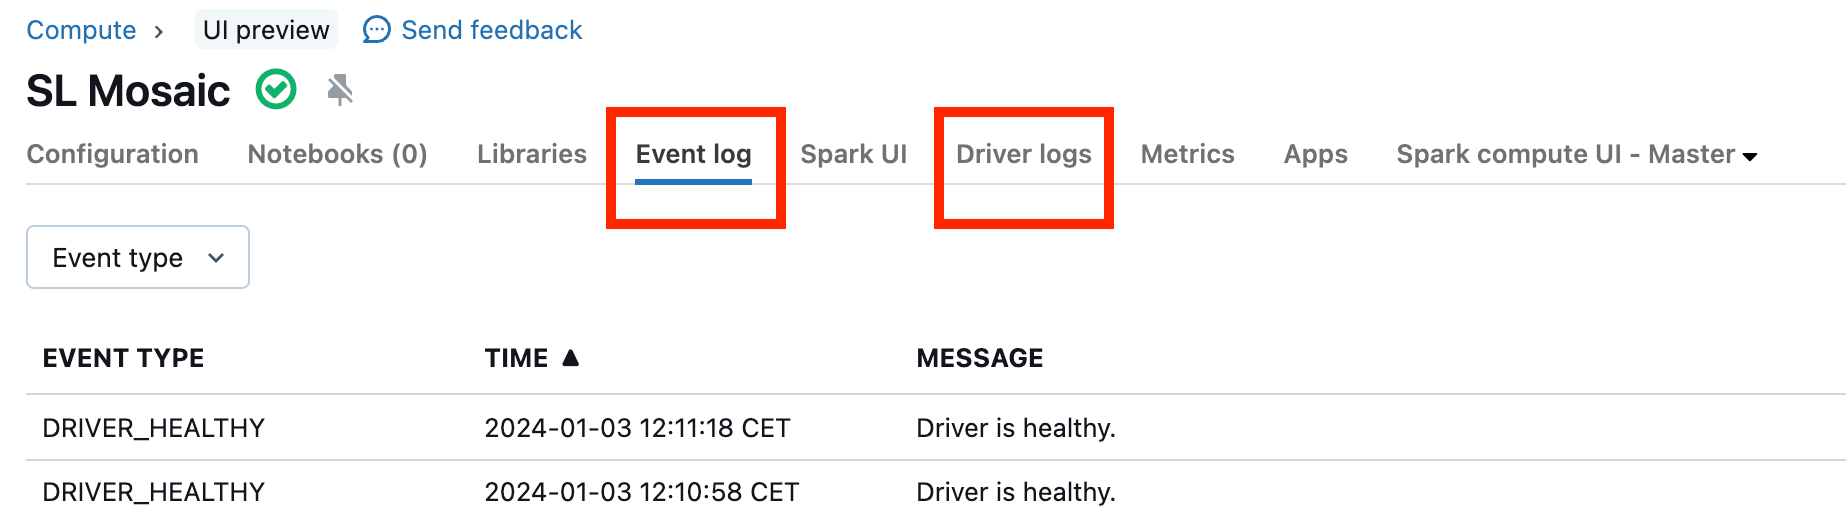
Os clusters raramente apresentam mau funcionamento e, quando isso ocorre, a causa pode ser difícil de encontrar. Reinicie o cluster para ver se isso resolve o problema. Para verificar se há algo suspeito nos Logs, use as tab Event Logs e Driver Logs , destacadas na captura de tela a seguir:
Para acessar os logs do worker, ative a entrega de logs do cluster. Você também pode alterar o nível de log, o que pode exigir ajuda da equipe da sua account do Databricks.