Funções definidas pelo usuário (UDFs) de SQL e Python no Unity Catalog
As funções definidas pelo usuário (UDFs) no Unity Catalog estendem os recursos de SQL e Python no Databricks. Eles permitem que você defina, use e compartilhe e governe com segurança funções personalizadas em ambientes de compute.
As UDFs Python registradas como funções no Unity Catalog diferem em escopo e suporte das UDFs PySpark com escopo para um Notebook ou SparkSession. Consulte funções escalares definidas pelo usuário (UDFs) do Python.
Para registrar UDFs escritas em Scala ou Java no Unity Catalog, consulte funções definidas pelo usuário (UDFs) em Scala e Java no Unity Catalog.
Para ver quais cargas de trabalho e tabelas fazem referência a uma UDF no Unity Catalog antes de modificá-la, consulte Exibir linhagem de UDF.
Consulte CREATE FUNCTION (SQL, Python, Scala e Java) para referência completa da linguagem SQL.
Requisitos
Para usar UDFs no Unity Catalog, o senhor deve atender aos seguintes requisitos:
- Para usar o código Python em UDFs registrados em Unity Catalog, o senhor deve usar um pro SQL warehouse ou um clustering executando Databricks Runtime 14.1 ou acima.
- Para resolver visualizações que foram criadas usando um UDF registrado em Unity Catalog, o senhor deve usar Databricks Runtime 14.1 ou acima. O senhor não pode usar o site SQL warehouse.
- O suporte para instâncias ARM de UDFs Scala em clusters com Unity Catalog habilitado está disponível no Databricks Runtime 15.2 e versões superiores.
UDFs do Python do Unity Catalog escalares e em lotes estão geralmente disponíveis em todos os tipos de compute compatíveis.
Python UDF requisitos de recurso
Os requisitos variam de acordo com o recurso. O Databricks Runtime 19 e a versão de ambiente 6 não são requisitos gerais para UDFs Python do Unity Catalog.
Para UDFs de sessão PySpark em notebooks ou jobs serverless, os requisitos de ambiente referem-se ao ambiente de sessão. Para UDFs Python definidas por SQL, elas se referem a environment_version na cláusula ENVIRONMENT de cada função. A alteração do ambiente de sessão não altera o ambiente de uma função existente do Unity Catalog. Por exemplo, uma sessão que usa a versão de ambiente 6 pode chamar uma função do Unity Catalog definida com a versão de ambiente 5.
Recurso | Requisitos |
|---|---|
Notebooks e jobs serverless; SQL warehouses pro ou serverless; Databricks Runtime 16.2 ou acima em compute clássico. Em compute clássico executando o Databricks Runtime 16.2 a 18.1, | |
Serverless compute; SQL warehouses pro e serverless; Databricks Runtime 16.3 ou acima em classic compute | |
Databricks Runtime 18.1 ou acima em compute clássico. Em compute Serverless e em SQL Warehouse Pro e Serverless, defina explicitamente o | |
Databricks Runtime 18.1 ou acima em compute clássico. No compute Serverless e em SQL warehouses Pro e Serverless, defina explicitamente | |
Credenciais de serviço em um UDF Python do Unity Catalog em lotes | Serverless compute; pro e Serverless SQL warehouses; Databricks Runtime 16.3 ou acima em classic compute. A versão de ambiente 6 não é necessária. Em SQL warehouses serverless, habilite também a Visualização Pública de rede de carga de trabalho isolada. |
Secrets em uma UDF do Python do Unity Catalog escalar ou em lotes | Defina explicitamente |
Comportamento de entrada de | Databricks Runtime 18.1 ou acima em compute clássico. Em compute Serverless e em SQL Warehouse Pro e Serverless, defina explicitamente o |
Mais de cinco chamadas de UDF em uma query | Databricks Runtime 18.1 ou acima no compute clássico. Em compute serverless e em SQL warehouses serverless e pro, defina explicitamente o |
As UDFs existentes e os recursos que estavam disponíveis durante a Visualização pública continuam funcionando nas versões de runtime anteriores aplicáveis.
A versão do ambiente também determina se os chamadores precisam de acesso direto às dependências armazenadas em um volume do Unity Catalog. Consulte Permissões para dependências em volumes do Unity Catalog.
Environment versions on classic compute
Em classic compute, definir environment_version com um valor diferente de 'None' exige Databricks Runtime 18.2 ou acima. Em Databricks Runtime 16.2 a 18.1, defina environment_version = 'None' sempre que você usar a cláusula ENVIRONMENT. O valor 'None' usa o ambiente Python default.
No Databricks Runtime 18.2 ou acima, para obter um comportamento previsível, o Databricks recomenda definir explicitamente um environment_version fixo em cada definição de UDF Python do Unity Catalog. Escolha uma versão que atenda aos requisitos de recurso da UDF e siga estas recomendações de compatibilidade:
Versão do Databricks Runtime | Versão máxima recomendada do ambiente |
|---|---|
18.2 a 18.x | 5 |
19.x | 6 |
Criação de UDFs SQL e Python no Unity Catalog
Para criar uma UDF SQL ou Python no Unity Catalog, os usuários precisam das permissões USAGE e CREATE no esquema e da permissão USAGE no catálogo. Consulte Unity Catalog para obter mais detalhes.
Para executar um UDF, os usuários precisam de permissão EXECUTE no UDF. Os usuários também precisam da permissão de USO no esquema e no catálogo.
Para criar e registrar uma UDF em um esquema do Unity Catalog, o nome da função deve seguir o formato catalog.schema.function_name. Alternativamente, você pode selecionar o catálogo e o esquema corretos no Editor SQL.
Neste caso, o nome da sua função não deve ter catalog.schema anexado a ele:
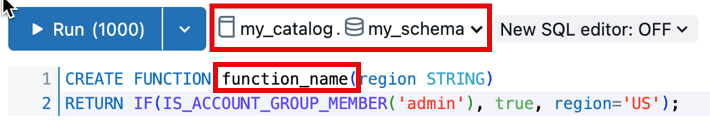
O exemplo a seguir registra uma nova função para o esquema my_schema no catálogo my_catalog:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight DOUBLE, height DOUBLE)
RETURNS DOUBLE
LANGUAGE SQL
RETURN
SELECT weight / (height * height);
UDFs Python para Unity Catalog usam instruções separadas por sinais de dólar duplos ($$). Você deve especificar um mapeamento de tipo de dados. O exemplo a seguir registra uma UDF que calcula o índice de massa corporal:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
return weight_kg / (height_m ** 2)
$$;
Agora o senhor pode usar essa função do Unity Catalog em suas consultas SQL ou no código PySpark:
SELECT person_id, my_catalog.my_schema.calculate_bmi(weight_kg, height_m) AS bmi
FROM person_data;
Consulte Exemplos de filtro de linha e Exemplos de máscara de coluna para obter mais exemplos de UDF.
Usar um manipulador nomeado em uma UDF Python escalar
Em compute clássico, os manipuladores nomeados requerem o Databricks Runtime 18.1 ou acima. Em serverless compute e em SQL Warehouses pro e serverless, defina explicitamente o environment_version do UDF como 6 ou acima. O exemplo a seguir usa a versão de ambiente 6. Em compute clássico executando o Databricks Runtime 18.1, omita a cláusula ENVIRONMENT. Em versões de runtime posteriores, siga as recomendações de compatibilidade se você incluir a cláusula.
Use a cláusula HANDLER para nomear uma função Python no corpo da UDF como o ponto de entrada. O manipulador nomeado aceita os argumentos da UDF e retorna um valor que corresponde ao tipo de retorno declarado. O código fora do manipulador é executado quando cada ambiente Python inicializa a UDF, antes que o manipulador processe as entradas. Use este código para a inicialização única que pode ser reutilizada em chamadas de manipulador.
O exemplo a seguir inicializa greeting_prefix antes de definir greet_handler, a função que lida com as entradas de UDF:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
HANDLER 'greet_handler'
ENVIRONMENT (
  environment_version = '6'
)
AS $$
# Runs once when each Python environment initializes the UDF.
greeting_prefix = "Hello"

def greet_handler(name):
    return f"{greeting_prefix}, {name}!"
$$;
Usar segredos em um UDF Python
UDFs Python do Unity Catalog em lotes e escalares podem acessar segredos declarados na cláusula SECRETS. A definição da UDF deve definir explicitamente environment_version como 6 ou acima. Um segredo do Unity Catalog usa um nome de três partes (catalog.schema.secret) e é diferente de um segredo do Databricks em nível de workspace. Para obter suporte de compute, permissões e a exceção de máscara de coluna de compute dedicado, consulte Requisitos e permissões de UDF.
Para acessar um segredo de uma UDF:
- Adicione o nome de três partes do secret à cláusula
SECRETSna definição da UDF. Uma UDF pode recuperar apenas secrets declarados nesta cláusula. - In the UDF body, call
databricks.secrets.get()with the catalog, schema, and secret name.
O exemplo de UDF escalar a seguir usa um segredo do Unity Catalog como uma key de assinatura de código de autenticação de mensagem baseada em hash (HMAC). Use a mesma cláusula SECRETS com PARAMETER STYLE PANDAS para acessar segredos declarados de um manipulador de UDF em lotes.
CREATE OR REPLACE FUNCTION main.default.sign_value(value STRING)
RETURNS STRING
LANGUAGE PYTHON
SECRETS (main.default.hmac_key)
ENVIRONMENT (
  environment_version = '6'
)
AS $$
import hashlib
import hmac
from databricks.secrets import get

key = get(catalog="main", schema="default", key="hmac_key")
return hmac.new(key.encode(), value.encode(), hashlib.sha256).hexdigest()
$$;
Não retorne valores secretos de uma UDF. A redação de segredos ajuda a reduzir a exposição acidental em erros e logs, mas não impede que o código da UDF exponha material secreto nos resultados da query.
Estenda UDFs usando dependências personalizadas
Você pode estender as capacidades das UDFs Python do Unity Catalog além do ambiente do Databricks Runtime definindo dependências personalizadas para bibliotecas externas.
Requisitos
As dependências personalizadas para os UDFs do site Unity Catalog são compatíveis com os seguintes tipos de compute:
- Notebook e trabalho sem servidor
- compute clássico de uso geral usando Databricks Runtime versão 16.2 e acima
- SQL warehouseprofissional ou serverless
Fontes de dependência
Instale dependências das seguintes fontes:
- PyPI pacote
- Arquivos armazenados em volumes do Unity Catalog Consulte Permissões para dependências em volumes do Unity Catalog.
- Arquivos disponíveis em URLs públicas Suas regras de segurança de rede do workspace devem permitir acesso a URLs públicas. Consulte Requisitos.
Se seu workspace restringir o acesso à rede serverless, você deve configurar regras de segurança de rede para permitir as URLs públicas. Consulte Definir regras de saída.
Permissões para dependências em volumes do Unity Catalog
O criador da função deve ter READ VOLUME em um volume de origem para adicionar uma dependência desse volume a um UDF.
Para uma UDF cuja definição define explicitamente environment_version como 6 ou acima, os chamadores precisam de EXECUTE na UDF, mas não precisam de READ VOLUME no volume de origem. Se a definição da UDF omitir environment_version, definir como None ou definir como uma versão anterior, os chamadores também deverão ter READ VOLUME no volume de origem.
Definir dependências
Use a seção ENVIRONMENT da definição do UDF para especificar as dependências:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mixed_process(data STRING)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["simplejson==3.19.3", "/Volumes/my_catalog/my_schema/my_volume/packages/custom_package-1.0.0.whl", "https://my-bucket.s3.amazonaws.com/packages/special_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]',
  environment_version = '6'
)
AS $$
import simplejson as json
import custom_package
return json.dumps(custom_package.process(data))
$$;
A seção ENVIRONMENT contém os seguintes campos:
campo | Descrição | Tipo | Exemplo de uso |
|---|---|---|---|
| Uma lista de dependências separadas por vírgula a serem instaladas. Cada entrada é uma cadeia de caracteres que está em conformidade com o formato de arquivo de requisitos de pip. |
|
|
| Especifica a versão do ambiente na qual a UDF será executada. Este campo é obrigatório sempre que a cláusula Os valores suportados são uma versão de ambiente 3 ou acima, como On Serverless compute e em SQL Warehouse pro e Serverless, alguns recursos exigem uma versão de ambiente explícita. Defina Para obter detalhes sobre a compatibilidade de versões do compute clássico, consulte Versões de ambiente no compute clássico. Para ver a lista de versões disponíveis, consulte Versões de ambiente. |
|
|
Utilizar UDFs Unity Catalog em PySpark
from pyspark.sql.functions import expr

result = df.withColumn("bmi", expr("my_catalog.my_schema.calculate_bmi(weight_kg, height_m)"))
display(result)
Atualizar um UDF com escopo de sessão
A sintaxe e a semântica dos UDFs Python no Unity Catalog diferem dos UDFs Python registrados no SparkSession. Consulte funções escalares definidas pelo usuário - Python.
Dada a seguinte sessão baseada em UDF em um Databricks Notebook:
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

@udf(StringType())
def greet(name):
    return f"Hello, {name}!"

# Using the session-based UDF
result = df.withColumn("greeting", greet("name"))
result.show()
Para registrar isso como uma função Unity Catalog, use uma instrução SQL CREATE FUNCTION, como no exemplo a seguir:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
AS $$
return f"Hello, {name}!"
$$
Compartilhar UDFs no Unity Catalog
Os controles de acesso aplicados ao catálogo, esquema ou banco de dados onde você registra a UDF gerenciam suas permissões. Consulte Gerenciar privilégios no Unity Catalog para obter mais informações.
Use a interface de usuário Databricks SQL ou Databricks workspace para conceder permissões a um usuário ou grupo (recomendado).
Permissões na interface do usuário workspace
- Localize o catálogo e o esquema em que o UDF está armazenado e selecione o UDF.
- Procure por uma opção de **Permissões** nas configurações da UDF. Adicione usuários ou grupos e especifique o tipo de acesso que eles devem ter, como EXECUTE ou MANAGE.

Permissões usando o Databricks SQL
O exemplo a seguir concede a um usuário a permissão EXECUTE em uma função:
GRANT EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi TO `user@example.com`;
Para remover permissões, use o comando REVOKE como no exemplo a seguir:
REVOKE EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi FROM `user@example.com`;
Isolamento ambiental
Ambientes de isolamento compartilhado requerem Databricks Runtime 18.1 ou acima. Em versões anteriores, todas as UDFs Python do Unity Catalog são executadas no modo de isolamento estrito.
As UDFs Python do Unity Catalog com o mesmo proprietário e sessão podem compartilhar um ambiente de isolamento por default. Isso melhora o desempenho e reduz o uso de memória ao diminuir o número de ambientes separados que precisam ser iniciados.
Isolamento rigoroso
Para verificar se uma UDF sempre é executada em seu próprio ambiente totalmente isolado, adicione a cláusula de característica STRICT ISOLATION.
A maioria das UDFs não precisa de isolamento estrito. As UDFs (Funções Definidas pelo Usuário) de processamento de dados padrão se beneficiam do ambiente de isolamento compartilhado default e são executadas mais rapidamente com menor consumo de memória.
Adicione a cláusula de característica STRICT ISOLATION às UDFs que:
- entrada de execução como código usando
eval(),exec()ou funções semelhantes. - Escrever arquivos no sistema de arquivos local.
- Modificar variáveis globais ou o estado do sistema.
- Acesse ou modifique a variável de ambiente.
O código a seguir mostra um exemplo de uma UDF que deve ser executada usando STRICT ISOLATION. Esta UDF executa código Python arbitrário, portanto, ela pode alterar o estado do sistema, acessar variáveis de ambiente ou escrever no sistema de arquivos local. O uso da cláusula STRICT ISOLATION ajuda a evitar interferência ou vazamento de dados entre UDFs.
CREATE OR REPLACE TEMPORARY FUNCTION run_python_snippet(python_code STRING)
RETURNS STRING
LANGUAGE PYTHON
STRICT ISOLATION
AS $$
import sys
from io import StringIO

# Capture standard output and error streams
captured_output = StringIO()
captured_errors = StringIO()
sys.stdout = captured_output
sys.stderr = captured_errors

try:
    # Execute the user-provided Python code in an empty namespace
    exec(python_code, {})
except SyntaxError:
    # Retry with escaped characters decoded (for cases like "\n")
    def decode_code(raw_code):
        return raw_code.encode('utf-8').decode('unicode_escape')
    python_code = decode_code(python_code)
    exec(python_code, {})

# Return everything printed to stdout and stderr
return captured_output.getvalue() + captured_errors.getvalue()
$$
Defina DETERMINISTIC se sua função produzir resultados consistentes
Adicione DETERMINISTIC à sua definição de função se ela produzir as mesmas saídas para as mesmas entradas. Isso permite otimizações de consulta para melhorar o desempenho.
Por default, o Databricks trata as UDFs Python em lote do Unity Catalog como não determinísticas, a menos que você declare explicitamente o contrário. Exemplos de funções não determinísticas incluem a geração de valores aleatórios, o acesso a horas ou datas atuais, ou a realização de chamadas de API externas.
Consulte CREATE FUNCTION (SQL, Python, Scala e Java)
UDFs para ferramentas de agente
Agentes de AI podem usar UDFs do Unity Catalog como ferramentas para executar tarefas e lógica personalizada.
Consulte Criar ferramentas de agente usando funções do Unity Catalog.
UDFs para acesso a APIs externas
O senhor pode usar UDFs para acessar APIs externas a partir do SQL. O exemplo a seguir usa a biblioteca Python requests para fazer uma solicitação HTTP.
As UDFs Python permitem tráfego de rede TCP/UDP nas portas 80, 443 e 53 ao usar compute serverless ou compute configurada com o modo de acesso padrão.
CREATE FUNCTION my_catalog.my_schema.get_food_calories(food_name STRING)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import requests

api_url = f"https://example-food-api.com/nutrition?food={food_name}"
response = requests.get(api_url)

if response.status_code == 200:
   data = response.json()
   # Assume the API returns a JSON object with a 'calories' field
   calories = data.get('calories', 0)
   return calories
else:
   return None  # API request failed

$$;
UDFs para segurança e compliance
Use UDFs Python para implementar mecanismos personalizados de tokenização, mascaramento de dados, redação de dados ou criptografia.
O exemplo a seguir mascara a identidade de um endereço email, mantendo o comprimento e o domínio:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mask_email(email STRING)
RETURNS STRING
LANGUAGE PYTHON
DETERMINISTIC
AS $$
parts = email.split('@', 1)
if len(parts) == 2:
  username, domain = parts
else:
  return None
masked_username = username[0] + '*' * (len(username) - 2) + username[-1]
return f"{masked_username}@{domain}"
$$
O exemplo a seguir aplica esse UDF em uma definição dinâmica do view:
-- First, create the view
CREATE OR REPLACE VIEW my_catalog.my_schema.masked_customer_view AS
SELECT
  id,
  name,
  my_catalog.my_schema.mask_email(email) AS masked_email
FROM my_catalog.my_schema.customer_data;

-- Now you can query the view
SELECT * FROM my_catalog.my_schema.masked_customer_view;
+---+------------+------------------------+------------------------+
| id|        name|                   email|           masked_email |
+---+------------+------------------------+------------------------+
|  1|    John Doe|   john.doe@example.com |  j*******e@example.com |
|  2| Alice Smith|alice.smith@company.com |a**********h@company.com|
|  3|   Bob Jones|    bob.jones@email.org |   b********s@email.org |
+---+------------+------------------------+------------------------+
Melhores práticas
Para que os UDFs sejam acessíveis a todos os usuários, a Databricks recomenda a criação de um catálogo e um esquema dedicados com controles de acesso apropriados.
Para UDFs específicos da equipe, use um esquema dedicado no catálogo da equipe para armazenamento e gerenciamento.
Databricks recomenda que o senhor inclua as seguintes informações na documentação UDF:
- O número da versão atual
- Um registro de alterações para rastrear as modificações entre as versões
- O objetivo, os parâmetros e o valor de retorno do UDF
- Um exemplo de como usar o UDF
O exemplo a seguir mostra uma UDF que segue as melhores práticas:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
COMMENT "Calculates Body Mass Index (BMI) from weight and height."
LANGUAGE PYTHON
DETERMINISTIC
AS $$
 """
Parameters:
calculate_bmi (version 1.2):
- weight_kg (float): Weight of the individual in kilograms.
- height_m (float): Height of the individual in meters.

Returns:
- float: The calculated BMI.

Example Usage:

SELECT calculate_bmi(weight, height) AS bmi FROM person_data;

Change Log:
- 1.0: Initial version.
- 1.1: Improved error handling for zero or negative height values.
- 1.2: Optimized calculation for performance.

 Note: BMI is calculated as weight in kilograms divided by the square of height in meters.
 """
if height_m <= 0:
 return None  # Avoid division by zero and ensure height is positive
return weight_kg / (height_m ** 2)
$$;
Comportamento de fuso horário de Timestamp para inputs linha por linha
Uma entrada TIMESTAMP chega a um UDF Python linha por linha como um valor datetime sem fuso horário em UTC. Em compute clássico, esse comportamento requer o Databricks Runtime 18.1 ou acima. Em compute serverless e em SQL warehouses serverless e pro, defina explicitamente o environment_version do UDF como 6 ou superior. O objeto datetime não inclui metadados de fuso horário em seu atributo tzinfo.
UDFs Python do Unity Catalog em lotes recebem inputs de timestamp em objetos pandas.Series e não usam este mapeamento datetime.
Essa alteração alinha as UDFs Python do Unity Catalog com as UDFs Python otimizadas para Arrow no Apache Spark.
Por exemplo, a seguinte query define explicitamente a versão do ambiente 6 e o fuso horário da sessão como UTC:
SET TIME ZONE 'UTC';

CREATE FUNCTION timezone_udf(date TIMESTAMP)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  environment_version = '6'
)
AS $$
return f"{type(date)} {date} {date.tzinfo}"
$$;

SELECT timezone_udf(TIMESTAMP '2024-10-23 10:30:00');
O caminho de execução anterior retorna um valor com reconhecimento de fuso horário no fuso horário da sessão. Isso se aplica ao compute clássico antes do Databricks Runtime 18.1. Isso também se aplica ao compute serverless e a SQL warehouses pro e serverless quando você omite a cláusula ENVIRONMENT, define environment_version = 'None' ou seleciona uma versão anterior a 6. Com o fuso horário da sessão definido como UTC, o caminho anterior produz:
<class 'datetime.datetime'> 2024-10-23 10:30:00+00:00 UTC
Com a definição mostrada, o compute Serverless e os SQL Warehouse pro e Serverless usam o comportamento compatível com o PySpark. O compute clássico executando o Databricks Runtime 18.1 ou acima usa o mesmo comportamento quando você ajusta ou omite a cláusula ENVIRONMENT:
<class 'datetime.datetime'> 2024-10-23 10:30:00 None
Esta alteração pode afetar os campos de relógio, bem como tzinfo. Para o instante 2024-10-23T10:30:00Z, o comportamento anterior em uma sessão America/Los_Angeles produz 2024-10-23 03:30:00-07:00. O novo comportamento produz o valor UTC sem fuso horário 2024-10-23 10:30:00.
Se o seu UDF depender de informações de fuso horário, restaure o UTC explicitamente:
from datetime import timezone

date = date.replace(tzinfo=timezone.utc)
A adição de informações de fuso horário UTC não restaura os campos de relógio locais da sessão anteriores. Se sua lógica precisar desses campos, converta também o valor com fuso horário para o fuso horário da sessão pretendida. Por exemplo:
from zoneinfo import ZoneInfo

date = date.astimezone(ZoneInfo("America/Los_Angeles"))
Limitações
- O senhor pode definir qualquer número de funções Python em um UDF Python, mas todas devem retornar um valor escalar.
- Python devem tratar os valores NULL de forma independente, e todos os mapeamentos de tipos devem seguir os mapeamentos da linguagem Databricks SQL.
- Se você não especificar um catálogo ou esquema, o Databricks registrará UDFs do Python no esquema ativo atual.
- As UDFs Python são executadas em um ambiente seguro e isolado e não têm acesso a sistemas de arquivos ou serviços internos.
- Você pode chamar mais de cinco UDFs em uma query em compute clássico executando o Databricks Runtime 18.1 ou acima. Em compute Serverless e em SQL Warehouse Pro e Serverless, cada definição de UDF deve definir explicitamente
environment_versioncomo6ou acima.