Ingest with SQL and Spark APIs
Esta página descreve como ingerir dados no Databricks Lakeflow Connect usando SQL e Spark API, que oferecem níveis mais altos de personalização de pipeline de ingestão em comparação aos conectores gerenciados. Use-o para escolher uma abordagem de ingestão por fonte de dados e nível de personalização do pipeline.
Camadas da pilha ETL
Alguns conectores operam em um nível da pilha de ETL. Por exemplo, o Databricks oferece conectores totalmente gerenciados para aplicativos empresariais como o Salesforce e bancos de dados como o SQL Server. Outros conectores operam em várias camadas da pilha de ETL. Por exemplo, você pode usar SQL e Spark APIs no Structured Streaming para personalização total ou em LakeFlow Pipelines para uma experiência mais gerenciada.
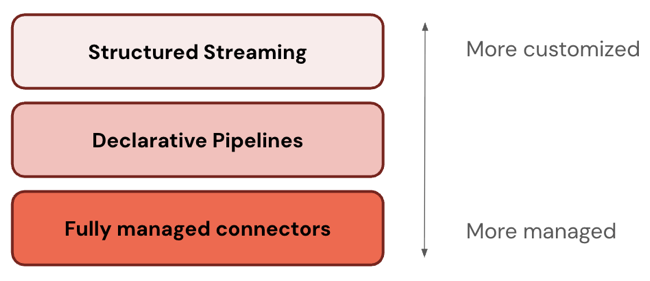
Databricks recomenda começar com a camada mais gerenciável. Se ele não atender aos seus requisitos (por exemplo, se não for compatível com sua fonte de dados), passe para a próxima camada.
A tabela a seguir descreve as três camadas do produto de ingestão, ordenadas da mais personalizável para a mais gerenciável:
Camada | Descrição |
|---|---|
Apache Spark A transmissão estruturada é um mecanismo de transmissão que oferece tolerância a falhas de ponta a ponta com garantias de processamento exatamente único usando Spark APIs. | |
Lakeflow Pipelines estendem o Structured Streaming, oferecendo uma estrutura declarativa para a criação de pipelines de dados. Você pode definir as transformações a serem realizadas em seus dados, e os Lakeflow Pipelines gerenciam a orquestração, o monitoramento, a qualidade dos dados, erros e muito mais. Eles oferecem mais automação e menos sobrecarga do que o Structured Streaming. | |
Conectores totalmente gerenciados se baseiam em Lakeflow pipelines, oferecendo ainda mais automação para as fontes de dados mais populares. Eles estendem a funcionalidade do Lakeflow pipelines para incluir também autenticação específica da fonte, CDC, tratamento de casos extremos, manutenção de API de longo prazo, novas tentativas automatizadas, evolução automatizada do esquema, e assim por diante. Portanto, eles oferecem ainda mais automação para quaisquer fontes de dados compatíveis. |
Escolha uma opção
A tabela a seguir lista as opções de ingestão de SQL e Spark por fonte de dados e nível de personalização do pipeline. Para obter uma experiência de ingestão totalmente automatizada, use conectores gerenciados em vez disso.
Exemplos em SQL para ingestão incremental do armazenamento de objetos na cloud usam a sintaxe CREATE STREAMING TABLE. Ele oferece aos usuários de SQL uma experiência de ingestão escalável, portanto, é a alternativa recomendada a COPY INTO.
Origem | Mais personalização | Alguma personalização | Mais automação |
|---|---|---|---|
Armazenamento de objetos na nuvem | Auto Loader com transmissão estruturada
| Auto Loader com LakeFlow Pipelines
| Auto Loader com Databricks SQL
|
Servidores SFTP | Ingerir arquivos de servidores SFTP (Python, SQL) | N/A | N/A |
Apache Kafka | transmissão estruturada com Kafka source
| Lakeflow Pipelines com origem Kafka
| Databricks SQL com fonte Kafka
|
Google Pub/Sub | transmissão estruturada com fonte Pub/Sub
| Lakeflow Pipelines com origem Pub/Sub
| Databricks SQL com fonte Pub/Sub
|
Apache Pulsar | transmissão estruturada com fonte Pulsar
| LakeFlow Pipelines com fonte Pulsar
| Databricks SQL com fonte Pulsar
|
 Python
Programa de ingestão
O senhor pode configurar o pipeline de ingestão para execução em uma programação recorrente ou contínua.