パイプラインでデータを変換する
パイプラインで変換を宣言し、ストリーム静的結合、増分集計、ストリーミングテーブルとマテリアライズドビューの組み合わせなどの一般的なパターンを使用して、クエリロジックを通じてレコードがどのように処理されるかを指定します。
DataFrame を返す任意のクエリーに対してデータセットを定義できます。Apache Spark の組み込み操作、UDF、カスタムロジック、および MLflow モデルをパイプラインの変換として使用できます。データがパイプラインに取り込まれた後、上流のソースに対して新しいデータセットを定義し、新しいストリーミングテーブル、マテリアライズドビュー、およびビューを作成できます。
ビュー、マテリアライズドビュー、およびストリーミングテーブルのどちらを選択するかについては、「パイプラインとは」を参照してください。パイプラインでステートフル処理を効果的に実行する方法については、「ウォーターマークを使用してステートフル処理を最適化」を参照してください。
ターゲットスキーマからテーブルを除外する
外部での利用を意図しない中間テーブルを計算する必要がある場合、PRIVATEキーワードを使用してスキーマへの公開を防ぐことができます。プライベートテーブルは、パイプラインセマンティクスに従ってデータを格納および処理しますが、現在のパイプラインの外部からアクセスしないでください。プライベートテーブルは、それを作成するパイプラインの有効期間中保持されます。次の構文を使用してプライベートテーブルを宣言します:
- SQL
- Python
CREATE PRIVATE STREAMING TABLE private_table
AS SELECT ... ;
@dp.table(
  private=True)
def private_table():
  return ("...")
ストリーミングテーブルとマテリアライズドビューを単一のパイプラインに結合
ストリーミング テーブルは、 Apache Spark構造化ストリーミングの処理保証を継承し、追加専用のデータ ソースからのクエリを処理するように構成されています。新しい行は変更されるのではなく、常にソース テーブルに挿入されます。
デフォルトでは、ストリーミング テーブルには追加専用のデータ ソースが必要ですが、ストリーミング ソースが更新または削除を必要とする別のストリーミング テーブルである場合は、 skipChangeCommits フラグを使用してこの動作をオーバーライドできます。
一般的なストリーミング パターンでは、ソース データを取り込んでパイプラインの初期データセットを作成します。これらの初期データセットは一般にブロンズ テーブルと呼ばれ、多くの場合、単純な変換を実行します。
対照的に、パイプラインの最終テーブル (一般にゴールド テーブルと呼ばれる) では、複雑な集計やAUTO CDC ... INTO操作のターゲットからの読み取りが必要になることがよくあります。これらの操作は本質的に追加ではなく更新を作成するため、ストリーミング テーブルへの入力としてはサポートされていません。 これらの変換はマテリアライズドビューにより適しています。
ストリーミング テーブルとマテリアライズドビューを 1 つのパイプラインに混在させることで、パイプラインを簡素化し、コストのかかる生データの再取り込みや再処理を回避し、効率的にエンコードおよびフィルター処理されたデータセットに対して複雑な集計を行うための SQL を最大限に活用できます。 次の例は、このタイプの混合処理を示しています。
これらの例では、Auto Loader を使用してクラウド ストレージからファイルを読み込みます。Unity Catalog有効なパイプラインでAuto Loaderを使用してファイルをロードするには、外部ロケーションを使用する必要があります。 パイプラインで Unity Catalog を使用する方法の詳細については、 「パイプラインで Unity Catalog を使用する」を参照してください。
- Python
- SQL
@dp.table
def streaming_bronze():
  return (
    # Since this is a streaming source, this table is incremental.
    spark.readStream.format("cloudFiles")
      .option("cloudFiles.format", "json")
      .load("s3://path/to/raw/data")
  )

@dp.table
def streaming_silver():
  # Since we read the bronze table as a stream, this silver table is also
  # updated incrementally.
  return spark.readStream.table("streaming_bronze").where(...)

@dp.materialized_view
def live_gold():
  # This table will be recomputed completely by reading the whole silver table
  # when it is updated.
  return spark.read.table("streaming_silver").groupBy("user_id").count()
CREATE OR REFRESH STREAMING TABLE streaming_bronze
AS SELECT * FROM STREAM read_files(
  "s3://path/to/raw/data",
  format => "json"
)

CREATE OR REFRESH STREAMING TABLE streaming_silver
AS SELECT * FROM STREAM(streaming_bronze) WHERE...

CREATE OR REFRESH MATERIALIZED VIEW mv_gold
AS SELECT count(*) FROM streaming_silver GROUP BY user_id
Auto Loaderを使用して S3 から JSON ファイルを段階的に取り込む方法の詳細について説明します。
ストリーム静的結合
Stream-static 結合は、主に静的ディメンション テーブルを使用して追加専用データの連続ストリームを非正規化する場合に適しています。
パイプラインが更新されるたびに、ストリームからの新しいレコードが静的テーブルの最新のスナップショットに結合されます。ストリーミング テーブルからの対応するデータが処理された後に静的テーブルでレコードが追加または更新された場合、完全な更新が実行されない限り、結果のレコードは再計算されません。
トリガー実行用に構成されたパイプラインでは、静的テーブルは更新が開始された時点の結果を返します。継続実行用に構成されたパイプラインでは、テーブルが更新を処理するたびに、静的テーブルの最新バージョンがクエリされます。
以下はストリーム静的結合の例です。
- Python
- SQL
@dp.table
def customer_sales():
  return spark.readStream.table("sales").join(spark.read.table("customers"), ["customer_id"], "left")
CREATE OR REFRESH STREAMING TABLE customer_sales
AS SELECT * FROM STREAM(sales)
  LEFT JOIN customers USING (customer_id)
集計を効率的に計算する
ストリーミング テーブルを使用すると、カウント、最小、最大、合計などの単純な分散集計や、平均や標準偏差などの代数集計を段階的に計算できます。 Databricks では、 GROUP BY country句を含むクエリなど、グループの数が限られているクエリに対して増分集計を推奨しています。更新のたびに新しい入力データのみが読み取られます。
増分集計を実行するパイプラインクエリーの作成の詳細については、ウォーターマークを使用したウィンドウ集計の実行を参照してください。
パイプラインでMLflowモデルを使用する
Unity Catalog 有効化パイプラインの Python UDF はパブリックプレビュー段階であるため、それらで MLflow モデルを使用することもパブリックプレビュー段階です。制限事項を参照してください。
MLflowでトレーニングされたモデルをパイプラインで使用できます。MLflowモデルはDatabricksでは変換として扱われます。つまり、Spark DataFrame入力に基づいて動作し、結果をSpark DataFrameとして返します。パイプラインはDataFramesに対してデータセットを定義するため、MLflowを使用するApache Sparkワークロードをわずか数行のコードでパイプラインに変換できます。MLflowの詳細については、Databricks上のMLflowを参照してください。
MLflow モデルを呼び出す Python スクリプトが既にある場合は、 @dp.tableまたは@dp.materialized_viewデコレータを使用し、変換結果を返す関数が定義されていることを確認することで、このコードをパイプラインに適合させることができます。パイプラインはdefaultでMLflowをインストールしないため、MLflow(例: mlflow==2.20.2)をパイプラインの 環境依存関係に追加し、ソースの先頭に mlflowと dpをインポートします。パイプライン構文の概要については、 「Python でパイプライン コードを開発する」を参照してください。
パイプラインでMLflowモデルを使用するには、次のステップを完了します。
- MLflow モデルの実行 ID とモデル名を取得します。実行 ID とモデル名は、MLflow モデルの URI を構築するために使用されます。
- URI を使用して Spark UDF を定義し、MLflow モデルをロードします。
- MLflow モデルを使用するには、テーブル定義で UDF を呼び出します。
次の例は、このパターンの基本的な構文を示しています。
from pyspark import pipelines as dp
import mlflow

run_id= "<mlflow-run-id>"
model_name = "<the-model-name-in-run>"
model_uri = f"runs:/{run_id}/{model_name}"
loaded_model_udf = mlflow.pyfunc.spark_udf(spark, model_uri=model_uri)

@dp.materialized_view
def model_predictions():
  return (
    spark.read.table(<input-data>)
    .withColumn("prediction", loaded_model_udf(<model-features>))
  )
完全な例として、次のコードは、ローン リスク データでトレーニングされた MLflow モデルを読み込むloaded_model_udfという名前の Spark UDF を定義します。予測を行うために使用されるデータ列は、引数として UDF に渡されます。テーブルloan_risk_predictionsは、 loan_risk_input_dataの各行の予測を計算します。
from pyspark import pipelines as dp
import mlflow
from pyspark.sql.functions import struct

run_id = "mlflow_run_id"
model_name = "the_model_name_in_run"
model_uri = f"runs:/{run_id}/{model_name}"
loaded_model_udf = mlflow.pyfunc.spark_udf(spark, model_uri=model_uri)

categoricals = ["term", "home_ownership", "purpose",
  "addr_state","verification_status","application_type"]

numerics = ["loan_amnt", "emp_length", "annual_inc", "dti", "delinq_2yrs",
  "revol_util", "total_acc", "credit_length_in_years"]

features = categoricals + numerics

@dp.materialized_view(
  comment="GBT ML predictions of loan risk",
  table_properties={
    "quality": "gold"
  }
)
def loan_risk_predictions():
  return (
    spark.read.table("loan_risk_input_data")
    .withColumn('predictions', loaded_model_udf(struct(features)))
  )
手動での削除や更新を保持する
パイプラインを使用すると、テーブルからレコードを手動で削除または更新し、ダウンストリームテーブルを再計算するための更新操作を実行できます。
By Default パイプラインは更新されるたびに入力データに基づいてテーブルの結果を再計算するため、削除されたレコードがソース データから再ロードされないようにする必要があります。pipelines.reset.allowed table プロパティを false に設定すると、テーブルへの完全更新は防止されますが、テーブルへの増分書き込みや新しいデータがテーブルに流入するのを防ぐことはできません。
次の図は、2 つのストリーミング テーブルを使用する例を示しています。
raw_user_tableソースから生のユーザーデータを取り込みます。bmi_tableraw_user_tableからの体重と身長を使用して BMI スコアを段階的にコンピュートします。
raw_user_tableからユーザー レコードを手動で削除または更新し、 bmi_tableを再計算します。
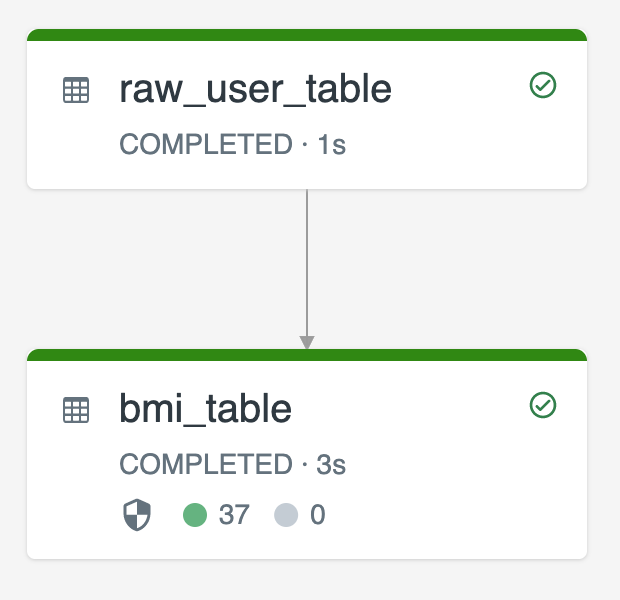
次のコードは、 pipelines.reset.allowedテーブル プロパティをfalseに設定してraw_user_tableの完全更新を無効にし、意図した変更が長期間保持されるようにし、パイプラインの更新が実行されると下流のテーブルが再計算されるようにする方法を示しています。
CREATE OR REFRESH STREAMING TABLE raw_user_table
TBLPROPERTIES(pipelines.reset.allowed = false)
AS SELECT * FROM STREAM read_files("/databricks-datasets/iot-stream/data-user", format => "csv");

CREATE OR REFRESH STREAMING TABLE bmi_table
AS SELECT userid, (weight/2.2) / pow(height*0.0254,2) AS bmi FROM STREAM(raw_user_table);