sparklyr
Databricks は、ノートブック、ジョブ、および RStudio デスクトップで Sparklyr をサポートしています。 この記事では、Sparklyr の使用方法について説明し、実行できるスクリプトの例を示します。 詳細については、「Apache Sparkへの R インターフェイス」を参照してください。
必要条件
Databricks は、 Databricks Runtime リリースごとに Sparklyr の最新の安定版を配布します。 Sparklyr はDatabricks R ノートブック内、またはインストールされているRStudio DatabricksSparklyr のバージョンをインポートすることで でホストされている Server 内で使用できます。
RStudio Desktop では、Databricks Connect を使用して、ローカル マシンから Sparklyr を Databricks クラスターに接続し、Apache Spark コードを実行できます。「Sparklyr と RStudio デスクトップと Databricks Connectの使用」を参照してください。
Sparklyr を Databricks クラスターに接続する
Sparklyr 接続を確立するには、spark_connect()の接続方法として "databricks" を使用できます。するための追加のパラメーターは必要なく、spark_connect() spark_install()SparkDatabricksクラスターに既にインストールされているため、 を呼び出す必要もありません。
# Calling spark_connect() requires the sparklyr package to be loaded first.
library(sparklyr)

# Create a sparklyr connection.
sc <- spark_connect(method = "databricks")
Sparklyrを使用したプログレスバーとSpark UI
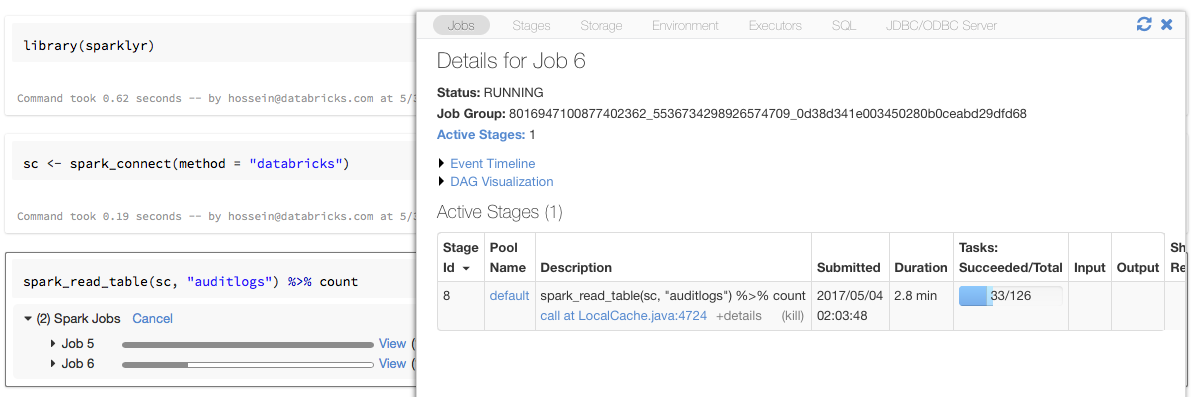
上記の例のように、Sparklyr 接続オブジェクトを sc という名前の変数に割り当てると、次のようになります。
ノートブックには、ジョブをトリガーする各コマンドの後に Spark 進行状況バーが表示されます Spark 。さらに、進行状況バーの横にあるリンクをクリックして、に関連付けられている Spark UI を表示できます
指定された Spark ジョブ。
Sparklyrを使用する
Sparklyr をインストールして接続を確立すると、他のすべての Sparklyr API 通常どおりに機能します。いくつかの例については、 サンプルノートブック を参照してください。
Sparklyrは通常、 dplyr などの他の Tidyverseパッケージ と一緒に使用されます。これらのパッケージのほとんどは、Databricks にプレインストールされているため便利です。 それらをインポートしてAPIの使用を開始するだけです。
Sparklyrと SparkR を一緒に使用する
SparkR と Sparklyr は、1 つのノートブックまたはジョブで一緒に使用できます。Sparklyr と一緒に SparkR をインポートし、その機能を使用できます。Databricks ノートブックでは、SparkR 接続は事前に構成されています。
SparkR の関数の一部は、dplyr のいくつかの関数をマスクします。
> library(SparkR)
The following objects are masked from 'package:dplyr':

arrange, between, coalesce, collect, contains, count, cume_dist,
dense_rank, desc, distinct, explain, filter, first, group_by,
intersect, lag, last, lead, mutate, n, n_distinct, ntile,
percent_rank, rename, row_number, sample_frac, select, sql,
summarize, union
dplyr をインポートした後に SparkR をインポートする場合は、
完全修飾名 ( dplyr::arrange()など) は、.同様に、SparkR の後に dplyr をインポートすると、SparkR の関数は dplyr によってマスクされます。
または、2 つのパッケージのうちの 1 つを、不要なときに選択的にデタッチすることもできます。
detach("package:dplyr")
SparkR と Sparklyr の比較も参照してください。
spark-submit ジョブで Sparklyr を使用する
Spark Submit タスクは非推奨となり、削除されます。現在spark-submitを使用している顧客のみがこのタスクタイプを作成できます。 代わりに、R コードを含むノートブック タスクを使用することもできます。
Databricks で sparklyr を使用するスクリプトを、コードを少し変更して、spark-submit ジョブとして実行できます。 上記の手順の一部は、Databricks のspark-submit ジョブでの sparklyr の使用には適用されません。 特に、 spark_connectに Spark マスター URL を指定する必要があります。 例えば:
library(sparklyr)

sc <- spark_connect(method = "databricks", spark_home = "<spark-home-path>")
...
サポートされていない機能
Databricks は、spark_web() や spark_log() などの Sparklyr メソッドをサポートしていません。
ローカルブラウザ。 しかし、 Spark UI は Databricksに組み込まれているため、 Spark ジョブやログを簡単に検査することができます。コンピュート ドライバーとワーカーのログを参照してください。
ノートブックの例: Sparklyr のデモ
Sparklyr ノートブック
その他の例については、「 R での データフレーム とテーブルの操作」を参照してください。