アダプティブ クエリ実行
アダプティブ クエリ実行 (AQE) は、クエリの実行中に発生するクエリの再最適化です。
クエリーが実行される前に、オプティマイザはデータサイズの推定値に基づいてクエリー実行計画を選択します。テーブル統計が存在しない、最新でない、データがスキューしている、または複雑なクエリーの後のステップの場合、それらの推定値が間違っている可能性があります。間違った推定値に基づいて構築されたプランでは、低速の結合戦略を使用したり、シャッフルの後に過剰な数の小さなタスクを作成したり、ステージ全体を停止させる少数の過大タスクを作成したりする可能性があります。AQE は、クエリーの実行中に実際のデータサイズに基づいてプランを再最適化することで、これらの問題を解決します。
各シャッフルまたはブロードキャスト交換の終了時に、Databricks はこれまでに生成されたデータの正確な統計を持っています。AQE はこれらの統計を使用して、より良い物理的な戦略を選択し、シャッフル後のパーティションの最適な数とサイズを選択するか、スキュー結合処理など、クエリーのヒントを必要とする最適化を適用します。
AQE は default で有効になります。その利点を享受するためにクエリーを変更する必要はありません。低速のクエリーのトラブルシューティングを行う際は、 AQE がクエリープランを変更したかどうかを確認します。default がワークロードに合っていない場合にのみ、 AQE の設定を調整してください。クエリー・プランと構成を参照してください。
資格
AQEには4つの主な機能があります:
- ソート・マージ結合をブロードキャスト・ハッシュ結合に動的に変更します。
- シャッフル交換後にパーティションを動的に合体します (小さなパーティションを適度なサイズのパーティションに結合します)。 非常に小さなタスクは I/O スループットが悪くなり、スケジュールのオーバーヘッドとタスク設定のオーバーヘッドに悩まされる傾向があります。 小さなタスクを組み合わせると、リソースが節約され、クラスターのスループットが向上します。
- ソート、マージ結合、シャッフルハッシュ結合でスキューを動的に処理し、スキューされたタスクをほぼ均等なサイズのタスクに分割(および必要に応じてレプリケート)します。
- クエリーの一部である空のリレーションを動的に検出し、伝播します。これらのリレーションは、行を返しません。
サポートされているクエリー
AQE は、次の両方の条件を満たすクエリーに適用されます:
- クエリーはストリーミングクエリーではありません。
- クエリーには、少なくとも 1 つの交換 (通常は結合、集計、またはウィンドウから) 、少なくとも 1 つのサブクエリ、またはその両方が含まれています。
AQE はサポートされているすべてのクエリーを再最適化しますが、その結果はクエリーが実行される前にオプティマイザがコンパイルした計画と同じになる場合があります。AQE がクエリのプランを変更したかどうかを確認するには、「クエリープラン」を参照してください。
クエリ プラン
AQE が適用されたクエリーには、通常、各メインクエリーまたはサブクエリーのルートノードとして、1 つ以上のAdaptiveSparkPlanノードが含まれています。各AdaptiveSparkPlanノードにはisFinalPlanフラグがあります。このフラグは、クエリー実行前および実行中にはfalseとなり、クエリーが終了するとtrueに変更されます。
クエリープランを表示するには、Spark UI、DataFrame.explain()、またはSQL EXPLAINを使用してください。それぞれに、AQEがプランをどのように変更するかについての異なる情報が表示されます。
Spark UI
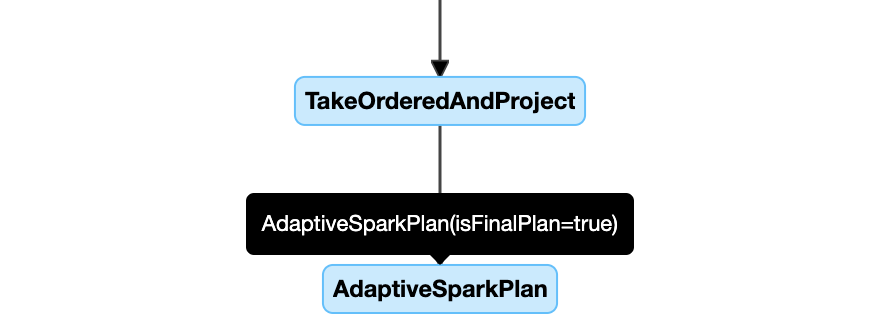
Spark UI のクエリー実行計画ダイアグラムは、最新の計画を示し、クエリーの実行に合わせて更新されます。すでに実行済みでメトリクスがあるノードは変更されません。実行されていないノードは、AQE が計画を再最適化する際に変更される可能性があります。
この例は、クエリープラン図を示しています:
DataFrame.explain()
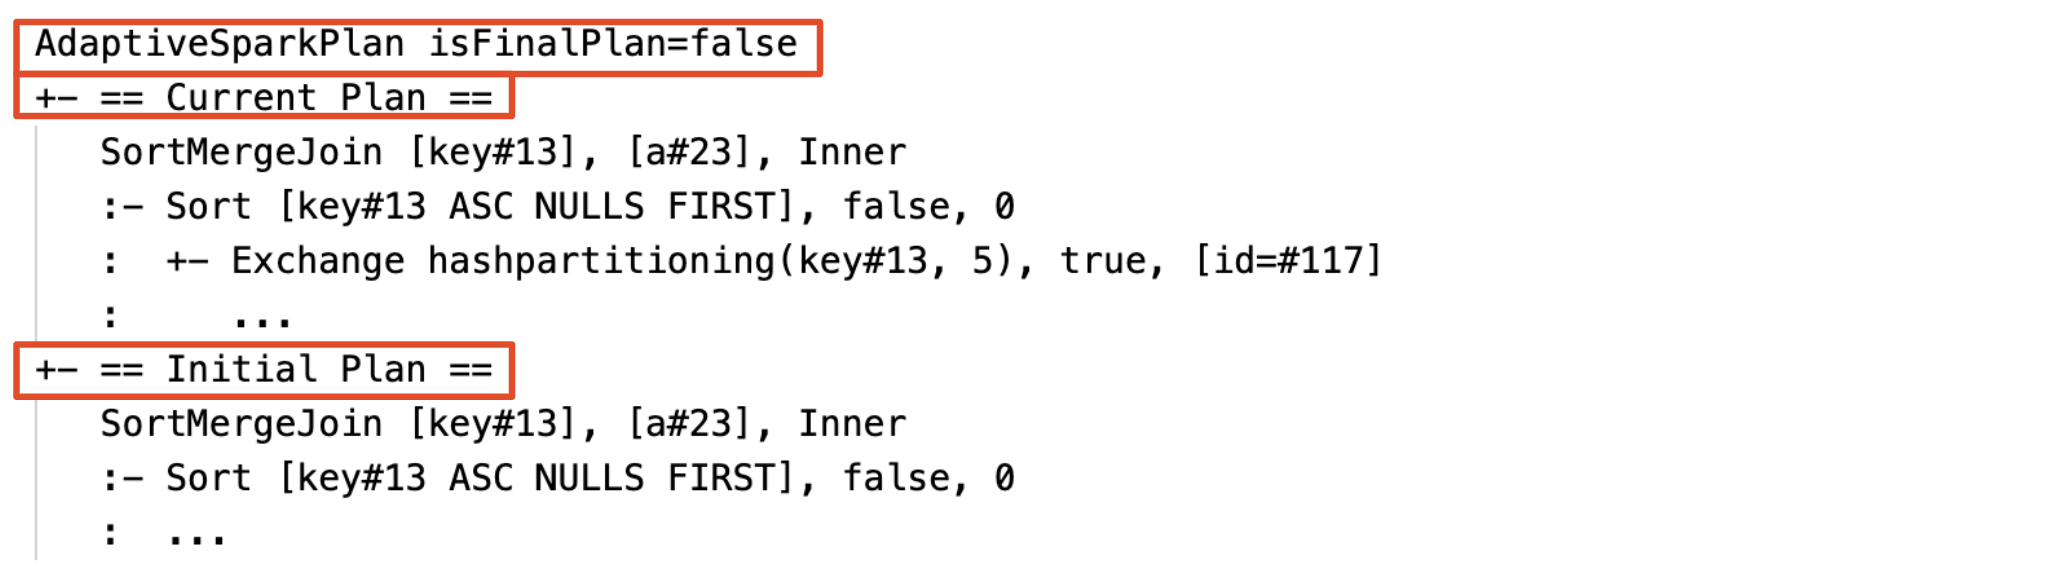
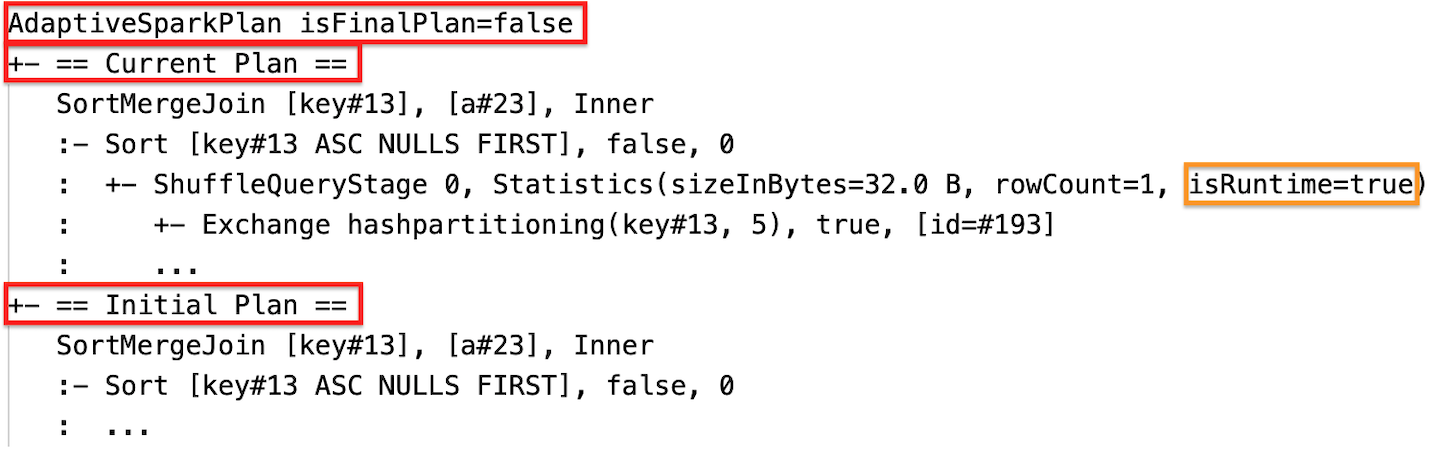
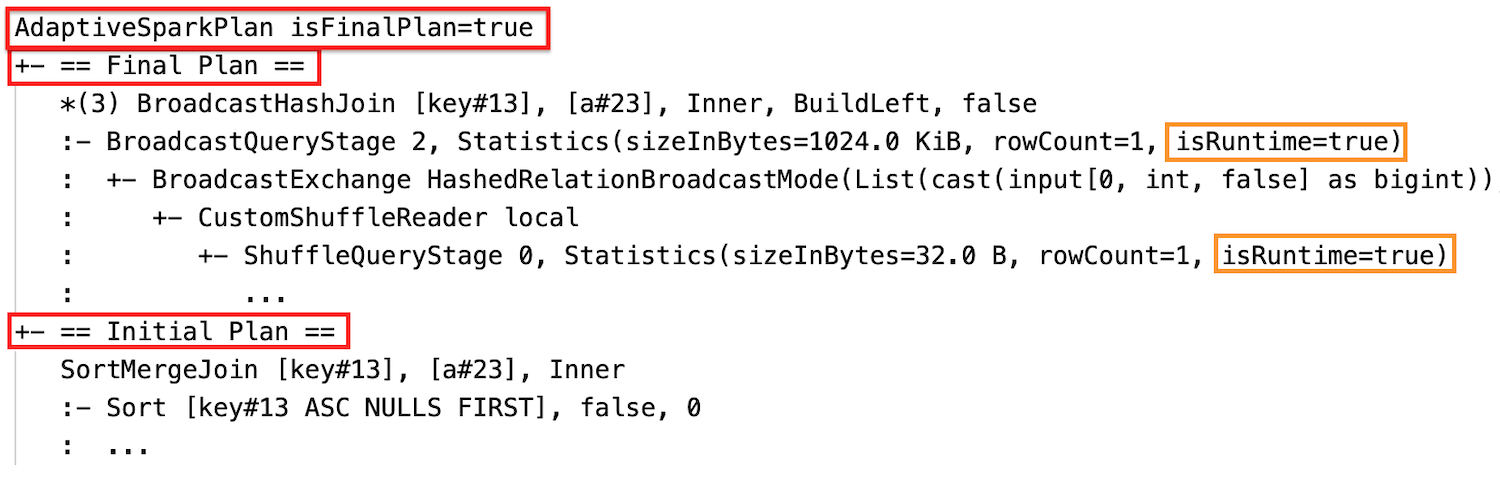
DataFrame.explain() 各 AdaptiveSparkPlan ノードの下に、 AQE が最適化を適用する前の初期プランと現在のプランの 2 つのプランが表示されます。現在のプランはクエリーの実行中に変更され、クエリーが終了すると最終プランになります。
出力には、各シャッフルおよびブロードキャストステージのデータ統計が含まれます。統計は、ステージがランしたかどうかによって異なります。
- ステージのラン前とラン中、
isRuntimeはfalseであり、統計はコンパイル時の推定値です。例:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false)。 - ステージの実行後、
isRuntimeはtrueになり、統計はランタイム測定値になります。たとえばStatistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true)です。
以下のスクリーンショットは、実行前、実行中、実行後の DataFrame.explain() 出力です。
-
実行前
-
実行中
-
実行後
SQL EXPLAIN
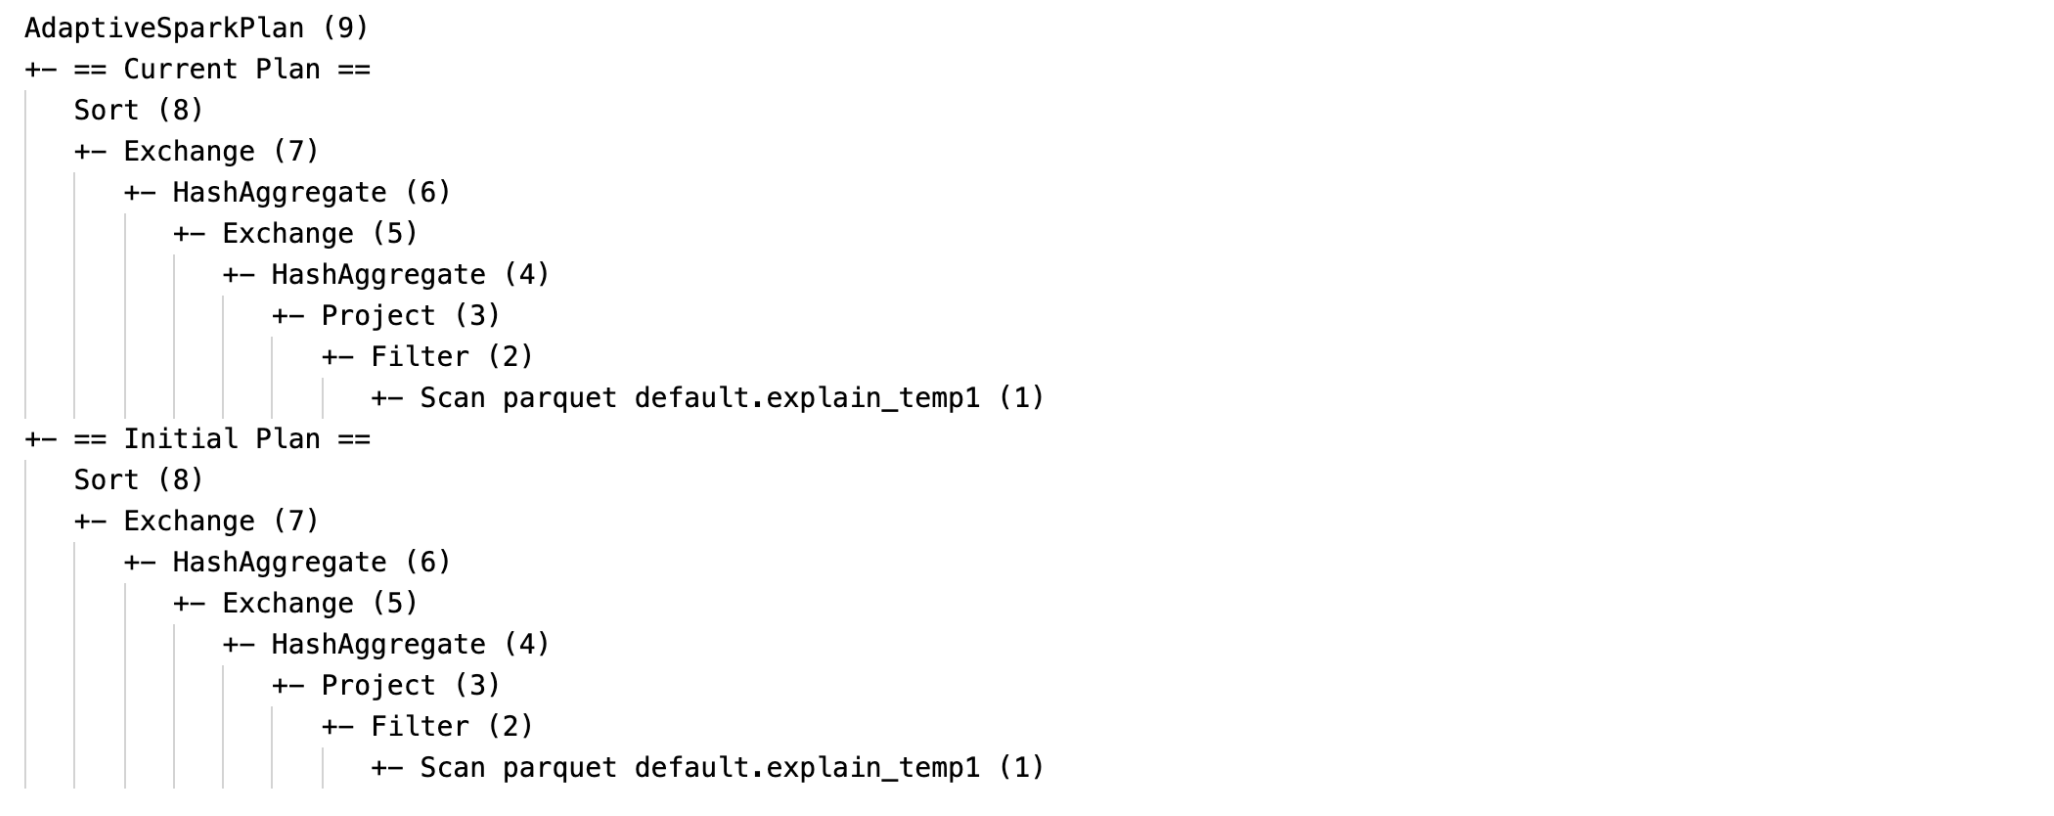
SQL EXPLAIN クエリーを実行しないため、AQEはそれを再最適化できません。出力には初期プランのみが表示されます。これは、AQEが実行するプランとは異なる場合があります。
この例はSQL EXPLAINの出力を示しています:
クエリー実行計画に適用された最適化を特定する
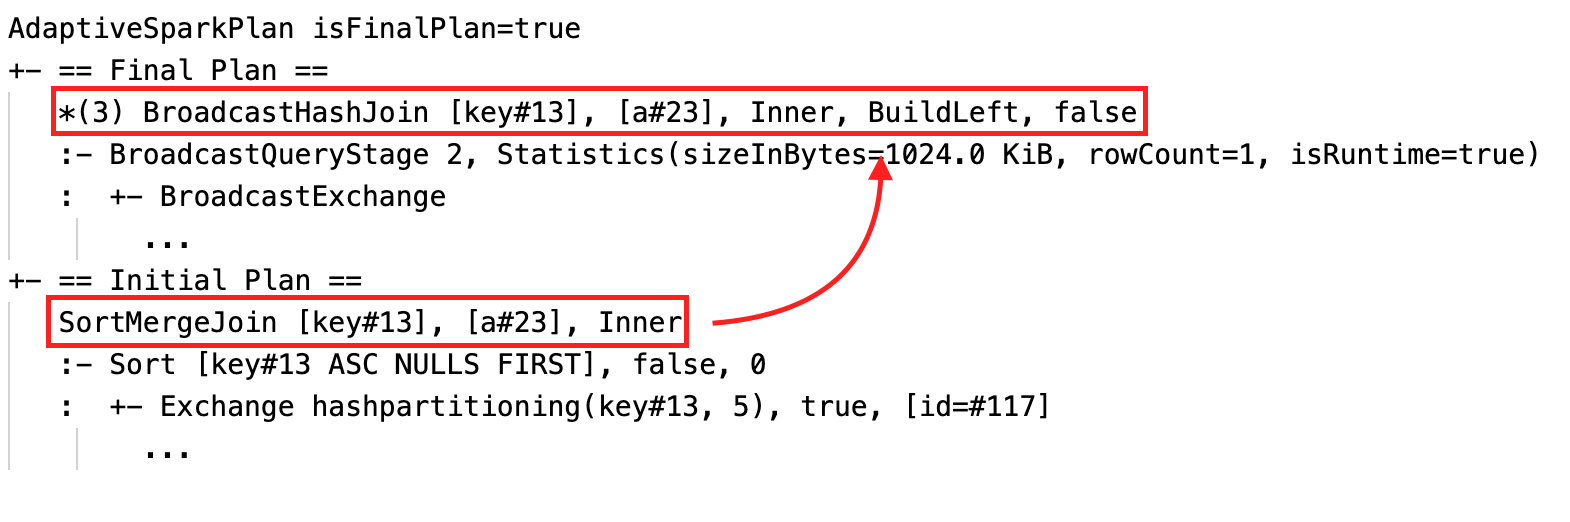
AQEが最適化を適用すると、クエリー・プランが変更されます。どの最適化が有効になったかを確認するには、現在のプランまたは最終的なプランを初期プランと比較します。それぞれの最適化によって、計画は特定の方法で変更されます:
-
結合戦略の変更。 現在または最終的なプランには、初期プランとは異なる物理結合ノードがあります。
-
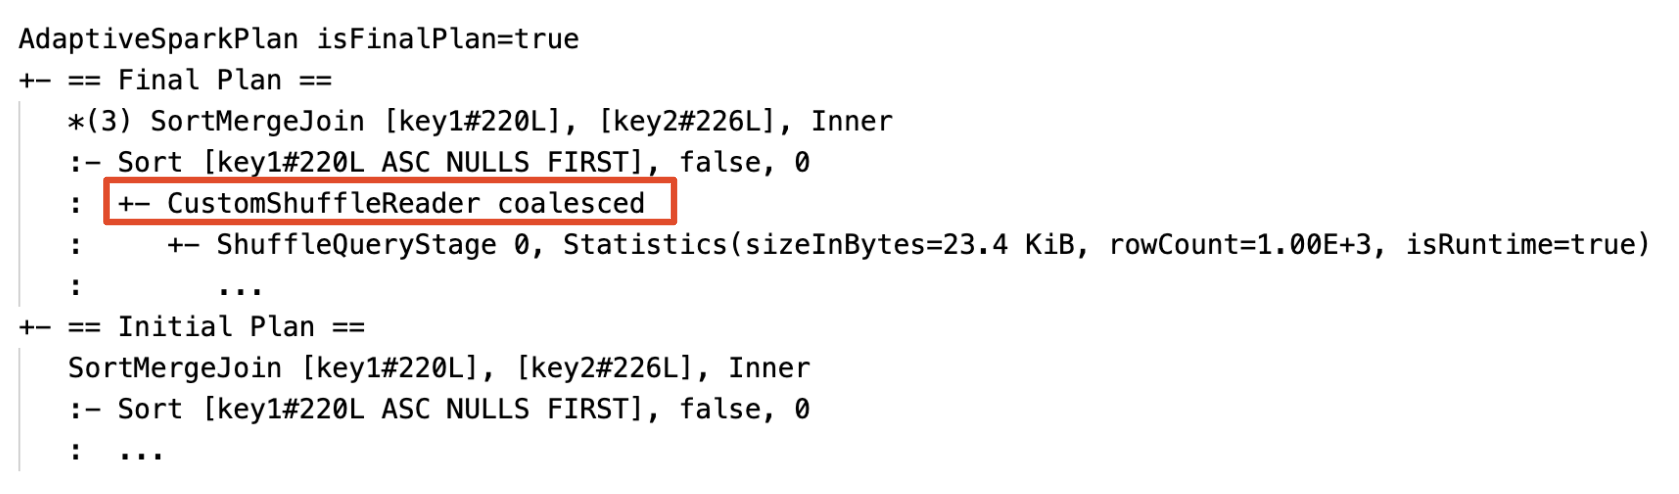
パーティションの合体。 プランには、
Coalescedプロパティを持つCustomShuffleReaderノードが含まれています。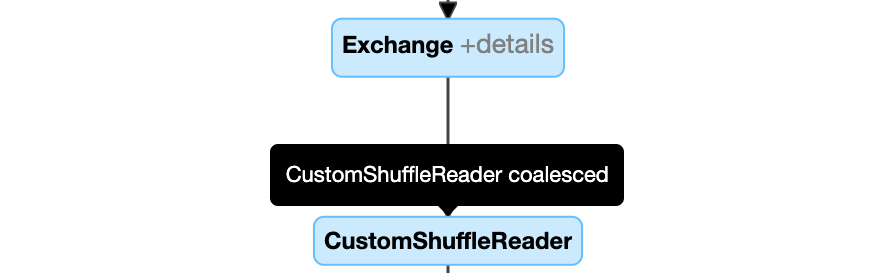
-
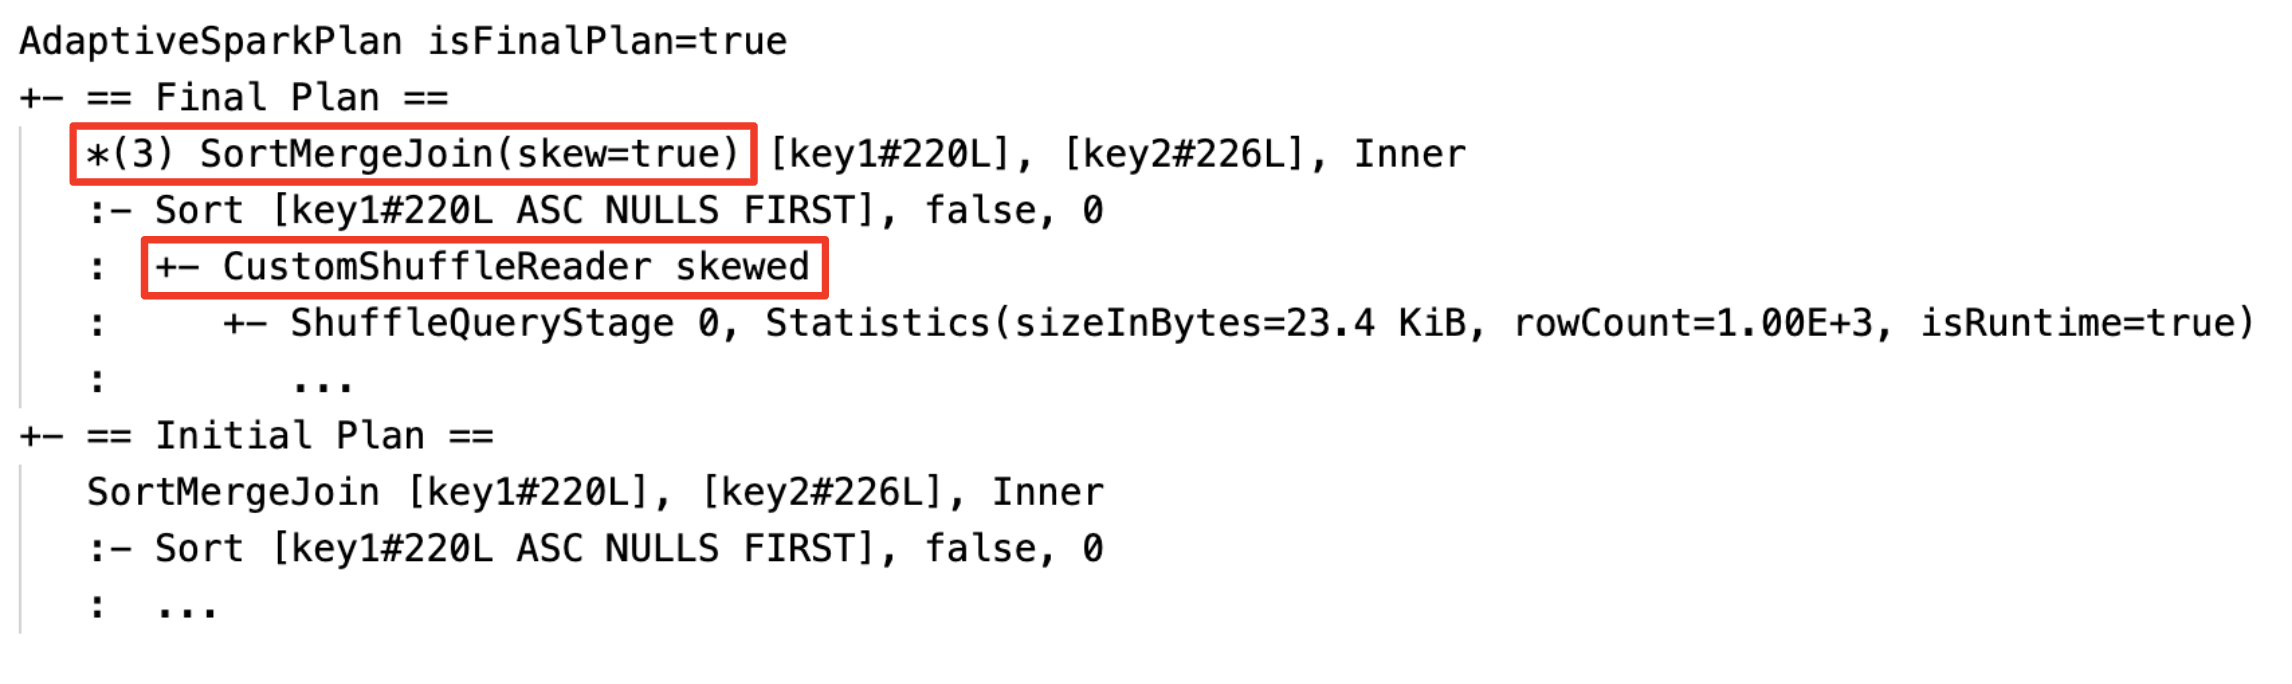
スキュー結合の処理。 プランには、
isSkewフィールドがtrueに設定されたSortMergeJoinノードが含まれています。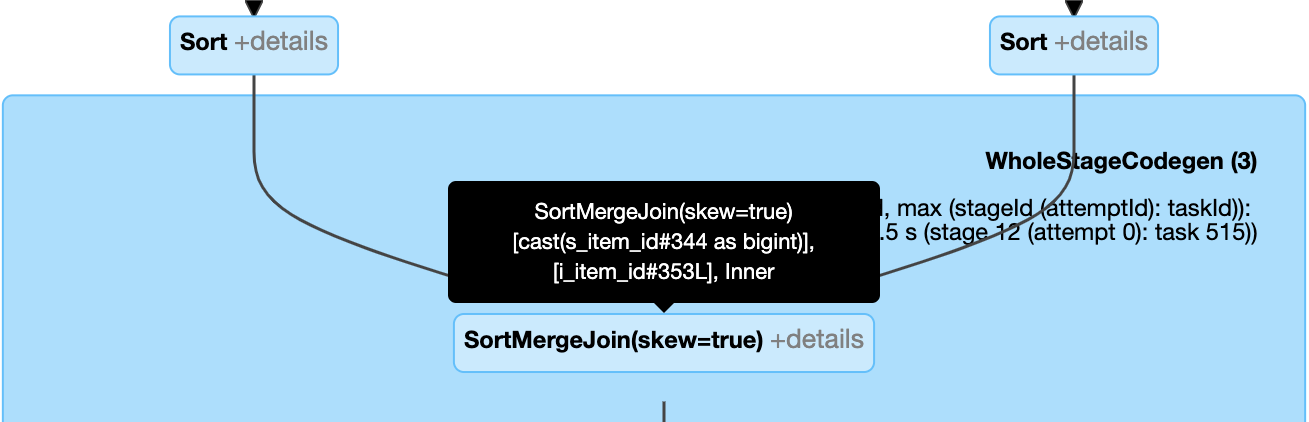
-
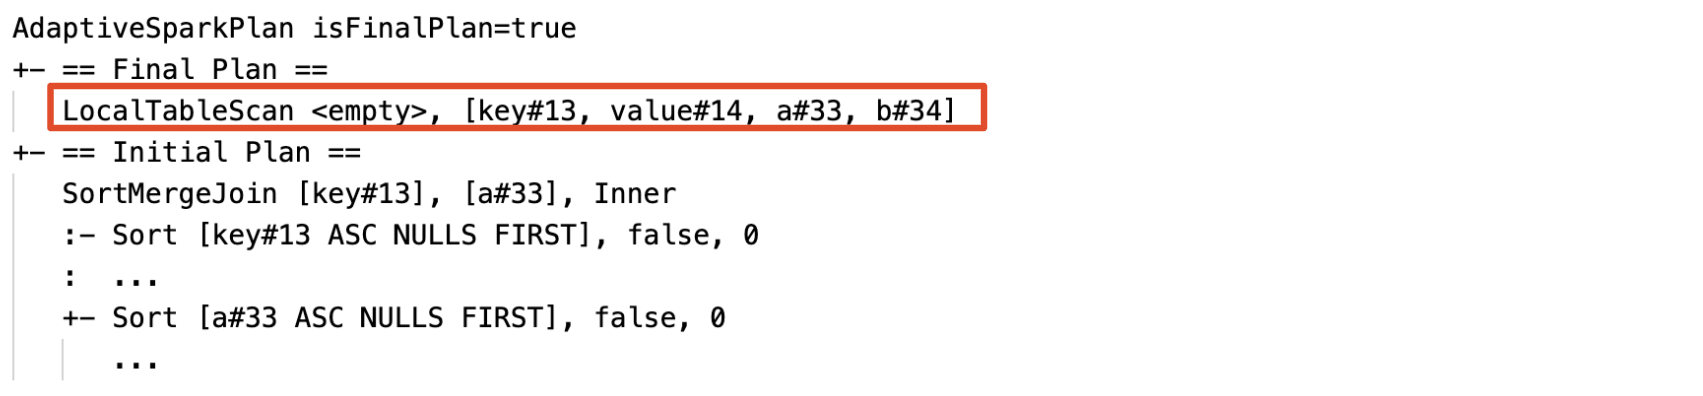
空のリレーションの伝播。 リレーションフィールドが空の
LocalTableScanノードが、プランの一部または全部を置き換えます。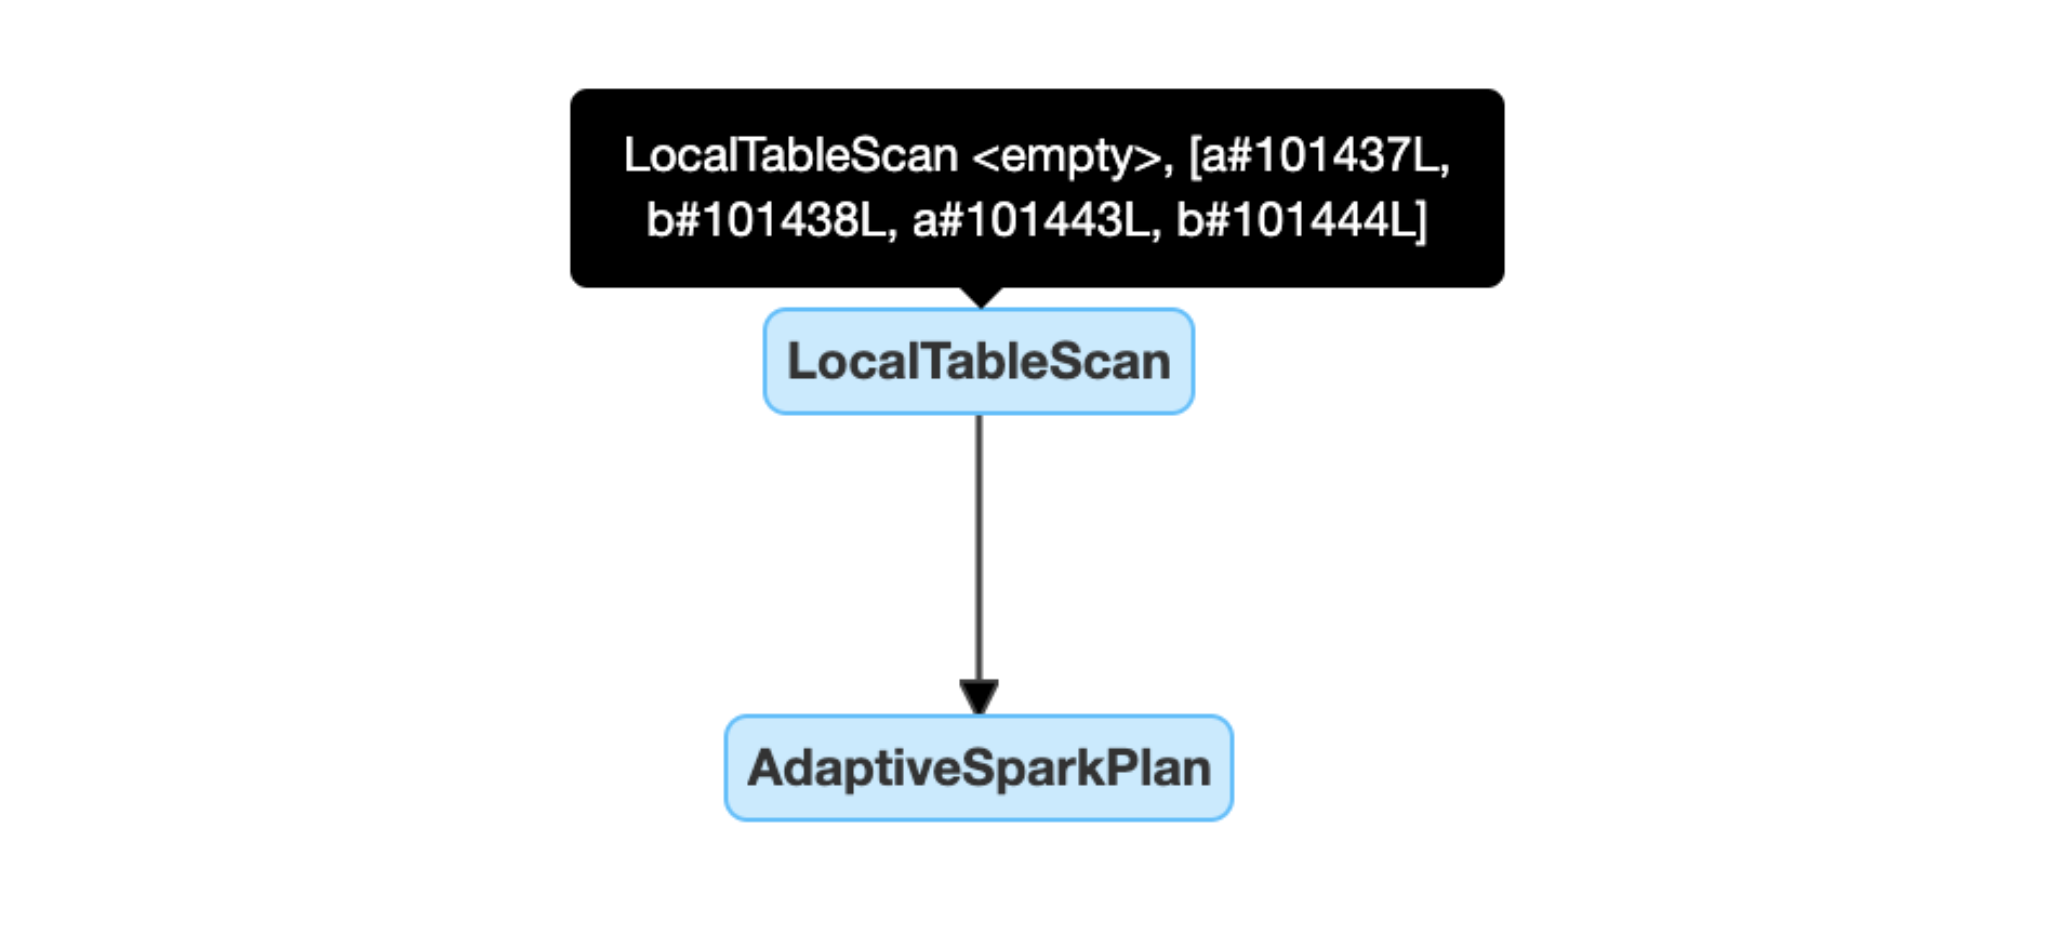
構成
これらの Apache Spark 構成プロパティは、AQE を制御します。ほとんどのワークロードでは、default設定を変更する必要はありません。
AQE を有効にし、個々の最適化を調整する
AQE をオンまたはオフにし、自動最適化されたシャッフル、ブロードキャスト結合の切り替え、および空のリレーションの伝播を調整するには、次のプロパティを使用します。
属性 | Type | デフォルト | 説明 |
|---|---|---|---|
|
|
| 適応型クエリー実行をオンにするかオフにするか。 |
|
|
| 結合または集約のためにデータをシャッフルするときに使用する default のパーティション数。これを 構造化ストリーミングの場合、同じチェックポイント位置からのクエリー再起動の間で、この値を変更することはできません。 |
|
|
| ランタイムにソートMerge結合をブロードキャストハッシュ結合に切り替えるためのサイズthreshold。 |
|
|
| 動的空リレーションの伝播をオンまたはオフにします。 |
パーティションの動的合体
属性 | Type | デフォルト | 説明 |
|---|---|---|---|
|
|
| パーティションの合体をオンにするかオフにするかを切り替えます。 |
|
|
| 結合後のターゲットサイズ。結合されたパーティションは、このサイズに近くなりますが、これを超えることはありません。 |
|
|
| 結合後のパーティションの最小サイズ。合体されたパーティションは、このサイズより小さくありません。 |
|
| クラスターコア数の2倍 | 結合後のパーティションの最小数。このプロパティを設定しないでください。設定すると |
スキュー結合を動的に処理する
属性 | Type | デフォルト | 説明 |
|---|---|---|---|
|
|
| スキュー結合処理のオン/オフを切り替えます。 |
|
|
| パーティションが歪んだとみなされるために超える必要のある中央値パーティションサイズの乗数。 |
|
|
| パーティションが歪んだとみなされるために超える必要のある最小サイズ。 |
AQE は、(partition size > skewedPartitionFactor * median partition size) と (partition size > skewedPartitionThresholdInBytes) の両方の条件が true の場合にのみ、パーティションをスキューしているとみなします。
よくある質問(FAQ)
AQE が小さな結合テーブルをブロードキャストしなかったのはなぜですか?
テーブルが spark.databricks.adaptive.autoBroadcastJoinThreshold より小さいのに AQE がブロードキャストしない場合は、次の原因を確認してください。
- 結合タイプはブロードキャストをサポートしていません。 一部の結合タイプでは、一方の側をブロードキャストできないことがあります。例えば、AQE は
LEFT OUTER JOINの左側をブロードキャストできません。 - テーブルに空のパーティションが多く含まれています。 ソートマージ結合におけるほとんどのタスクは迅速に完了するか、スキュー結合の処理により結合が最適化されます。空でないパーティションの割合が
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin未満の場合、AQE はソートMerge結合をブロードキャストハッシュ結合に変更しません。
AQE が有効な場合でも、ブロードキャスト結合ヒントを使用する必要がありますか?
はい、クエリーをよく理解している場合です。クエリー実行前にオプティマイザが計画するブロードキャスト結合は、通常、ランタイム時に AQE が計画する結合よりもパフォーマンスが向上します。AQE は、結合の両側をシャッフルした後にテーブルの実際のサイズを学習するまで、ブロードキャスト結合に切り替えない可能性があります。
AQEは静的最適化と同じ方法でクエリーヒントを尊重し、ヒントの影響を受けない動的最適化を引き続き適用します。
スキュー結合のヒントを使用すべきか、AQEのスキュー結合処理を使用すべきか?
AQEのスキュー結合処理を使用します。これは自動的に実行され、通常はスキュー結合ヒントよりも優れたパフォーマンスを発揮します。
AQEが結合を並べ替えなかったのはなぜですか?
AQE は、ランタイムに結合を並べ替えません。結合の順序を改善するには、テーブルの統計情報を収集し、コストベースオプティマイザが最適な計画を選択できるようにします。コストベースオプティマイザを参照してください。
AQE でデータ スキューが検出されなかったのはなぜですか?
AQE は、次の両方の条件が真である場合にのみ、パーティションをスキューとみなします。
- パーティションは
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(default256MB)より大きいです。 - パーティションは、メディアンパーティションサイズの
spark.sql.adaptive.skewJoin.skewedPartitionFactor(default5) 倍を超えています。
AQE は、ソートMerge結合やシャッフルハッシュ結合であるシャッフルベースの結合でのみスキューを処理します。ブロードキャスト結合のスキューは決して最適化されません。シャッフルベースの結合では、結合のタイプによって AQE が最適化できる側が決まります。
結合タイプ | 左側でスキュー最適化済み | 右側でスキュー最適化済み |
|---|---|---|
| はい | はい |
| はい | はい |
| はい | No |
| No | はい |
| はい | No |
| はい | No |
| No | No |
遺産
Spark 1.6 に導入された適応型実行は、Spark 3.0 の AQE とは異なる機能です。Spark 1.6 の適応型実行は、パーティションを動的に合体する機能しかありません。AQE は、ランタイムの統計に基づいてクエリーを計画および再計画するフレームワークであり、このページのすべての最適化をサポートしています。