Diagnosticando uma tarefa demorada em Spark
Quando um Job domina o Runtime de uma workload, o tempo geralmente é concentrado em um ou alguns dos estágios desse Job. Encontrar o estágio mais longo e ler sua E/S e contagem de tarefas reduz o problema a uma causa específica, como spill, distorção, alta E/S ou muito pouco paralelismo.
Use esta página depois que a linha do tempo dos jobs mostrar um ou alguns jobs longos, ou depois que você classificar os jobs por duração e abrir o mais longo. Se a linha do tempo mostrar um padrão diferente, consulte a página desse padrão:
Encontrar a etapa mais longa
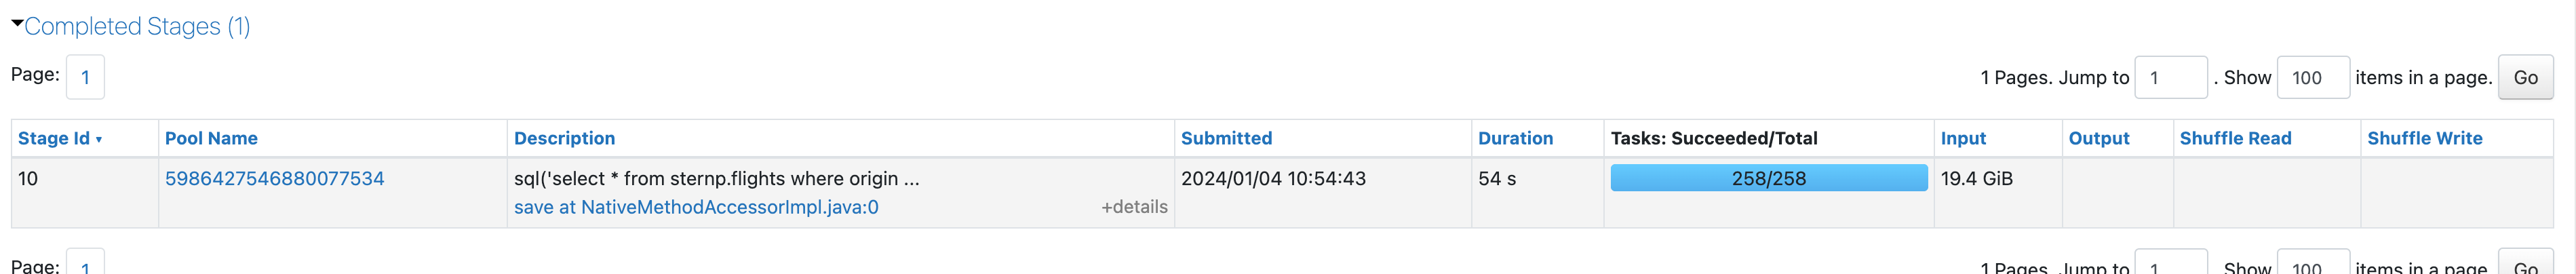
Comece identificando o estágio mais longo do job. Role para a lista de estágios na parte inferior da página do job e ordene-os por duração:
Detalhes do Stage I/O
Analise os dados de I/O de alto nível para este estágio usando as colunas Entrada , Saída , leitura aleatória e gravação aleatória :
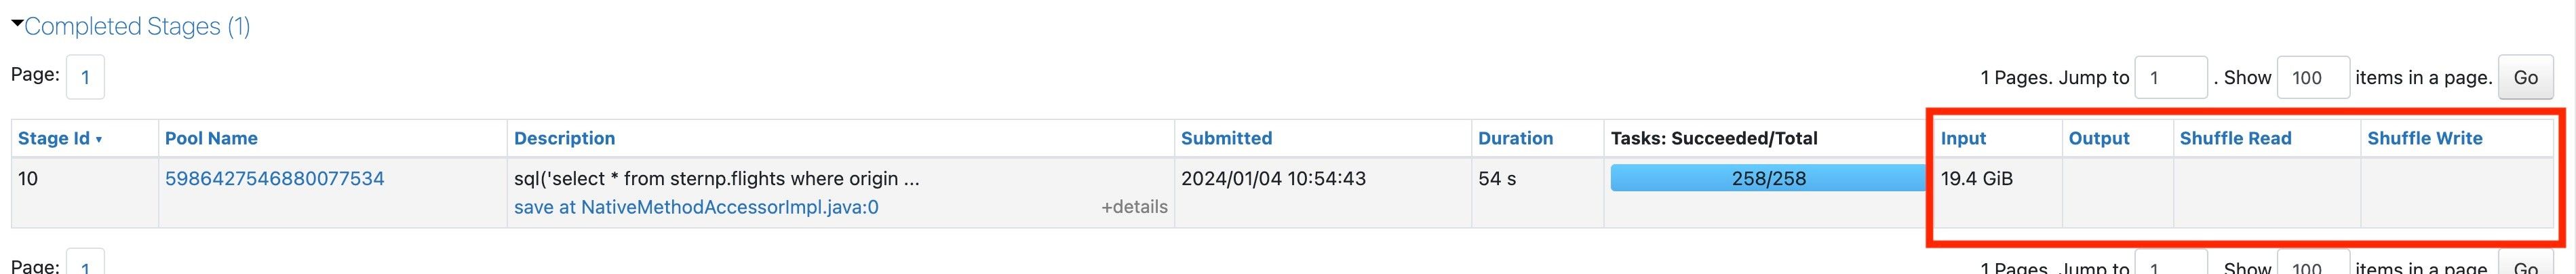
Cada coluna mostra:
- Entrada: quanto dados este estágio leu do armazenamento, como arquivos Delta Lake, Parquet ou CSV.
- Saída: quantos dados esta etapa escreveu para o armazenamento, como arquivos Delta Lake, Parquet ou CSV.
- leitura aleatória: A quantidade de dados embaralhados lidos por esse estágio.
- gravação aleatória: A quantidade de dados aleatórios que este estágio escreveu.
Grave esses números para os passos posteriores.
Número de tarefas
O número de tarefas no estágio longo pode ajudar a identificar a causa. A captura de tela a seguir mostra onde encontrar o número de tarefas:
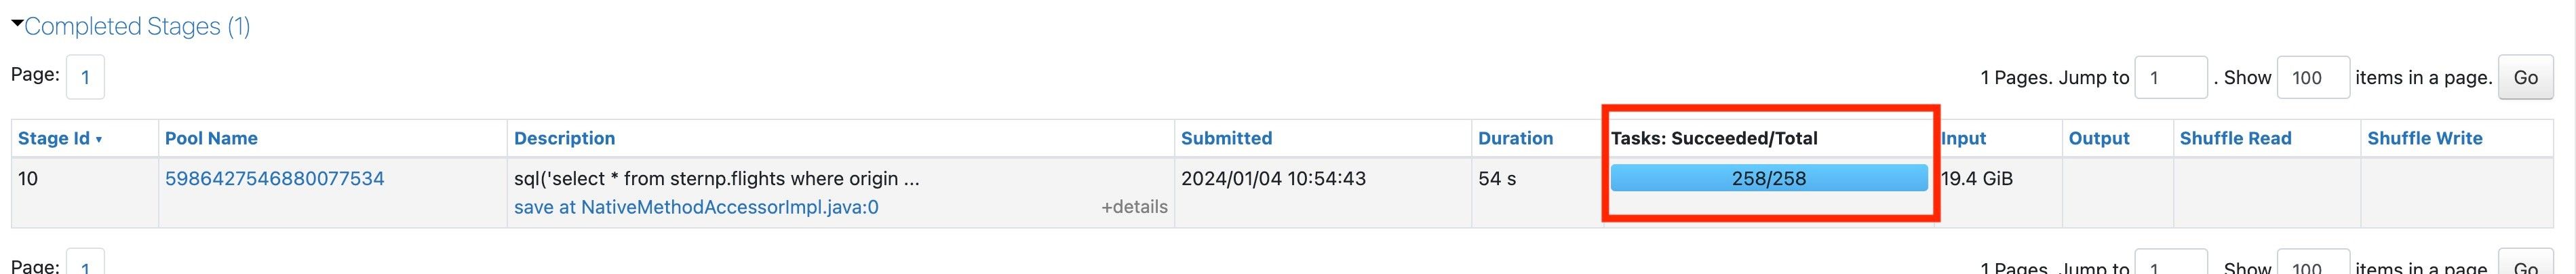
Uma única tarefa significa que o estágio é executado sem paralelismo, portanto, apenas um núcleo faz o trabalho enquanto o restante do cluster aguarda. Se o estágio tiver uma tarefa, consulte Estágio Spark longo com uma tarefa.
veja mais detalhes do palco
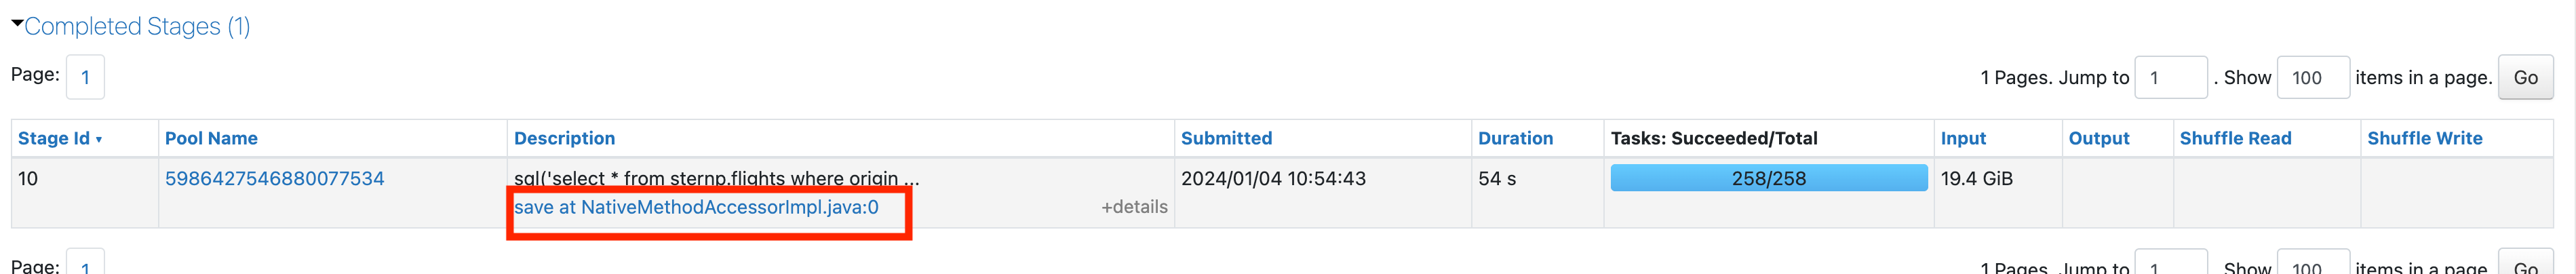
Se o estágio tiver mais de uma tarefa, investigue mais a fundo. Clique no link na descrição do estágio para view detalhes sobre o estágio mais longo:
Em seguida, consulte Assimetria e spill.